Token在暴增,利润为何「困」在英伟达?
Token在暴增,利润为何「困」在英伟达?“芯片的定价权越强,模型和应用公司的成本刚性就越难消解。” 当下,仅豆包一家大模型的日均Token调用量就已突破180万亿;国家数据局的统计显示,全国日均调用量在今年3月已超过140万亿——无论从哪个口径衡量,这都是一条两年内从“近乎为零”飙涨超千倍的曲线。
来自主题: AI资讯
8462 点击 2026-07-20 14:35

 搜索
“芯片的定价权越强,模型和应用公司的成本刚性就越难消解。” 当下,仅豆包一家大模型的日均Token调用量就已突破180万亿;国家数据局的统计显示,全国日均调用量在今年3月已超过140万亿——无论从哪个口径衡量,这都是一条两年内从“近乎为零”飙涨超千倍的曲线。
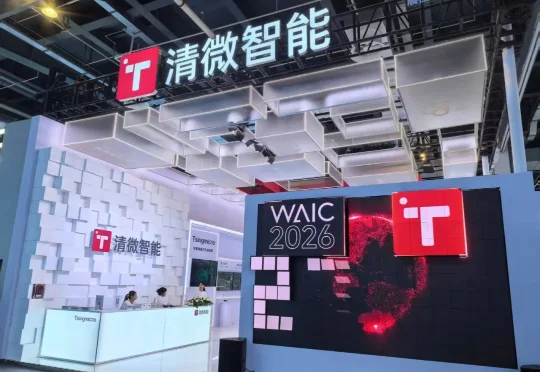
过去,大家围着国产芯片问的是,峰值算力多少?制程多少纳米?和英伟达相比差多少? 走到清微智能的展位前,你会发现一件有意思的事:这里摆的不只是芯片。可重构芯片、4K超节点、RAISA软件栈、行业应用,被放在一起呈现——像是在回答所有国产芯片厂商都绕不开的问题:
时至今日,全球大模型格局已成定数,还有必要耗费巨资从零开始训练一个新模型吗?
2026年中,一家看似处于AI产业链“中游”的公司——景烁科技,在独立运营后,引发了行业热议。
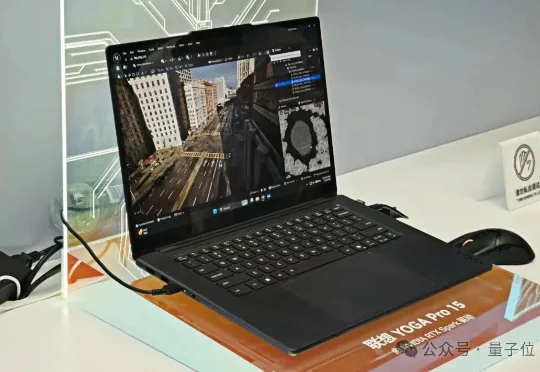
就在这届Bilibili World上,英伟达首次面向大众玩家展示了搭载RTX Spark超级芯片的笔记本电脑。这款芯片专为个人智能体打造,不仅搭载了Blackwell RTX GPU,连CPU也是出自英伟达的Grace CPU。
如果要在全球市场上找一个交易标的,能最纯粹地表达“AI替代人类白领”这个叙事,答案既在纳斯达克的多头名单里,也在孟买交易所的空头名单上。前者是英伟达,后者是印度Nifty IT指数。
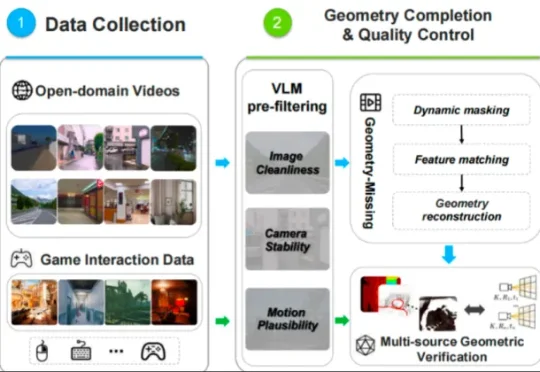
专注于4D世界模型研发和产业化的魔芯科技联合浙江大学潘云鹤院士团队发布MoWorld——全球首个Flash World Model,也是首个全栈基于国产NPU构建的实时交互世界模型。
今天,据路透社报道,三位知情人士透露,DeepSeek正在自研AI推理芯片,以减少对英伟达以及华为芯片的依赖。知情人士称,DeepSeek自研芯片的工作大约在一年前启动,其研发仍处于早期阶段。目前,DeepSeek正在接触外部合作伙伴,并与芯片设计企业、晶圆代工厂以及存储企业展开讨论。

GPT-5.6 Sol预览版发布小半个月了,首批用户内测报告终于新鲜出炉!英伟达首席工程师用最直白最不绕弯子的话告诉你:Sol很猛!30小时,就跑赢了Opus 64小时才达到的CUDA加速效果。后续版本优化后,或将彻底碾压Opus……
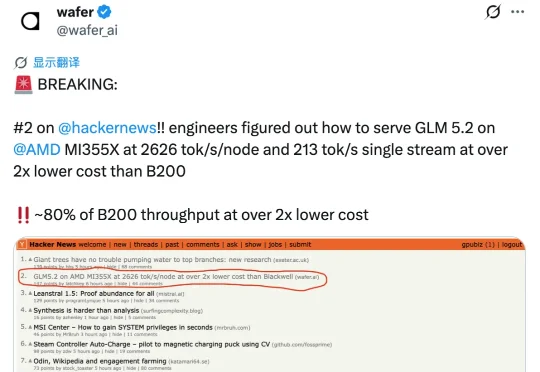
GLM 5.2,用AMD芯片也能跑出来了,而且成本只要英伟达的一半。这是推理优化公司Wafer这周公布的一组数据。Wafer用AMD的MI355X芯片跑最新开源模型GLM 5.2,单节点吞吐做到2626 tok/s,单流吞吐也跑到了213 tok/s。