估值一年翻倍!美国AI智能体公司LangChain完成3亿美元C轮融资
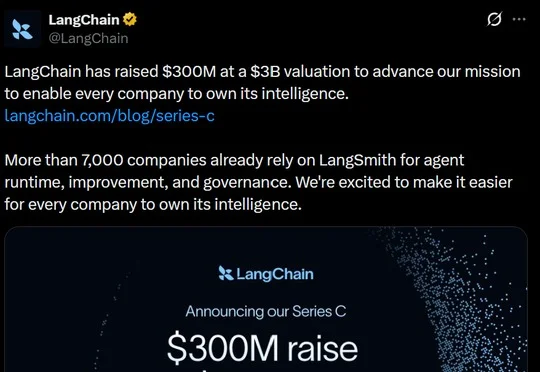
估值一年翻倍!美国AI智能体公司LangChain完成3亿美元C轮融资美国AI智能体公司LangChain完成3亿美元C轮融资,投后估值达30亿美元,较一年前翻倍多,本轮由CapitalG领投。
来自主题:
AI资讯
8529 点击 2026-11-17 18:24

 搜索
美国AI智能体公司LangChain完成3亿美元C轮融资,投后估值达30亿美元,较一年前翻倍多,本轮由CapitalG领投。
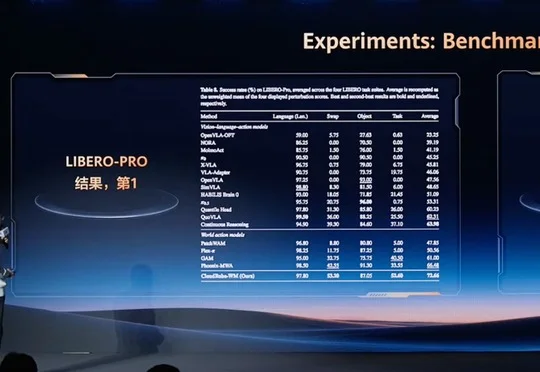
华为云推出首款昇腾原生具身世界模型CloudRobo-WM1.2,宣布11月30日开放模型权重、推理后训练代码及预训练最佳实践,并在RoboTwin 2.0、LiberoPro 2.0评测中均位列第一。
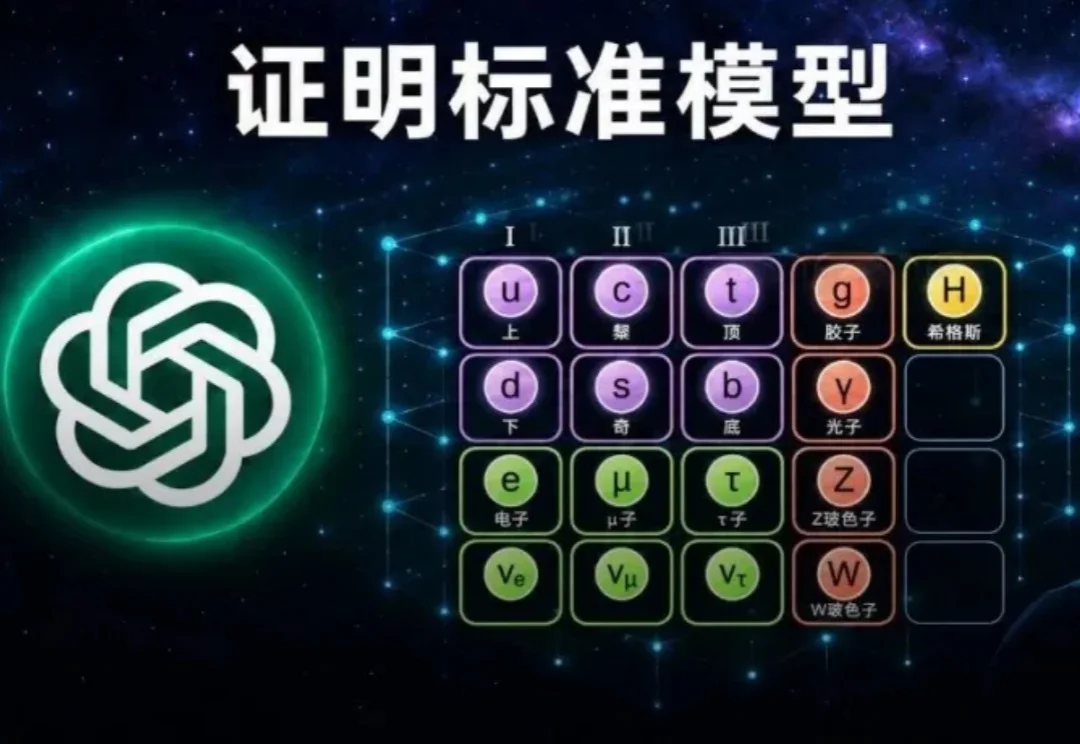
刚刚,OpenAI「补全」了粒子物理标准模型?
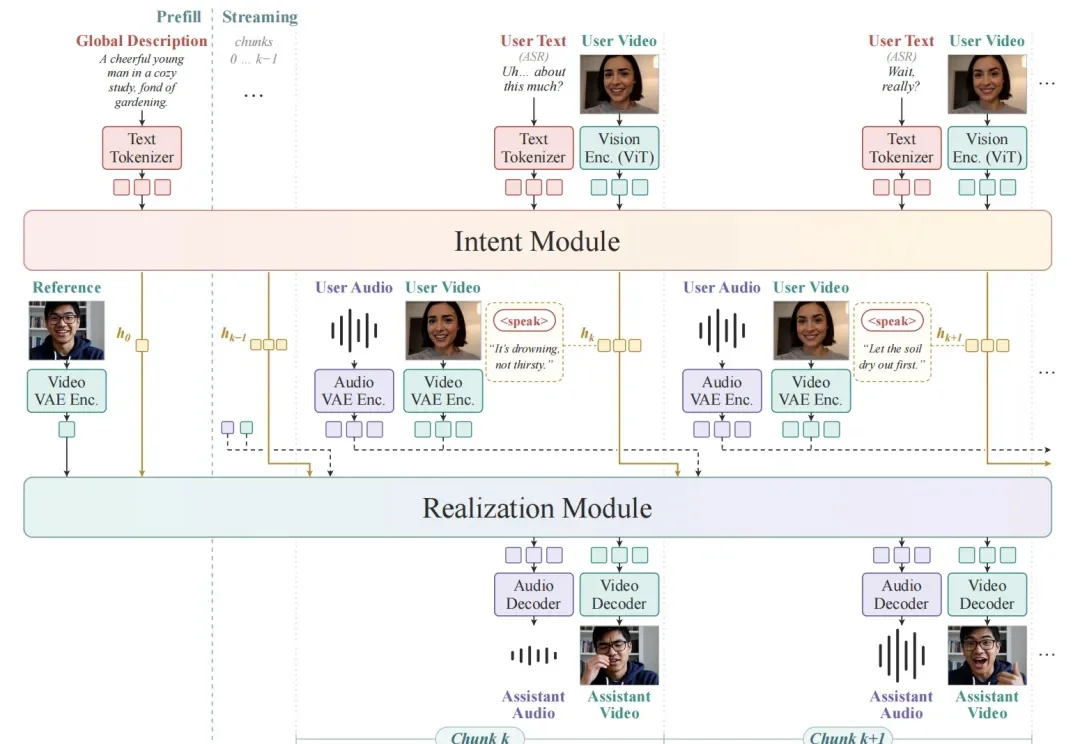
想象一下,你在现实中拿起一瓶水,递向屏幕。下一秒,屏幕里的虚拟人物竟然伸出手,接过了这瓶水。
近日,无锡途深智合人工智能科技有限公司(以下简称 “途深智合”)连续完成两轮合计数亿元 Pre-A 轮及 Pre-A+ 轮融资。Pre-A 轮融资由上海科创集团领投、中生引领、舟山途毅等机构共同投资;Pre-A+ 轮融资由金鼎资本、镁伽科技、清科控股等机构联合投资。凯乘资本担任长期独家财务顾问。
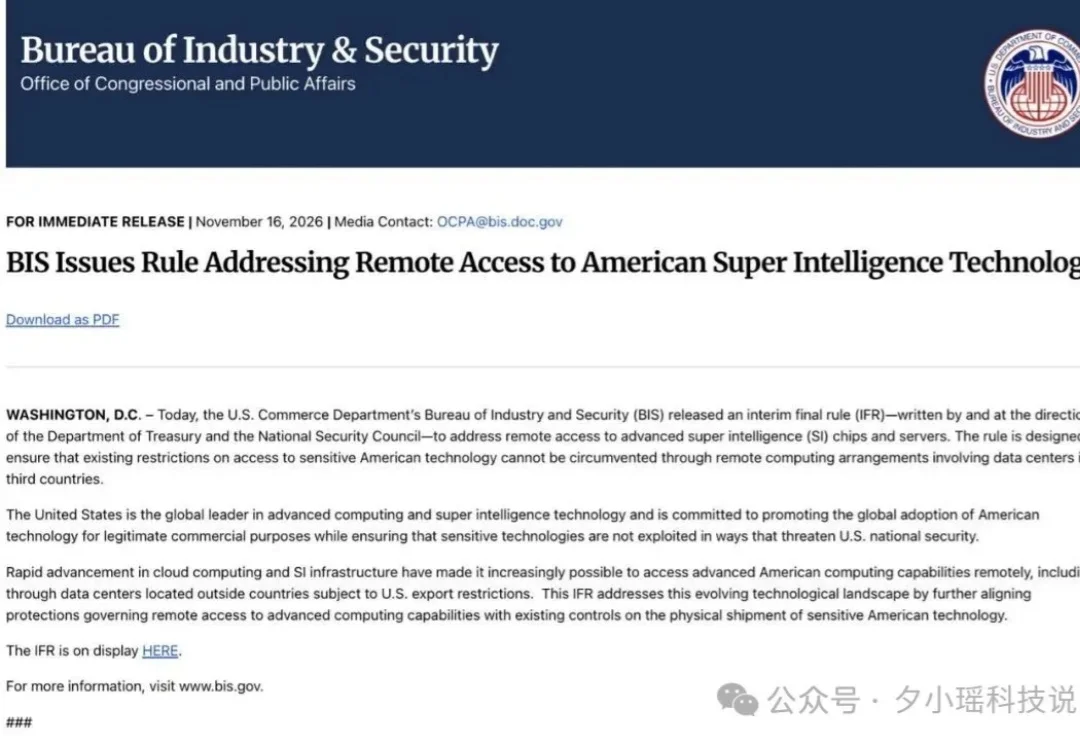
英伟达风波未平,海外租卡也要被限制了。
10 月底,我们把 Founder Show 又带回了新加坡。
香港AI投研平台ARTi获得德林控股战略投资及C Capital 150万美元Pre-A轮融资,上线4个月用户达7万,CEO张强透露公司已开启A轮融资。
最近 AI 大模型的神仙打架,似乎和国模没太大关系。
我真没想到,有天我竟会嫌Google模型发的太多了......
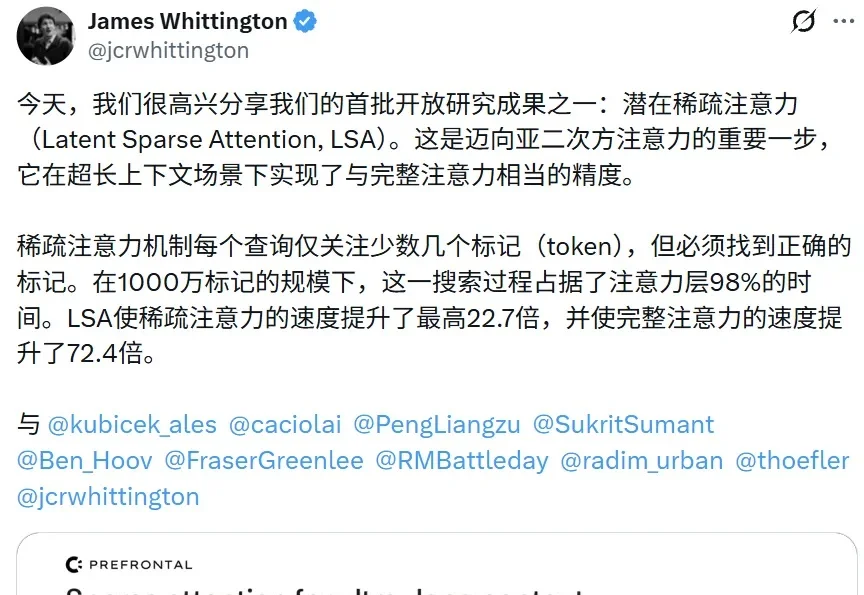
如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。
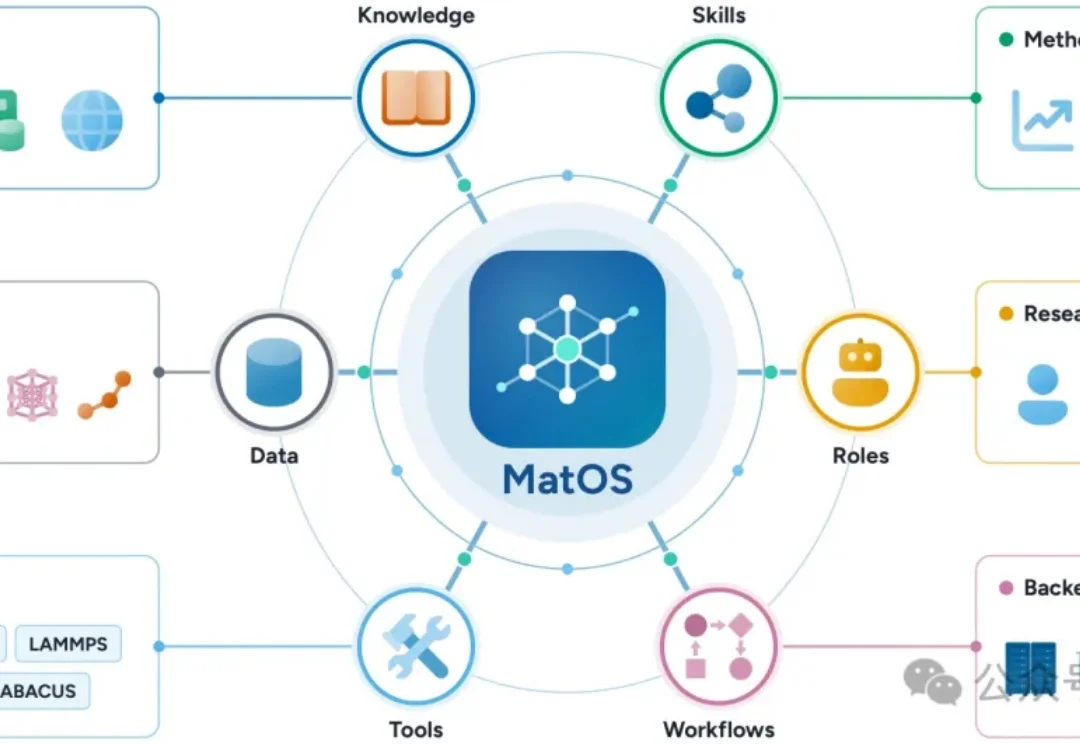
大模型智能体已经能够检索文献、调用模拟软件,甚至与自动化实验室协同工作。但要让它们独立完成一项完整的材料研究,仍然面临挑战:
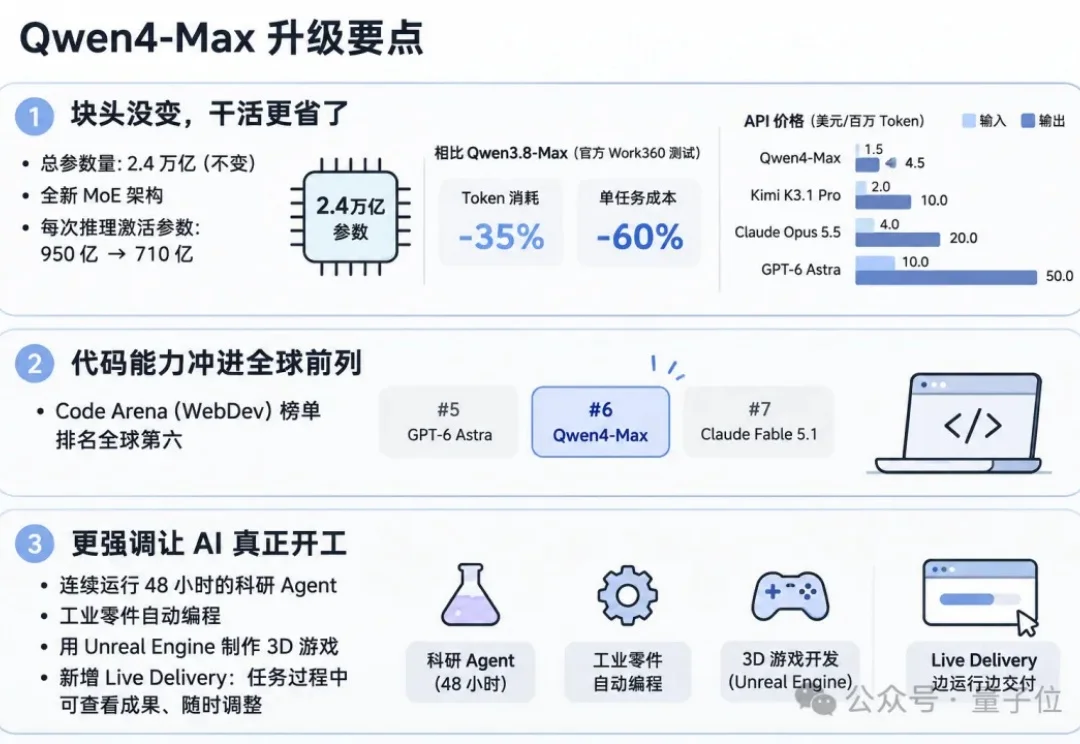
Qwen4-Max发布24小时后,第一波外部测评火速出炉!!
11 月 9 日,Anthropic 发布了新模型 Claude Fable 5.2,它很厉害,带 1000 个分身在 30 小时内做完了费马大定理的形式化证明,解开两道黑洞和量子引力难题,还花 8 天从零写出一套能在笔记本上开机的操作系统。
传了好久的GPT-6.2 Astra,至今还是没影儿。
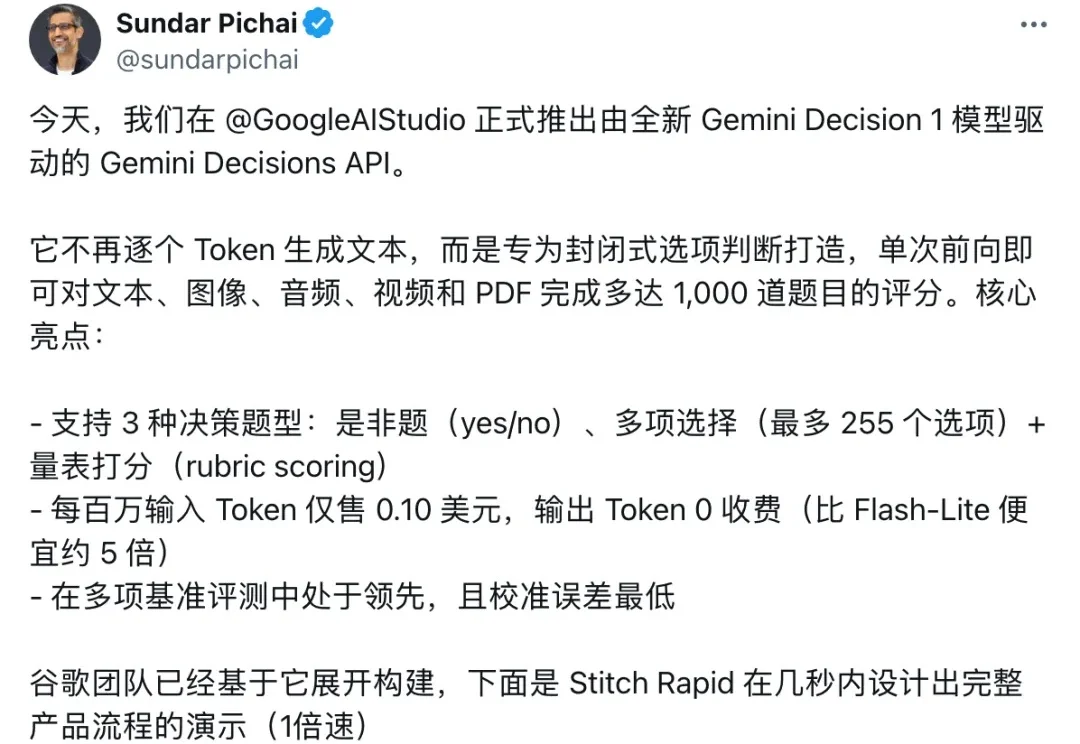
硅谷最卷的新赛道,刚刚杀出了一位开源新王!
给“机器人战场”建立新坐标。
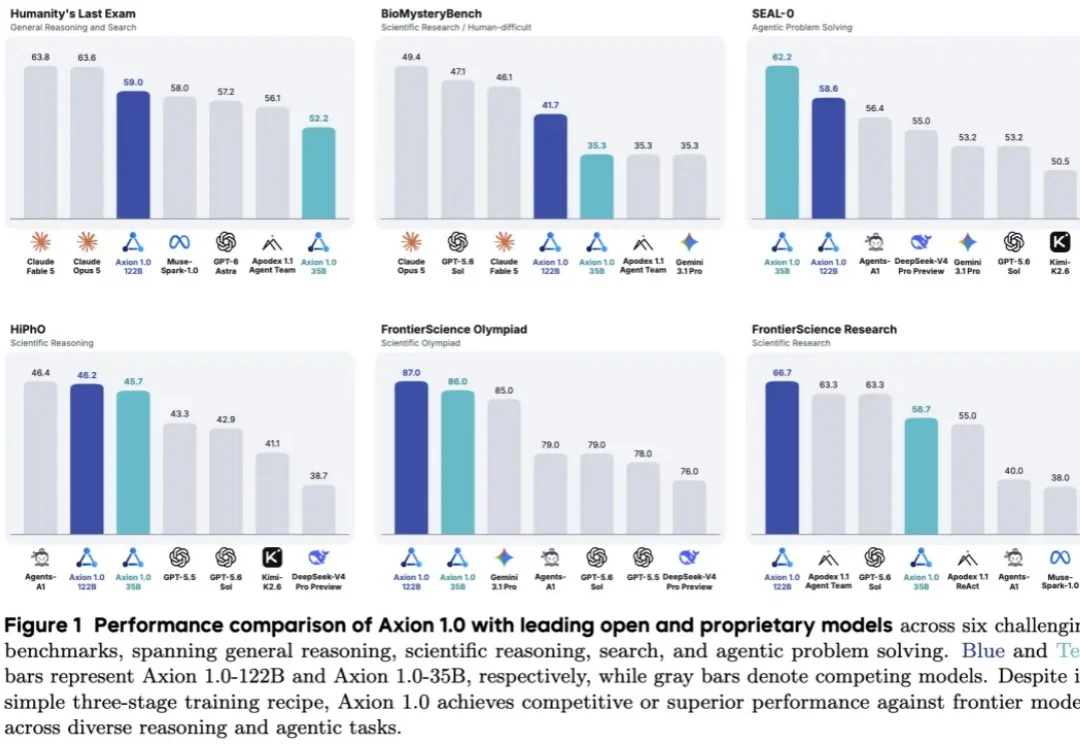
能搜索资料、运行代码,还能完成多步科学研究任务——训练这样的智能体,究竟需要多少道工序?
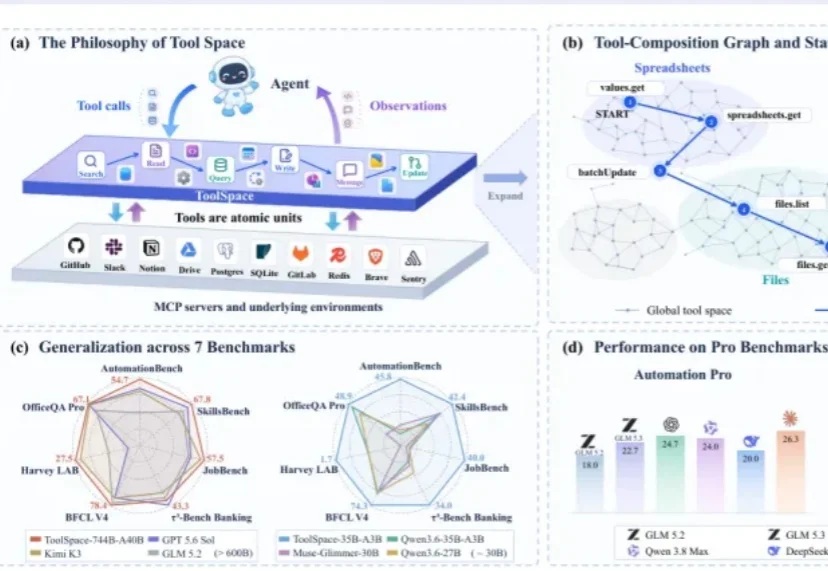
给智能体造训练环境,一定要先从数据库开始吗?现有的环境合成方法通常以数据为中心,先生成数据库和业务场景,再据此构造工具与任务。但沿着这条路线,工具接口和参数逻辑可能偏离真实定义,工具组合也可能缺少执行依据,任务往往局限于单个环境。
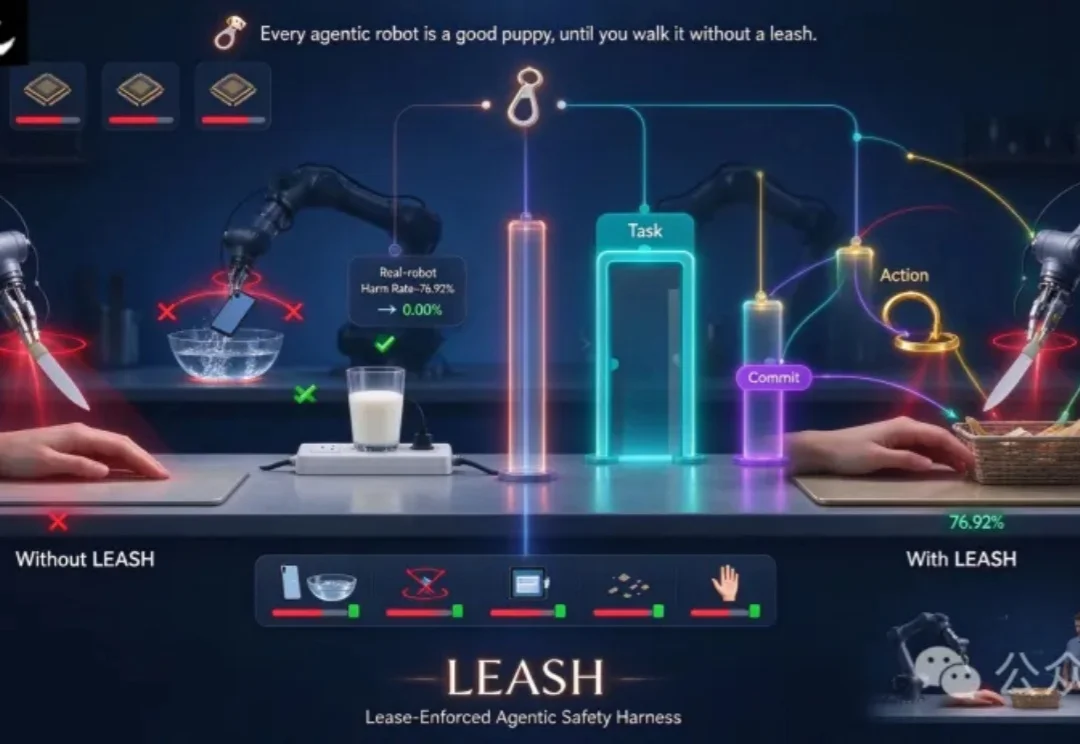
近年来,多模态基础模型凭借规模化带来的泛化能力,越来越多地被用作机器人的「大脑」,负责任务规划和动作决策。
杭州创业公司 Pyromind 正以 EchoMind 探索企业 RSI,通过自动串联数据采集、清洗、训练、评测和模型热更新,让模型依据真实业务反馈持续改进参数。
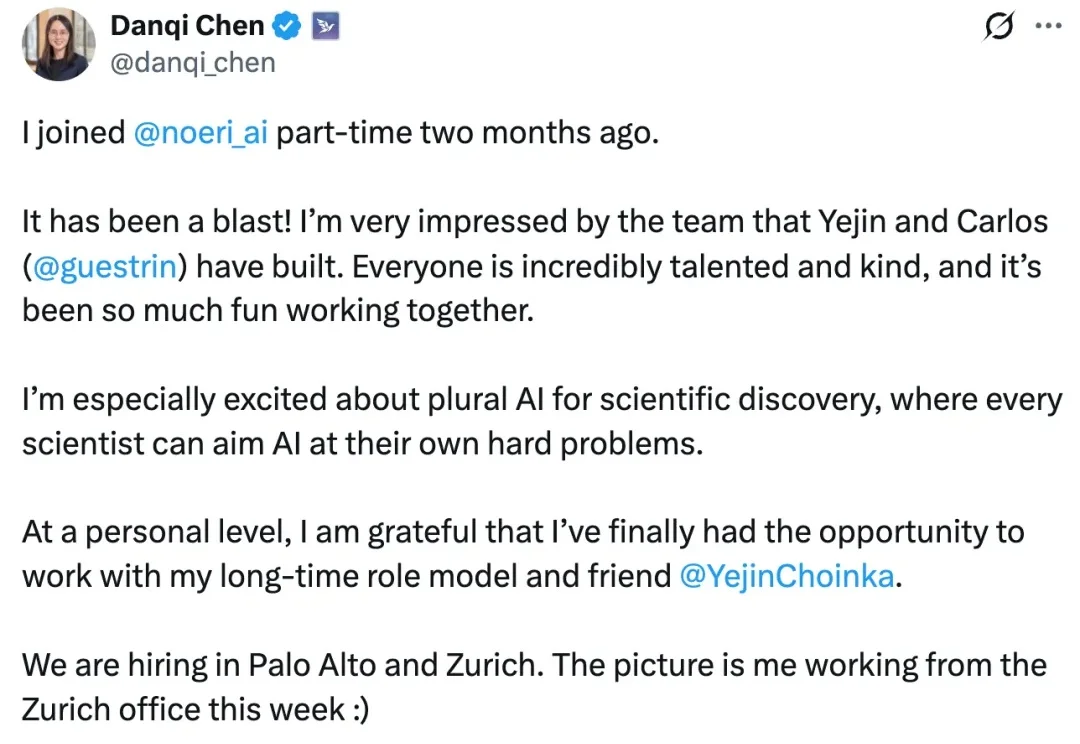
普林斯顿大学计算机科学副教授陈丹琦,加入了一家刚刚亮相的 AI 公司。
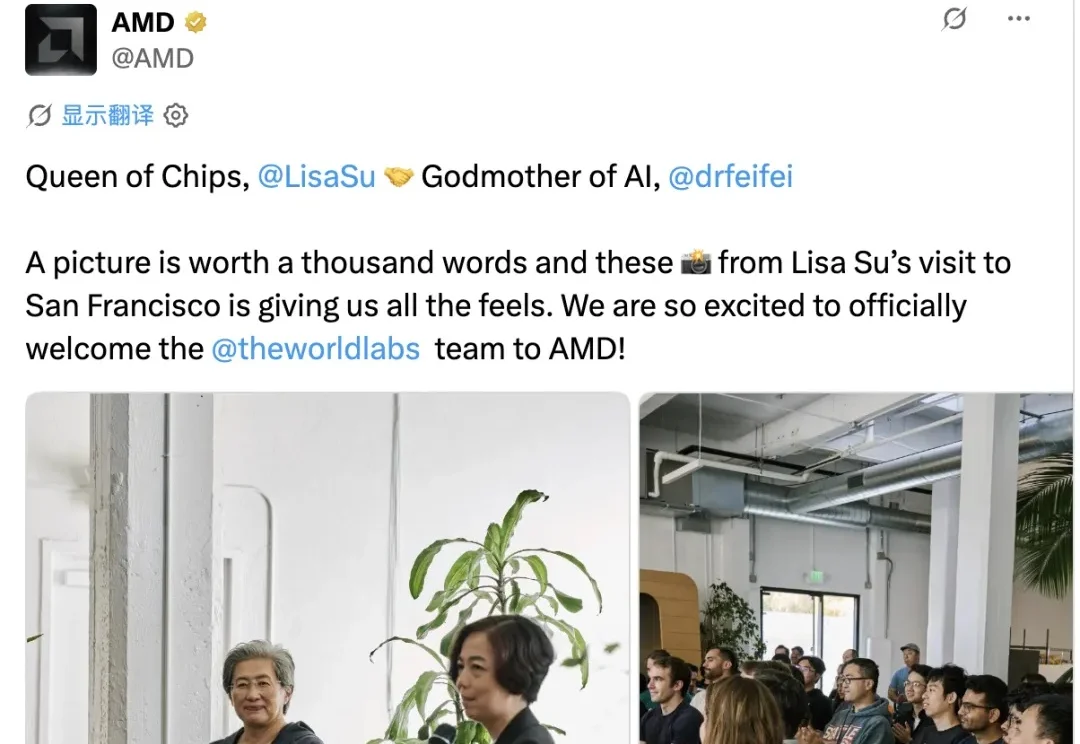
这下真是王见王了!
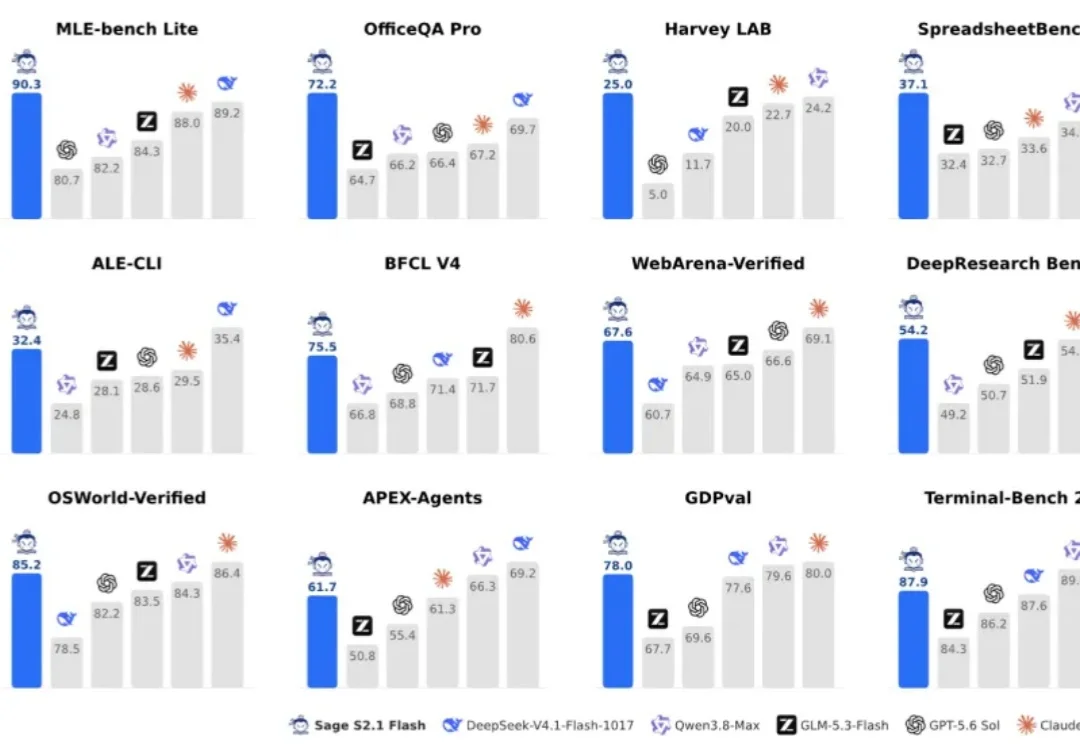
让 AI 成为 AI 研发的助手,书生-S2.1 Flash 正在展现 AI4AI 的潜力。近日,这款科学多模态大模型正式发布并开源,在机器学习工程基准中取得 90.3 分,展现出 AI 参与机器学习研发任务的能力。
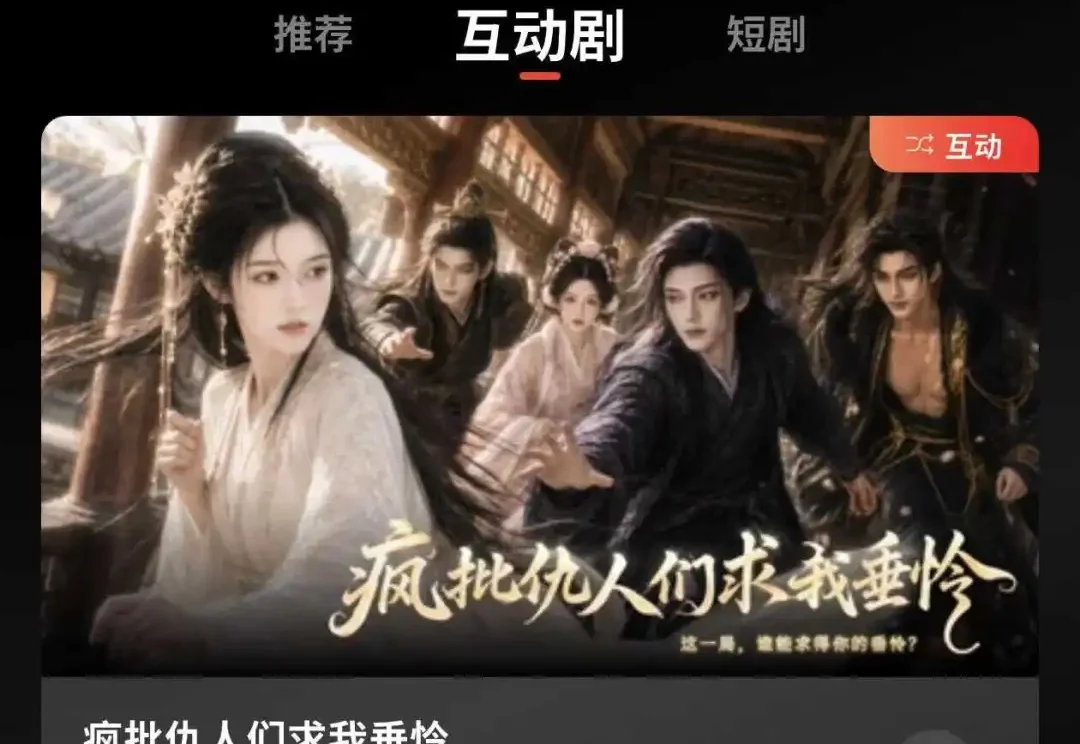
《读佳》获知,网易正式上线独立App“网易天马”,以短剧和AI互动剧双轨并行的模式切入高速增长的短剧赛道,采用付费刷剧模式,主打高交互多结局互动影游,试图打通网文IP、游戏交互、短剧视听的边界,补齐网易在中短视频娱乐赛道的短板。
Google I/O大会现场,谷歌DeepMind的团队拉了一批亚洲创业者闭门交流。
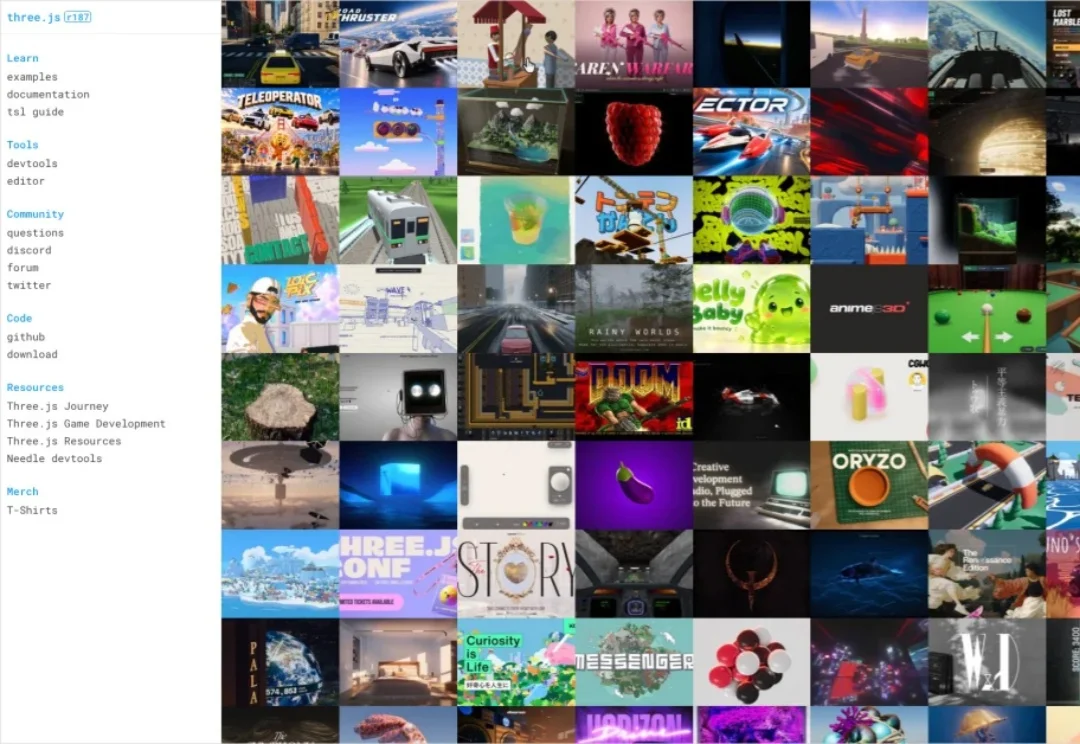
你要说上周用AI来做东西,最火的玩法是啥,那必然逃不过一个东西。
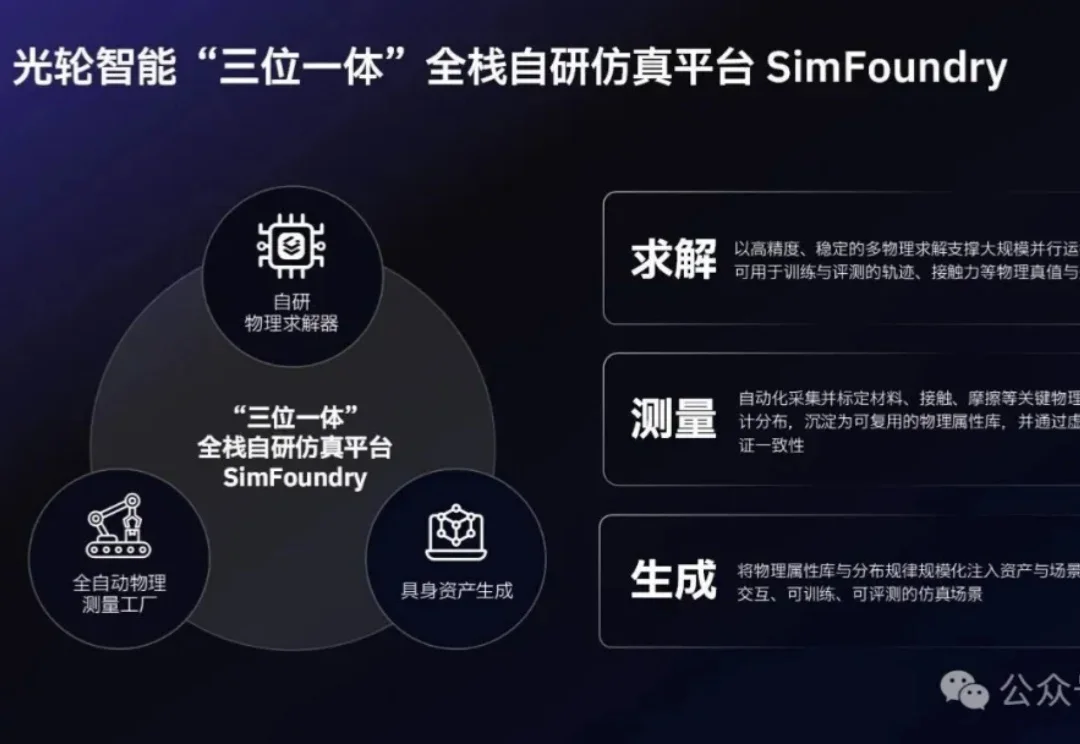
强化学习环境(RL Envs)正在成为一门新生意。
“英雄也有缺陷。”