
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
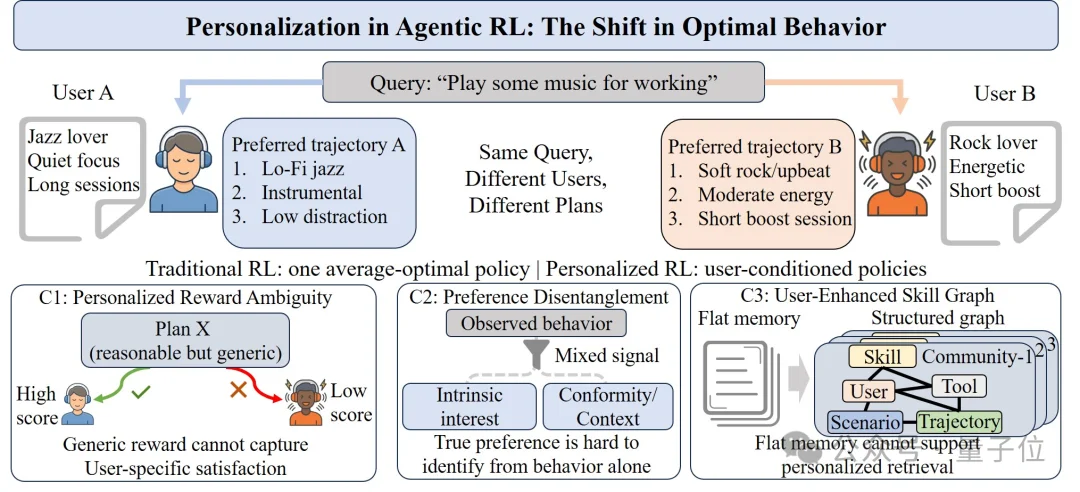
当个性化Agentic RL遇上现实用户平台场景时,一直存在一个常见难点:面对同样的query,不同用户往往偏好不同的规划策略、工具调用和最终表达。
如果只优化通用的任务完成度,模型容易学成“平均用户最喜欢的样子”;直接把历史行为塞进prompt,又可能把从众、流行度和上下文噪声误当成真实偏好。
针对这些挑战,来自中国科学技术大学与阿里巴巴集团的研究团队提出PARPO(Personalized Anchor Reward-Decoupled Policy Optimization),把个性化正式放进Agentic RL的训练期优化目标。
在代码生成、搜索等有明确答案的任务里,奖励相对容易定义;但在电商助手、旅行规划和日程安排中,多条轨迹都能“完成任务”,用户真正在意的却是是否符合自己的习惯、约束与偏好。
论文将挑战归纳为三点:
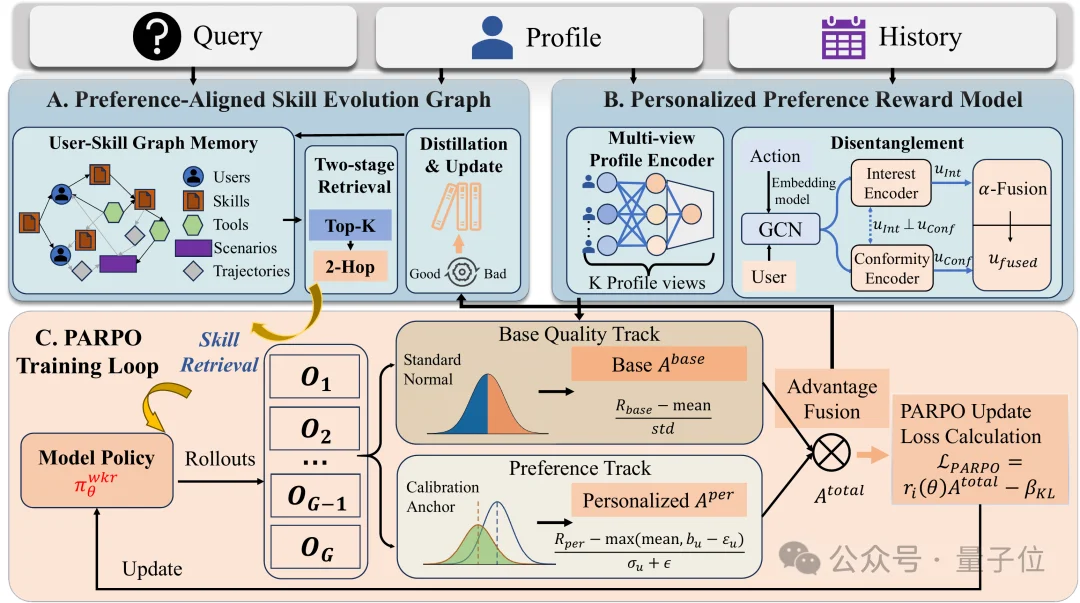
PARPO不是单独替换GRPO的一个公式,而是三个相互衔接的部分:PSGM在rollout之前提供用户相关的技能和经验;两阶段偏好解耦奖励模型在rollout之后产生个性化奖励;PARPO优化器将通用任务质量和个性化偏好分成两条advantage轨道,再进行策略更新。高质量轨迹随后被总结为新技能写回PSGM,形成“检索—交互—评价—优化—积累”的闭环。
PSGM(偏好对齐技能演化图记忆)把历史经验组织为包含User、Skill、Tool、Scenario、Trajectory五类节点的异构图:检索时先按query找到语义种子技能,再沿“技能—用户—同源技能”扩展候选,综合用户相关性、互补加成与冲突惩罚排序——找回来的经验未必在文本上最相似,却处在同一个有效行为邻域里。
奖励模型分两阶段:第一阶段用多视角用户画像缓解冷启动;第二阶段在用户—物品交互图上用LightGCN建立兴趣与从众两个正交分支,兴趣分支提高低流行度项目的权重、从众分支相反,从而从混合行为中提取更干净的偏好信号。
优化器侧,个性化分支通过指数移动平均维护用户级历史锚点,让当前奖励与该用户自己的历史中心比较,而不是与所有用户混合后的均值比较,缓解异质偏好下的reward-center与reward-scale失配。直觉是:通用质量负责让agent把事情做对,个性化质量负责让它用这个用户愿意接受的方式做好。
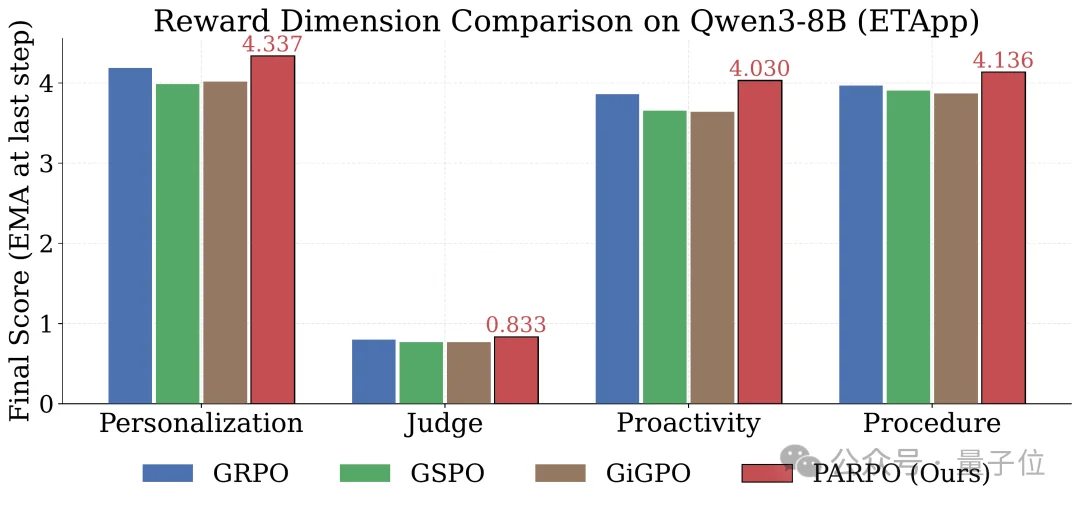
论文在ETAPP、更困难的ETAPP-Hard和面向商家决策的SJAgent上评估(Qwen3-4B/8B),与ReAct、GRPO、DAPO、GSPO、GiGPO、MemRL、SkillRL等方法比较。ETAPP上,8B模型的Judge分数达到0.8333,Personal、Proactive、Procedure等维度全面领先;SJAgent上Reward达到0.8270。在15位人类专家与4组LLM judge的盲测中,PARPO均排名第一,最大优势出现在User Relevance——说明提升主要来自更强的用户对齐,而不只是更顺滑的文字表达。
消融实验显示:去掉技能记忆后Judge从0.7708降至0.7006,是所有消融中最大的降幅;去掉用户锚点或兴趣、从众任一分支也都明显掉点——记忆、解耦和用户锚点缺一不可。
当然,方法也有边界:人工盲测规模仍然有限;兴趣—从众解耦是操作层面的,并不构成严格的因果分离。但PARPO指出的方向很清晰:同一个任务不再只有一种“正确完成”的方式——真正好的策略,还必须是这个用户愿意接受、愿意持续使用的完成方式。
论文标题:From Correctness to Preference: A Framework for Personalized Agentic Reinforcement Learning
作者:Ranxu Zhang、Zeyang Li、Jiacheng Huang、Rui Zhang、Xiaozhou Xu、Zhe Sun、Yanyong Zhang、Chao Wang
论文链接:https://arxiv.org/abs/2605.23382
文章来自于"量子位",作者 "PARPO 团队"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
