
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
现在的 Agent 的产品越来越多,有些主打 Coding,有些事做日常办公,也有些用于情感陪伴虽然这些产品的用途不同,背后的工作原理其实都大同小异,便是 Harness 对上下文的自动化编排
本文则是以原理的角度,给大家讲一下 Agent 工具是如何使用进行上下文编排,让模型一步步把事情做完,然后输出结果的
我尽可能用简单的语言,让大家能看明白
同时我们也能够看到,模型每次做判断之前,系统具体都在准备什么:前面读过哪些资料,中间拿到什么反馈,后面保留了哪些信息,都可能影响结果?
模型在请求的时候,输出的东西可以先理解为两类:
比如你问「什么是用户登录」,模型可以利用已有知识回答。但你问「我们网站为什么登录失败」,这个网站的代码、运行环境和报错,就需要另外提供
把报错粘贴进去,模型获得了一条线索。让它检查项目,模型还需要通过工具读取相关代码。即便文件就在当前目录中,也要先找到它,再把相关内容放进请求
这些随请求提供的指令、对话、资料和工具结果,共同构成了我们常说的「上下文」。对于这项具体工作,模型能依据什么判断,很大程度上取决于这里面有什么
这份上下文会随工作进度更新。当前要求和适用指令约束任务,保留下来的历史交代前情,工具结果补充新事实。系统再把这些内容,组织成发给模型的请求
因此,要分清三个范围:
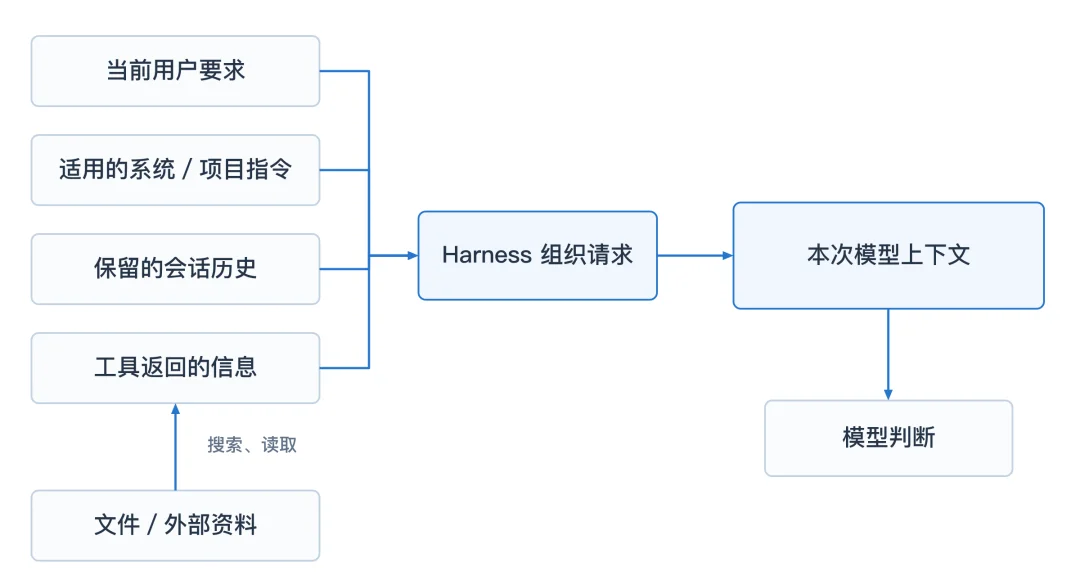
上下文来源与请求组装
比如你给 AI 一份新文件,通常是在为当前任务补充上下文。这个过程本身,并不会把文件里的知识永久训练进模型
在这里,Agent 做出来的结果既依赖于模型能力,也依赖于拿到的材料(由 Harness 负责编排)
Agent 会把模型提出的操作交给工具,而对于工具返回的结果,需要进行下一次判断
假设你让 Agent「找出网站报名失败的原因」。它先搜索报名相关文件,读到提交逻辑,再执行检查。检查返回了一个错误:页面提交的字段,和服务端要求的不一致
对于实际检查得到的错误,Harness 会将这些加入后续请求,让模型由新的依据去修改对应代码,并再次检查,接着就是一个 loop:模型提出操作,工具执行,结果返回,再进入下一次判断
从用户的角度,Agent 在进行一项持续的任务,可能持续好几个小时,而在 Harness 的内部,则经历了多轮模型请求、读取文件、修改代码、执行命令等等
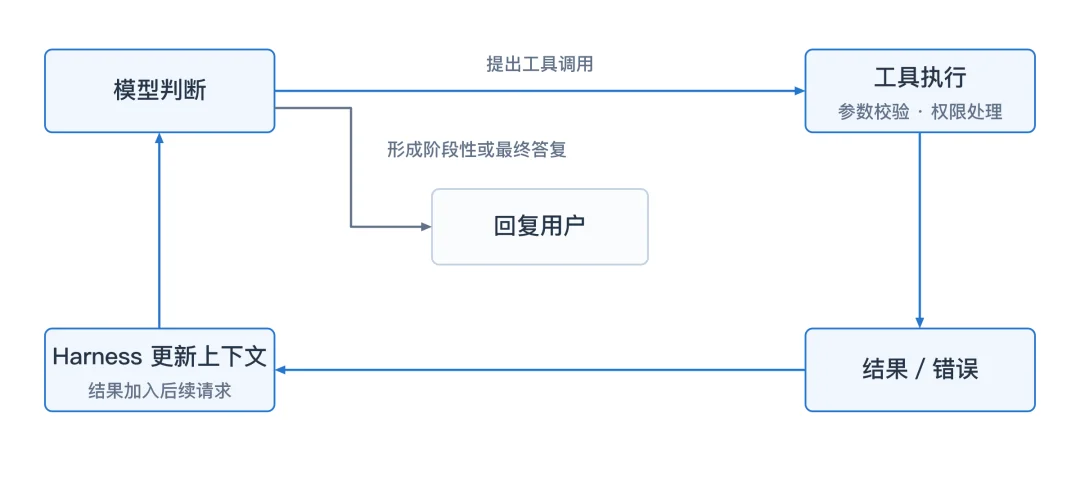
模型判断、工具执行与反馈循环
工具既让模型采取行动,也让模型获得新的信息
搜索让模型扩大了它的动态上下文范围,检查工具(或者类似视觉校验)让它知道之前的修改是否成立,于是我们看到在过去一年里「生成了代码」与「完成了任务」之间的距离在被快速拉齐
Agent 就是这样,依赖各种的外部反馈,进行不断的写入、运行、检查,然后不断继续修正
工具越多,模型需要了解的使用说明也越多。但一项任务,通常只会用到其中一部分
比如你要处理一份表格,可能需要计算、整理和导出。此时把视频剪辑、网页设计、手机模拟器的全部说明一起交进去,会占用本来可以留给任务材料的空间
对于 Skill,Harness 可以采用分步加载的方式。先提供名称、简述和位置,模型判断需要哪一项,再读取详细说明。这种方式,可以叫作「渐进加载」
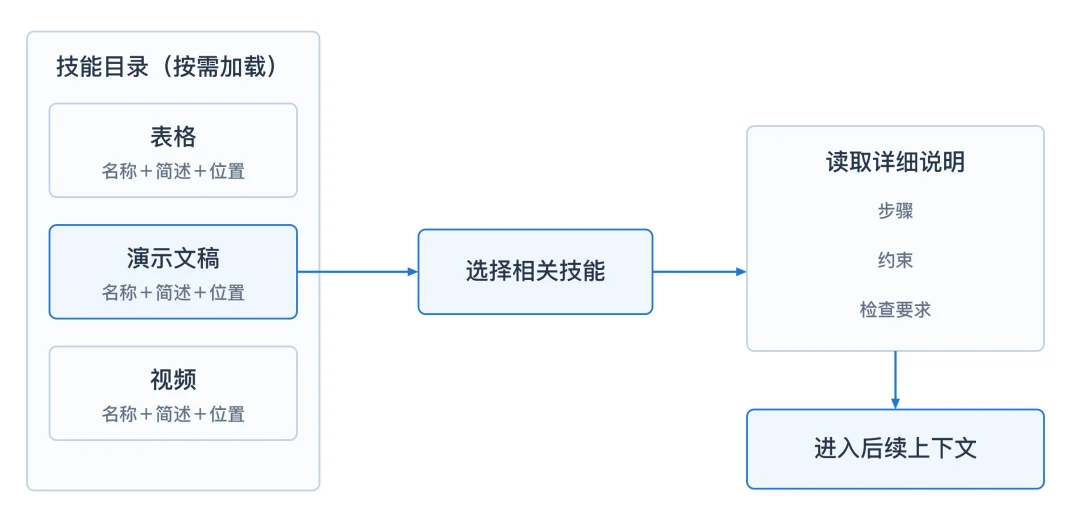
Skill 按需加载
Skill 提供的是做事的方法:遇到什么情况,按什么步骤处理,最后怎样验证。工具提供的是具体操作能力:读取文件、运行程序、取得数据。读过方法以后,还需要调用工具,才能完成动作
比如一份制作演示文稿的 Skill,可能要求先确定结构,再生成页面,最后检查版面。模型读到这份说明,才知道这套流程。能否生成文件、检查页面,则取决于实际可用的工具
外部能力还可以通过 MCP 接入。对用户来说,可以把它理解为一种连接约定,让 Agent 能发现并调用外部服务提供的工具。一次调用返回的内容,再进入任务上下文
插件则可以把相关的技能、命令和 MCP 服务配置组织在一起,方便安装和管理。这几个词分别回答不同的问题:怎么做、能做什么、怎样接入、如何分发
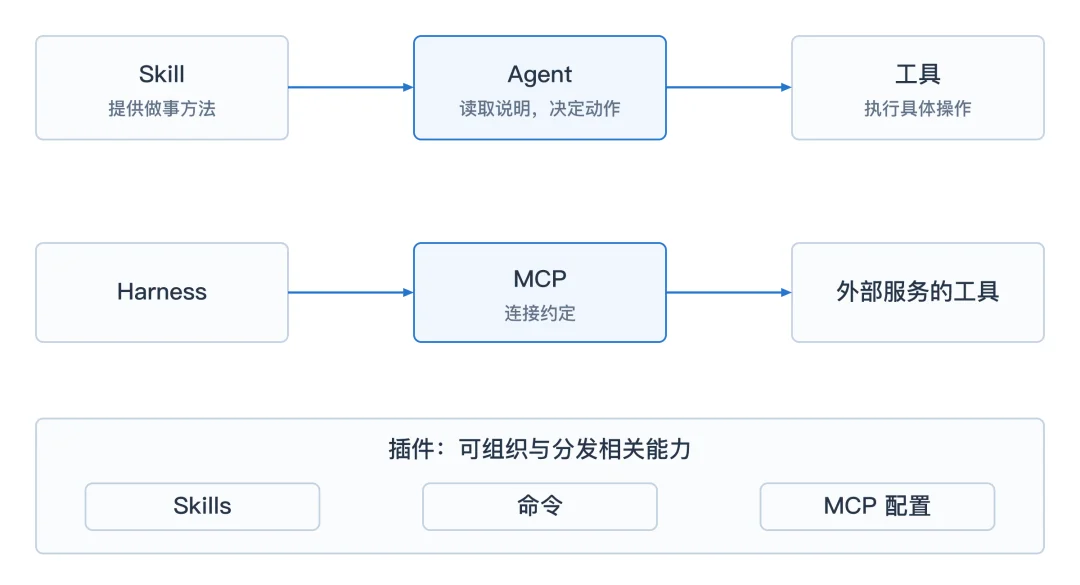
Skill、工具、MCP 与插件的职责
因此,安装一个插件,只是让相关能力有机会参与任务。具体信息仍然要经过发现、选择和调用,才会成为模型这次判断的依据
Agent 连续工作,会积累越来越多的信息,而模型一次能处理的上下文有容量限制
代码搜索可能返回几百处结果,命令可能输出很长的日志。同一个文件,还可能被读取和修改很多次。如果全部原样保留,后续请求很快就会接近容量上限
Harness 可以在几个位置处理这些信息。工具返回时,可以先限制输出体积,截断或保存到文件,再返回预览。后续请求之前,也可以检查历史是否过长,再按策略整理或压缩
历史压缩以后,任务可以继续,但模型收到的内容已经可能变化。你在界面上能够翻到的旧记录,未必仍然完整地出现在当前请求中
这时,文件与上下文的区别就更明显了。原始日志可以保存在文件里,当前上下文只保留定位问题所需的部分。后面需要细节,再通过工具重新读取
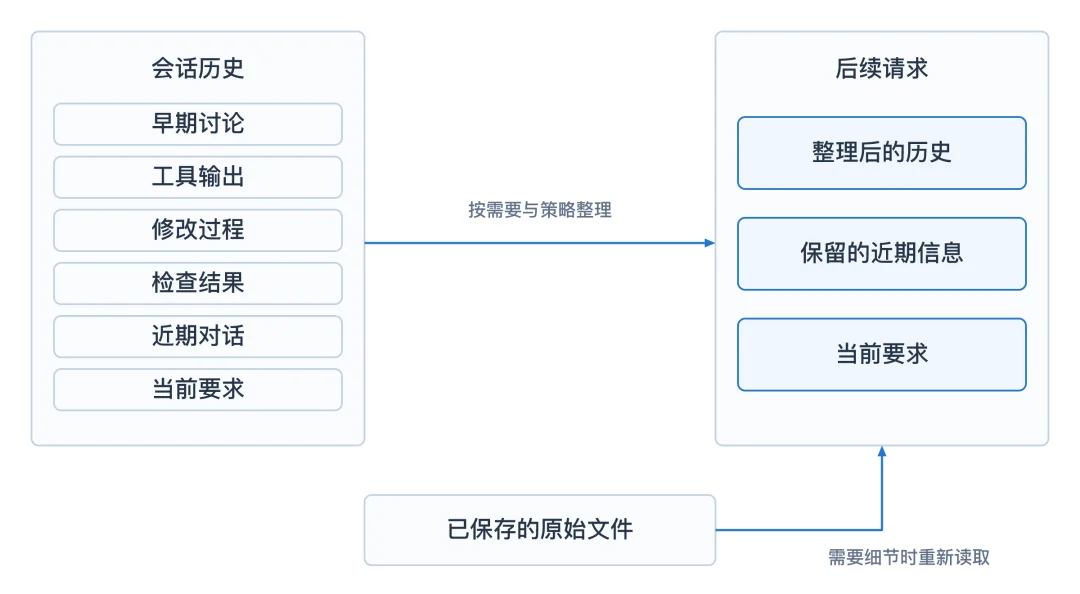
历史整理与文件重读
「记住一件事」,也就有了不同层次:当前上下文里带着它,会话记录里存着它,项目文件里写着它。只有后两种保存,并不能保证下一次模型请求一定用上它,还需要相应的恢复或读取过程
对长期任务来说,进度记录因此很有用。目标是什么,已经做了什么,哪些判断有依据,还有什么没完成,都可以明确保存下来。后续接手时,有东西可读,也有事实可核对
把一条要求写进项目约定,作用也在这里:它获得了被后续发现和加载的机会。保存、读取和遵守,仍然是几个需要分别成立的环节
把任务交给多个 Agent,也需要把信息分配给不同的参与者
假设要整理一份研究报告,可以让一个 Agent 查产品资料,一个核对数据,另一个检查结论。每个子 Agent 都需要自己的任务说明、相关背景和可用工具,随后在各自的上下文中工作
子 Agent 可以在独立会话中工作。它具体继承哪些指令、获得哪些材料,由系统设计、任务配置和交接方式决定。主 Agent 已经读到的内容,不能默认所有子 Agent 都同步知道
这种分工可以减少主会话里的细节堆积。负责核对数据的 Agent,可能阅读了很多表格,最后只交回数字、出处和发现的问题。主 Agent 据此继续组织报告
但结果压得过短,也可能丢掉关键依据。子 Agent 只说「数据没问题」,和交回「核对了哪些数据、依据是什么、哪里仍有疑问」,对后续判断的帮助完全不同
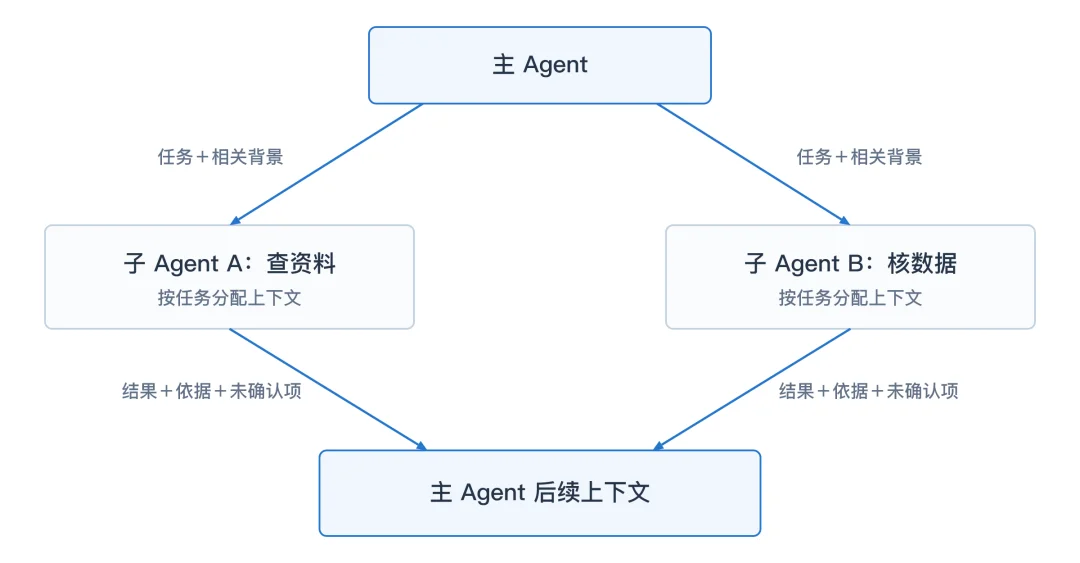
多个 Agent 的信息交接
所以,多 Agent 协作要同时安排两件事:谁做哪部分,以及做完交回什么。任务拆分决定并行工作的范围,信息交接决定结果能否接着使用
工作流还可以给这层交接增加结构约束。某一步可以要求固定格式的结果,并在提交时校验。不符合要求,就反馈具体问题,让 Agent 在限定次数内修正
比如规定每条结论必须附上来源,可以检查来源字段有没有填写。来源是否可靠,能否支持这条结论,仍然需要进一步核对。结构化交接,解决的是其中一部分问题
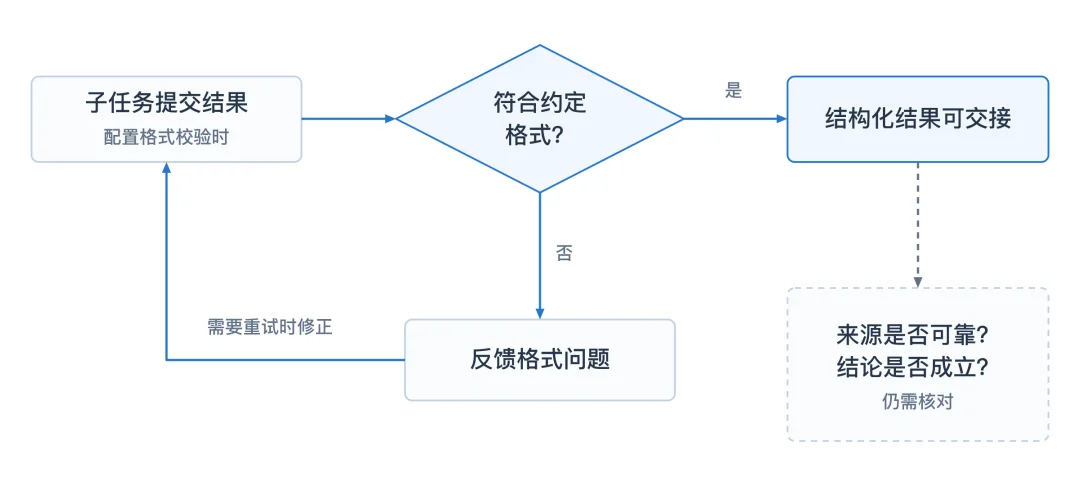
交接格式校验与事实核对
Agent 工作到一半,你发来的新要求,也需要进入后续处理
比如它正在修改登录页面,你补充一句「先别改,告诉我原因」。系统需要接收这条输入,在相应处理时点把它交给 Agent,同时处理此前已经开始的操作
一种处理方式,是由 Harness 为运行中的输入和后台通知设置队列。子 Agent 完成了工作,用户补充了要求,这些信息都需要按各自的规则进入任务。消息的顺序,也会影响下一轮判断
工具调用与工具结果之间,还有配对关系。某个工具已经开始执行,返回结果属于哪次调用,必须保留下来。系统可以把部分消息延后处理,避免插入后破坏这种关系
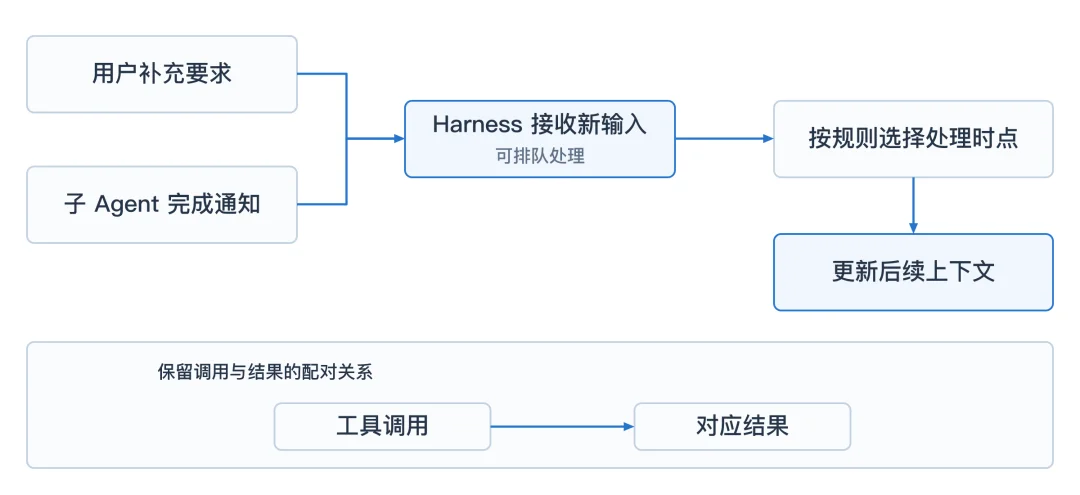
运行中的输入处理与调用配对
从这里再看上下文,它既包含「有什么」,也包含「按什么顺序出现」。同样一条报错,放在修改之前,是定位问题的线索。放在修改之后,则可能说明刚才的修改没有解决问题
任务换到另一个界面时,同样需要接续这些状态。如果连接的是同一个已有会话,可以沿用原来的任务状态;如果新建会话,就需要另外组织上下文。项目文件可以仍然存在,上一段讨论中的取舍和疑问,却需要通过记录或交接带过来
以上这些,便是 Agent 工作时「上下文编排」的一组常见做法:
这些步骤会被不断重复,模型决定下一步怎样做,系统则持续组织它做判断时所依据的信息
大家使用时候的连贯感,便是这些环节的共同作用
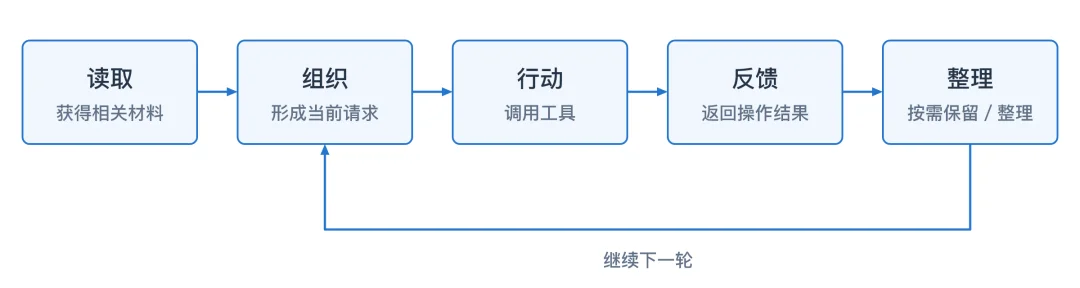
上下文编排循环
文章来自于"赛博禅心",作者 "金色传说大聪明"。


【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
