
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
AI 正从看懂画面,走向理解空间、预测变化、执行动作。
AI 已经越来越会生成一个“看起来真实”的世界,却依然很难真正理解并行动于这个世界。
物体在哪里、彼此是什么空间关系,遮挡之后还剩下什么;一个动作发生后,世界会怎样变化。这些问题的解法,共同指向空间智能。
而近两年具身智能与世界模型的爆火,进一步推动空间智能成为 AI 走向物理世界的核心能力基座。
回看 ECCV 2026,这趋势尤其明显。
大会程序主席 Anna Rohrbach 公布的数据显示,本届 ECCV 共收到 10473 篇投稿,最终接收 2834 篇。按研究主题划分,图像与视频合成以超过 1400 篇位居第一,视觉、语言与推理第二,3D
则从此前的主导方向退居第三。
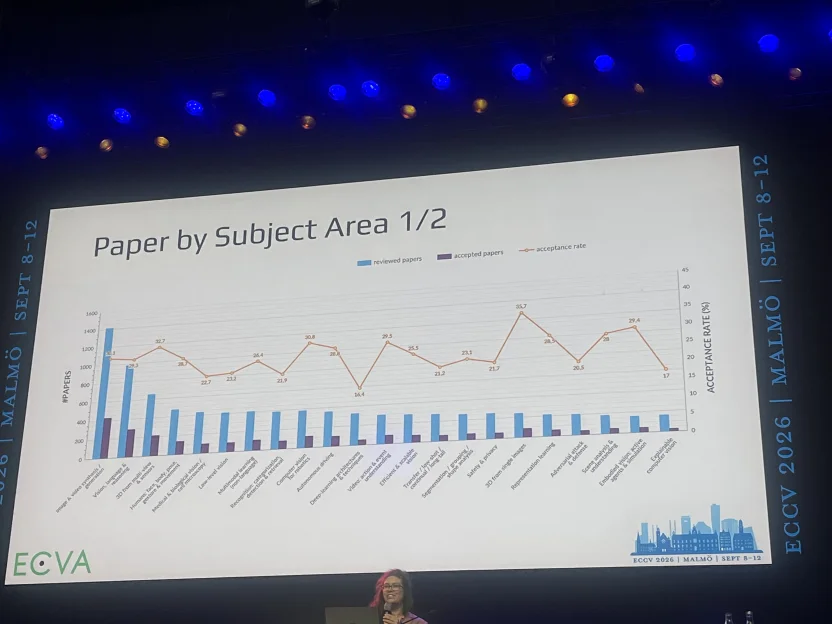
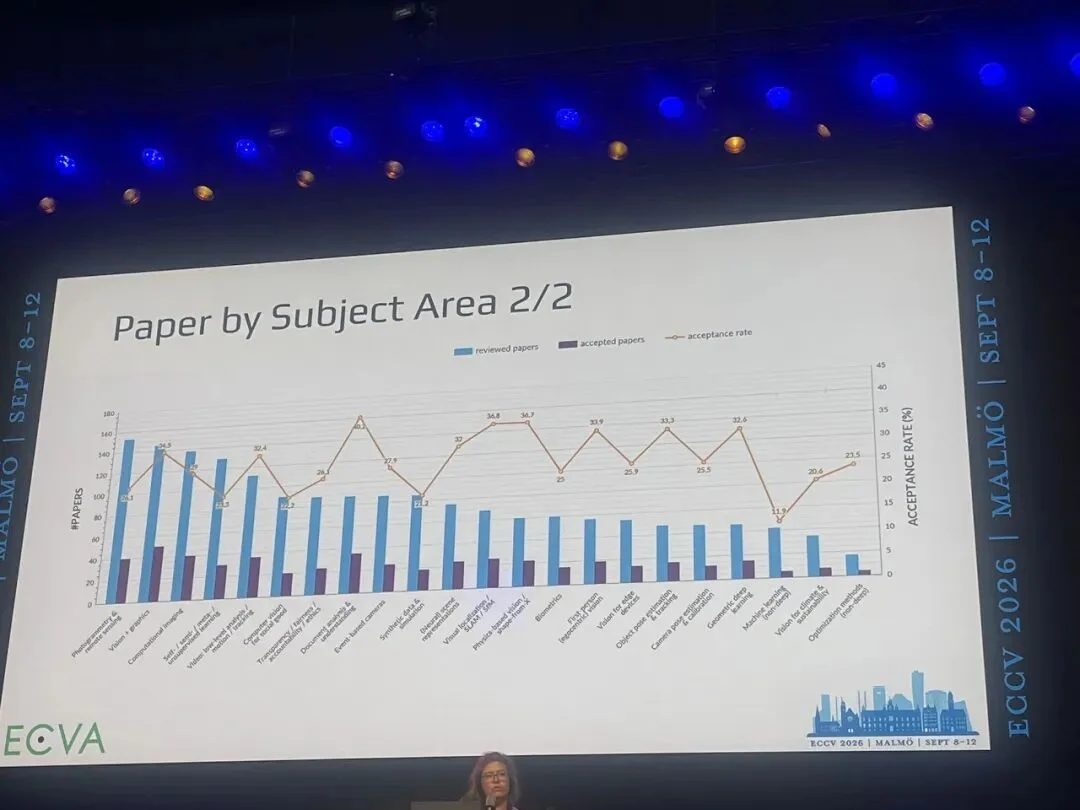
但 3D 主题排名的后退,不等于3D 退潮。相反,过去主要集中在 3D 视觉和图形学中的三维表示、几何与物理一致性、动态建模、可交互生成与空间推理等基础问题,正在向视频生成、机器人、具身智能、世界模型等方向扩散,成为 AI 走向物理世界时共同面对的问题集。
从大会 Workshop 也能看到这种变化。93 场 Workshop 中,约 10 场与 3D 直接相关,11 场涉及空间智能,9 场指向物理AI,还有 5 场以世界模型为主题。
尤其是在世界模型和物理 AI 相关 Workshop 中,不少演讲都在围绕三维空间理解、动态场景建模、预测以及进一步的执行能力展开探讨。
香港科技大学教授谭平围绕可扩展的 3D 场景重建与生成展开,从场景表示切入三维空间理解;
斯坦福大学助理教授吴佳俊从二维视觉进一步走向随时间变化的三维点云轨迹,用时空表示理解物体状态及空间关系;
中山大学教授梁小丹把重点放在未来预测上,强调世界模型要能够推演接下来真正可能发生的状态变化;
哈佛大学助理教授杜逸伦则从生成式 AI 和世界模型出发,让模型先“想象”不同动作可能带来的未来,再通过搜索这些未来结果完成规划。
如果说投稿和 Workshop 反映的是热度,奖项则更能说明风向。
今年的 Koenderink 时间检验奖中,有一项颁给了空间智能旗帜人物李飞飞及其团队。最佳论文重新讨论三维表面的表示方式;两篇最佳论文荣誉提名也分别落在物体三维重建和几何感知上。
这些信号放在一起看,3D 相关研究依然保持高热度。几何重建、场景表示和渲染等老问题继续深化,研究也在向动态场景、4D 表示和交互式环境延伸。三维视觉开始承担更多空间理解的任务,并进一步支撑状态预测和行动。空间智能正在成为串起这些问题的一条主线。
今年几项主要论文奖中,三维表示、重建和几何感知反复出现。
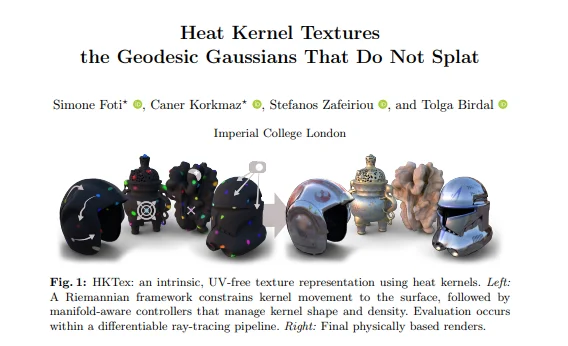
最佳论文《Heat Kernel Textures — the Geodesic Gaussians That Do Not Splat》由帝国理工学院的 Simone Foti、Caner Korkmaz、Stefanos Zafeiriou 和 Tolga Birdal 完成。它重新回答了一个很基础的问题:三维曲面的纹理到底该怎么表示。
论文链接:https://arxiv.org/pdf/2609.07557
传统网格纹理大多依靠 UV 映射,把三维曲面摊到二维平面上贴图。这套方法成熟好用,但一直摆脱不了几个老毛病:纹理接缝、曲面拉伸、UV 空间浪费、顶点重复、不同区域分辨率参差不齐。
Heat Kernel Textures 换了一条路。它从离散黎曼几何出发,用各向异性热核在曲面的测地空间中直接表达纹理,相当于避开了“先把三维表面摊平,再贴纹理”这条传统路径的缺陷。评审委员会认为,这是一项简洁而新颖的表面纹理表示方案。它把纹理表示从二维 UV 空间重新放回三维曲面本身,应用潜力也不局限于论文本身。
两篇最佳论文荣誉提名,也都落在三维重建与几何感知上。
Meta Reality Labs Research 的 Zhengqin Li 等团队提出的 《LSRM-High-Fidelity Object-Centric Reconstruction via Scaled Context Windows》,关注前馈式物体三维重建的保真度。它通过扩大 Transformer 的上下文窗口,并加入 3D 感知空间路由等设计,让模型利用更多跨视图信息,在保持前馈效率的同时恢复更精细的物体结构和外观。
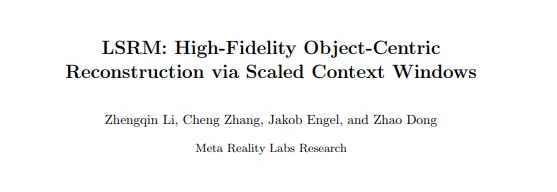
论文链接:https://arxiv.org/pdf/2604.05182
另一篇提名的论文《Poppy:Polarization-based Plug-and-play Guidance for Enhancing Surface Normal Estimation》(arXiv 版本题名有所调整),作者主要来自Stony Brook University计算机视觉实验室。
它从光学信息入手,用偏振光编码的表面朝向信息,为 RGB 法线估计在复杂镜面反射等场景中的几何歧义补充物理线索,并以即插即用的方式接入现有 RGB-only 法线估计模型,无需重新训练原有主干网络。
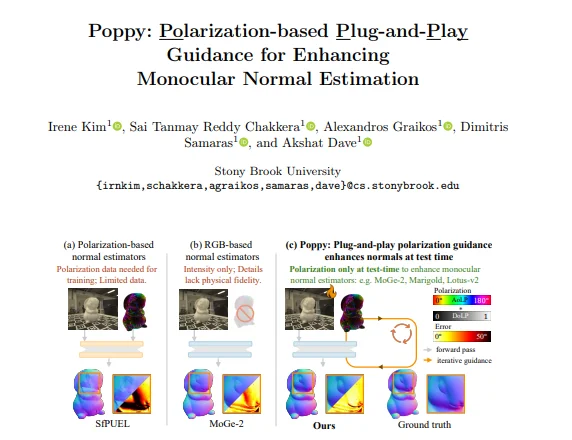
论文链接:https://arxiv.org/pdf/2603.27891
经典的 Koenderink 时间检验奖中,有一项给到了斯坦福李飞飞团队的《Perceptual Losses for Real-time Style Transfer and Super-Resolution》。
把它和今年集中出现的三维表示、几何理解放在一起看,计算机视觉关注的问题也在不断向外延伸:从图像看起来像不像,到三维结构怎么表示、真实世界里的空间关系怎么理解。
论文链接:https://arxiv.org/pdf/1603.08155
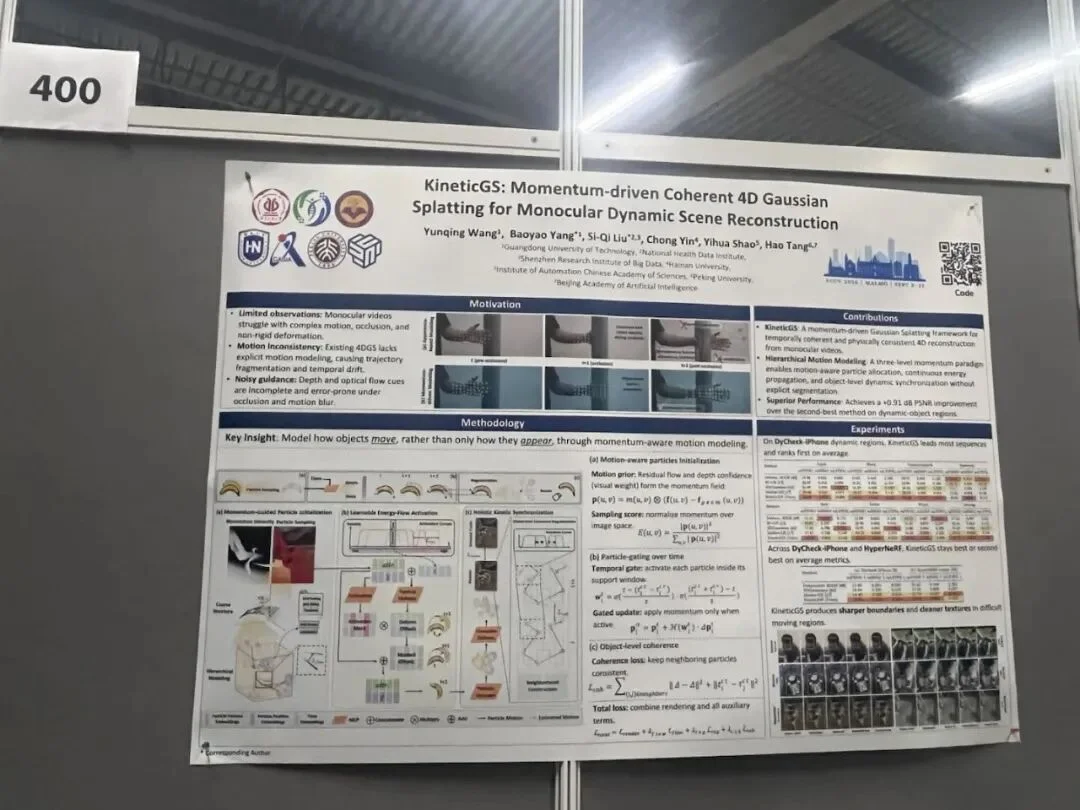
Poster 区的变化也很直观。首个 Poster Session 中,3D Reconstruction、Gaussian Splatting 与 Neural Rendering 占据了相当大的篇幅,现场大量工作围绕三维表示、重建和新视角生成展开。到了后续场次,相关问题又继续延伸到几何、运动、动态场景,以及 3D 场景理解、机器人和具身智能。
从这些论文可以看到,3DGS 已经不只用于追求更好的渲染效果,也开始被用于长序列建图、动态重建和更复杂的真实场景。
3D 视觉的基本问题仍然是几何、重建和场景表示,但研究对象已经开始动起来。人和物体会运动、遮挡和交互,模型也开始从静态三维表示,转向动态 4D 时空场景的建模。
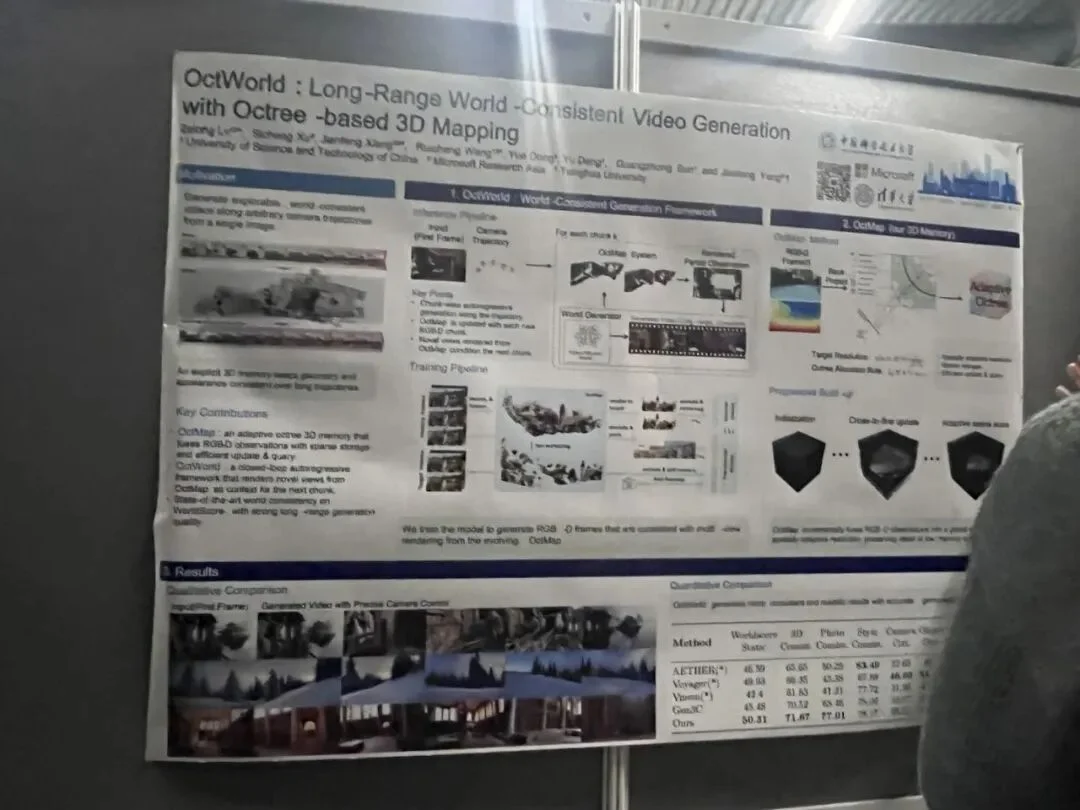
理解一个会变化的世界,还要解决另一个问题:机器每换一个视角,都得记得刚刚看过什么。
机器人在房间里移动,相机视角不断变化,物体会被遮挡,也会离开画面之后再次出现。模型如果只能处理眼前这一帧,即使单帧看得再准,也很难形成对环境持续稳定的认识。
一个真正进入环境中的智能体,需要把不同时间、不同视角看到的内容连起来,在移动过程中持续更新对同一个环境的认识,并维持空间关系、物体位置和自身轨迹的一致性。
但现有不少视觉语言模型评测基准仍停留在静态图片或预录视频的“旁观者视角”,很难衡量智能体在持续移动中建立、更新和维持空间认知的能力。
针对这一缺口,群核科技联合浙江大学等团队提出了交互式空间智能评测基准 WalkerBench,让智能体只凭第一视角 RGB 视觉,在不同城市拓扑中完成主动探索和长程导航。
它剥离了 GPS、街名等先验信息,要求 Agent 依靠连续视觉观察理解周围空间关系并完成导航。测试中,随着探索步数增加,主流 VLM 很容易出现方向迷失:短程判断没有问题,但轨迹一长,就难以持续维持之前的路径信息和整体空间关系。
GitHub链接:https://github.com/lalayang123456-ctrl/WalkerBench
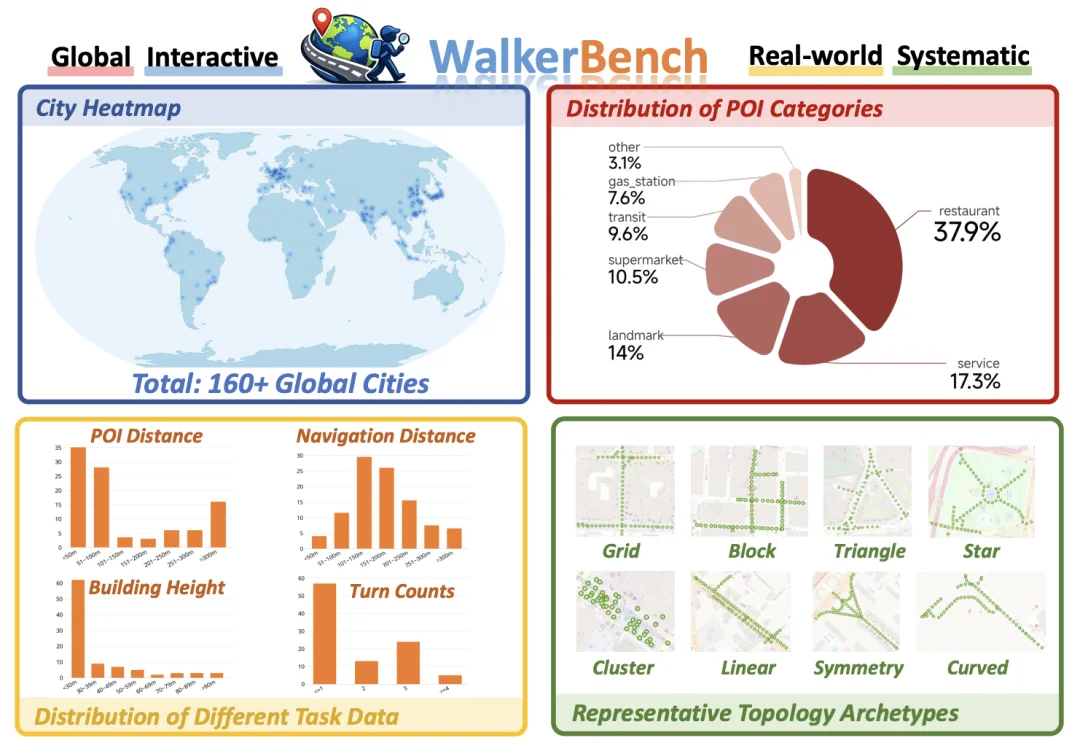
WalkerBench 概览
WalkerBench 不只把这个问题测了出来,团队也进一步提出了 Spatial-IDE。其中,ETM(状态外化与显式拓扑记忆)把智能体走过的节点、坐标、朝向、遍历历史以及语义注释等信息持续记录下来,形成一张动态更新的空间拓扑图;GDP(认知解耦与目标导向感知)则把全局路径规划和局部视觉判断拆开,避免越来越长的视觉上下文持续挤占模型的推理空间。
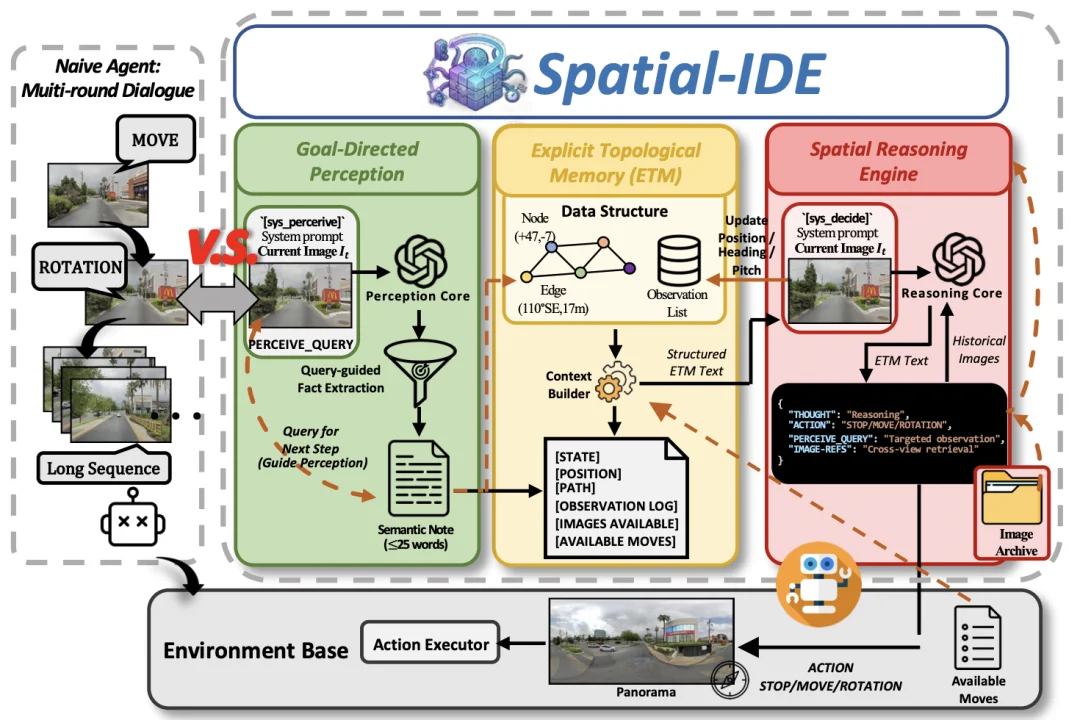
Spatial-IDE 框架
引入 Spatial-IDE 后,9 个主流 VLM Agent 的平均得分提升了 104.97%。团队还把这一框架部署到宇树 G1 人形机器人上,在真实开放街道中完成了连续多街区的千米级自主导航。
另一条路线,则尝试让这些空间信息直接沉淀到模型内部。
腾讯混元、清华大学和南洋理工联合团队提出的 Spatial-TTT,瞄准的就是长视频里的空间记忆。
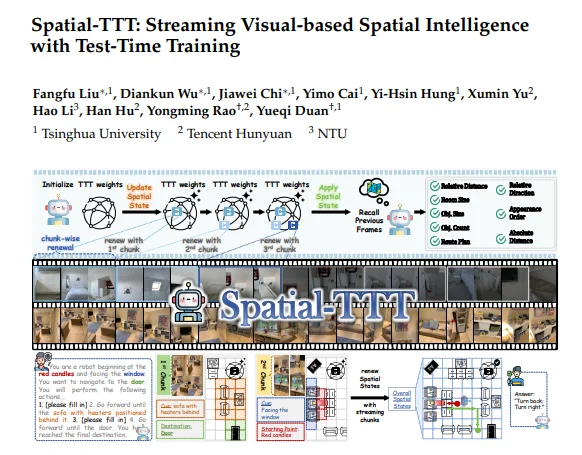
论文链接:https://arxiv.org/pdf/2603.12255
传统多模态模型处理连续视频,通常不断把新的视觉 Token 塞进上下文。视频越长,计算量越大,不同时间和视角中的空间信息也越来越难持续组织和保留下来。
Spatial-TTT 把一部分模型参数设计成可以在推理过程中持续更新的“快权重”,让已经看到的空间信息逐步沉淀下来。新的画面进来后,模型仍能保留之前的空间细节,以及不同视角之间的位置关系。
两条路线处理的是同一个问题:当智能体持续移动、视角不断变化时,怎样让它始终记得自己看过什么,并维持对同一个环境的连续认识。
能把过去的信息连续起来之后,下一步就是理解变化,并判断世界接下来会变成什么样。
现实世界不会停在被记住的那一刻。人会行动,物体会移动,机器人每执行一个动作,环境都可能进入新的状态。
场景一旦动起来,就会出现两个问题:一是怎样表示正在发生的变化,二是给定当前状态和一个动作,预测接下来会发生什么。第二个问题,正是世界模型越来越关心的部分。
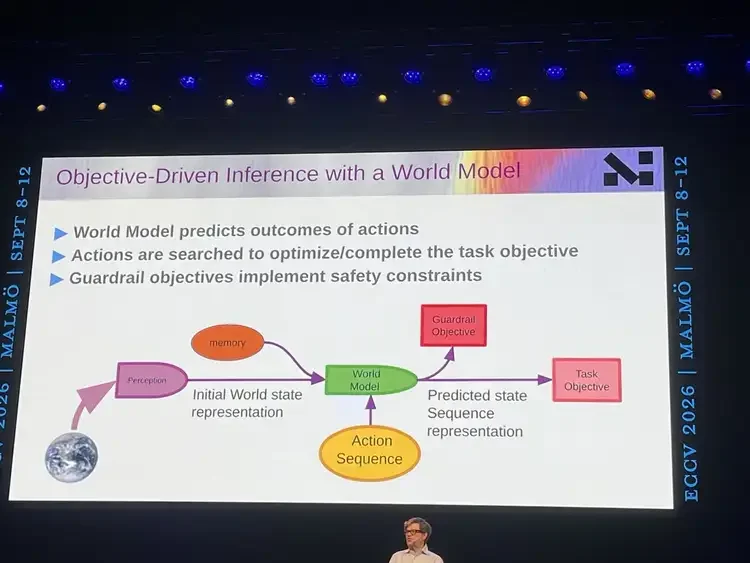
在今年的 Keynote 演讲中,Yann LeCun 对这个问题讲得最直接。
图灵奖得主、前 Meta 首席 AI 科学家 Yann LeCun 在 Keynote 中,把重点直接放在了未来状态预测上。他反复强调,“模型根本就不该去预测像素”。相比生成未来画面的每一个细节,他更关心模型能否在抽象表征中预测未来状态,再根据不同动作可能带来的结果进行规划。机器人真正需要的,也不是一张目标图像,而是一个“目标状态”。
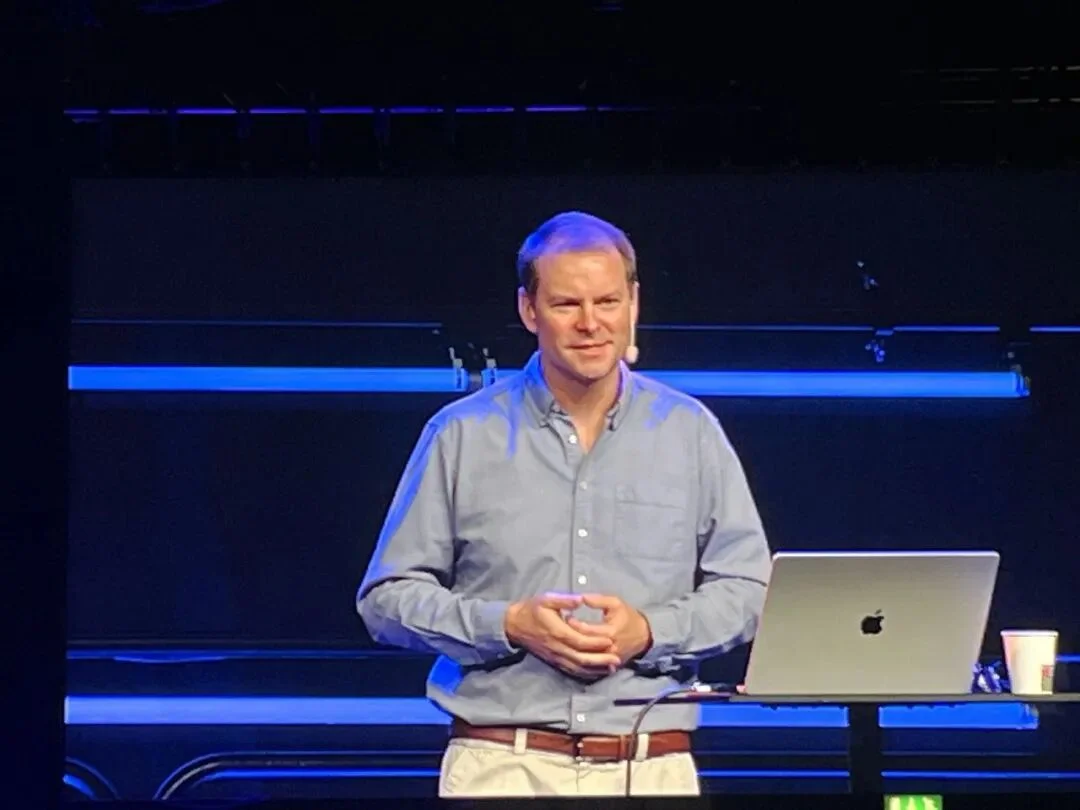
另一场 Keynote 中,Wayve 首席科学家、前微软 Mixed Reality & AI Labs 负责人 Jamie Shotton 则把讨论继续带向了真实世界中的感知和行动。他从早期视觉识别一路回顾到 Kinect的人体追踪、HoloLens的手部感知,再讲到今天的 Embodied AI 和 Wayve 的基础模型。他把自动驾驶作为具身智能的重要试验场:视觉系统真正进入物理世界后,面对的是持续变化的道路环境,也需要从识别和感知继续走向行动。
类似的议题,也反复出现在今年与 3D、世界模型和具身智能相关的 Workshop 中。
斯坦福大学助理教授吴佳俊长期研究世界模型与空间智能,在本届大会的相关分享横跨 Agentic Robotics、Multisensory Reasoning 和 World Model Evaluation;
香港科技大学教授、前阿里巴巴 XR 实验室负责人谭平长期研究三维几何与场景建模,这次也围绕可扩展 3D 场景重建与生成分享了最新工作。
慕尼黑工业大学教授 Angela Dai 也是 3D 场景理解与重建领域的重要学者,她在分享中讨论了如何把真实世界的物理遮挡转化为结构先验,让模型从不完整观测中理解和补全三维空间。
除此之外,哥伦比亚大学助理教授李昀烛、清华大学助理教授高阳、中山大学教授梁小丹等学者,也出现在世界模型相关 Workshop 的演讲阵容中,议题延伸到机器人学习、强化学习和物理一致性等方向。
这些讨论的切入点不同,但整体上,问题正在从“怎样把动态世界表示出来”,继续向“世界接下来会如何变化”推进。
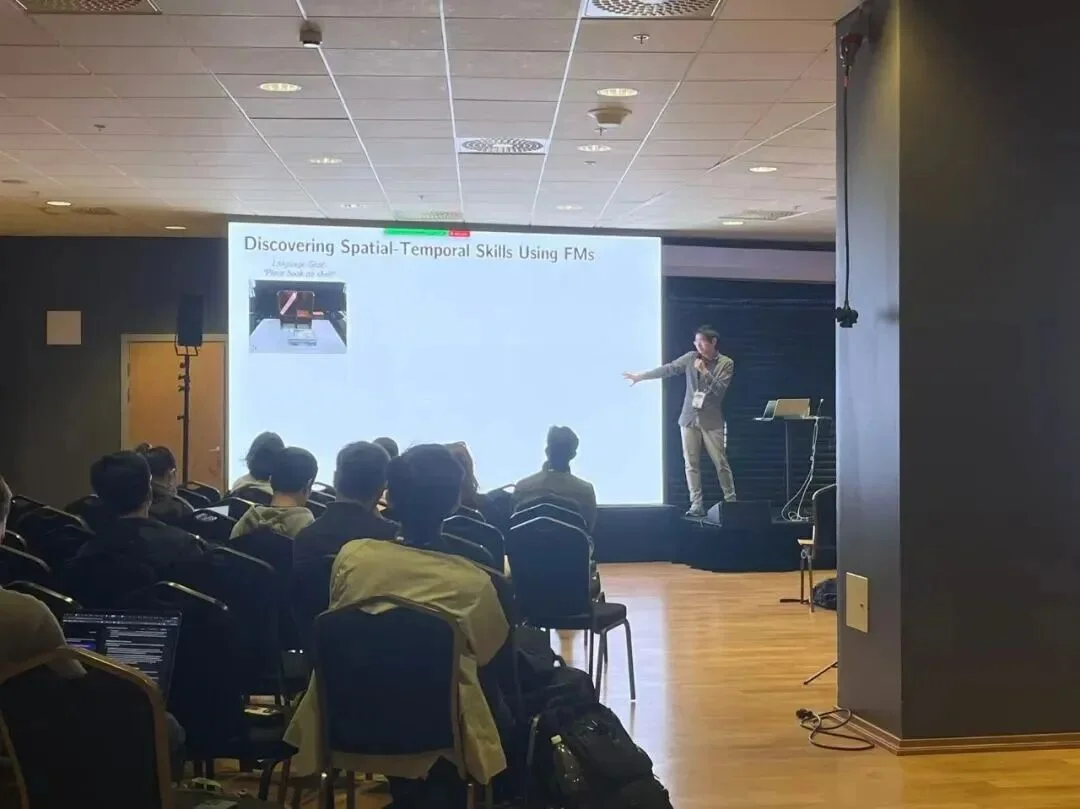
斯坦福吴佳俊ECCV 演讲:机器需要怎样的「世界表示」,才能真正开始行动?| ECCV 2026
不堆 Transformer,斯坦福吴佳俊如何用物理重新定义多模态融合?|ECCV 2026
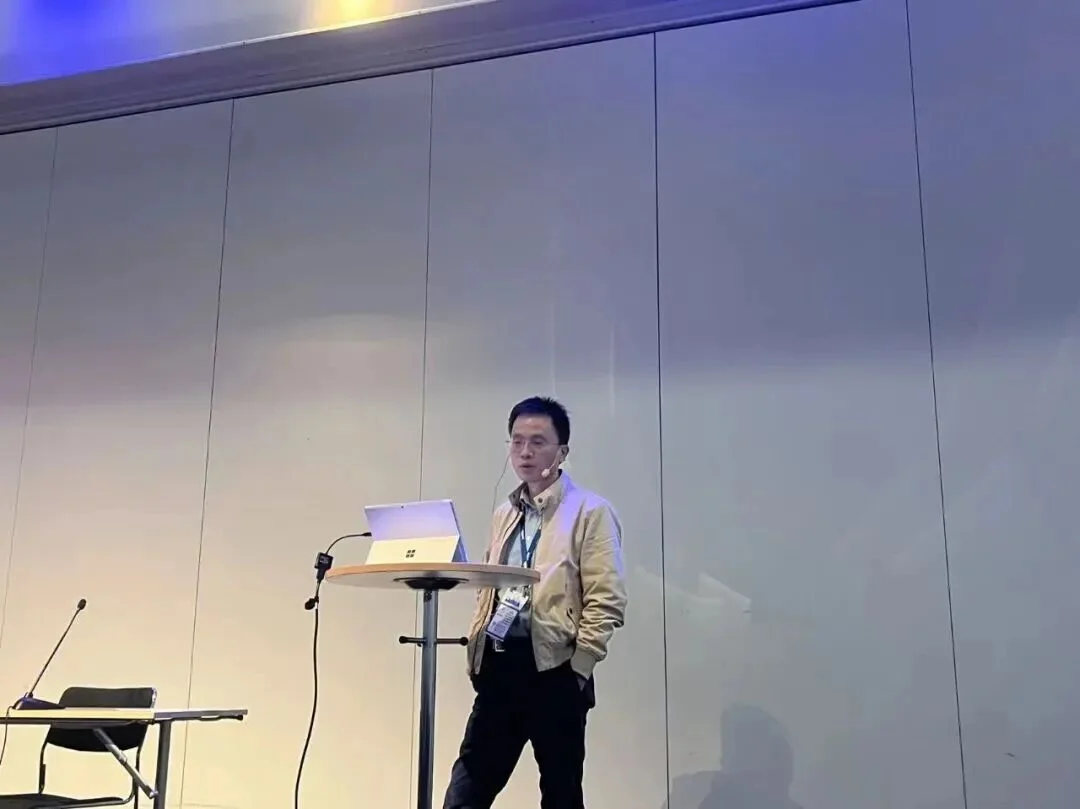
几何的「反攻」!港科大谭平:从局部先验到全局一致,3D 几何如何增强视觉大模型 | ECCV 2026
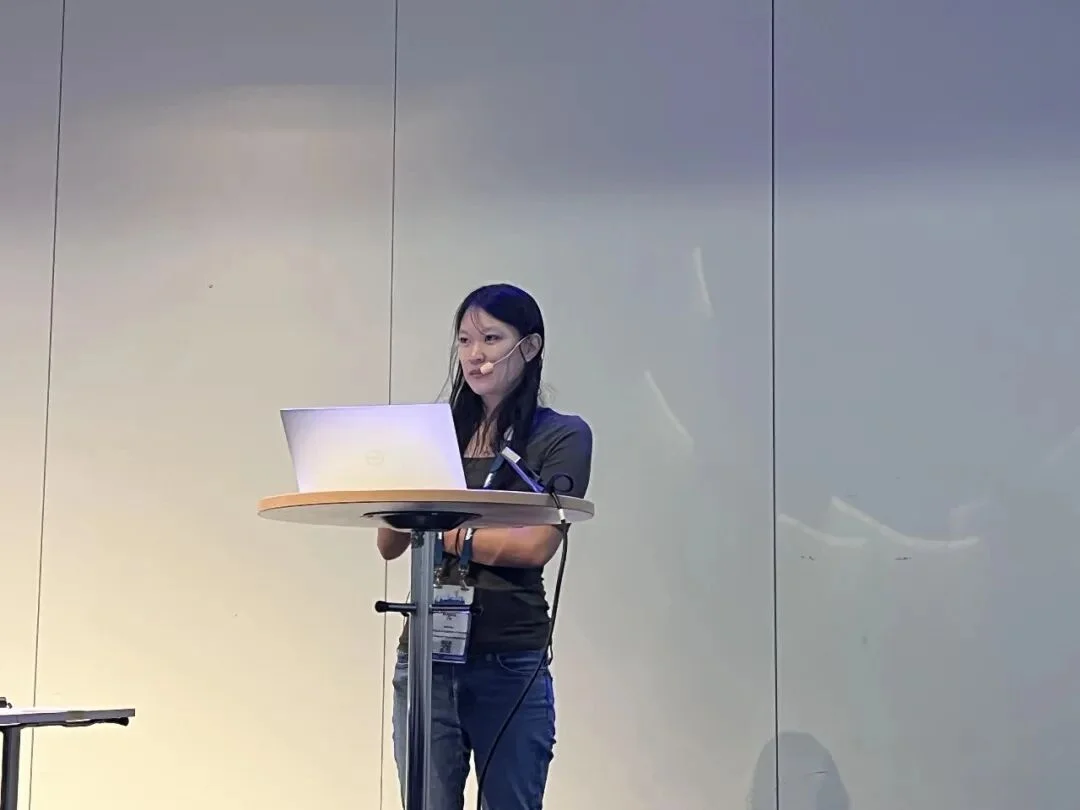
TUM 教授 Angela Dai:放下完美数据执念,「逆向自监督」重构 3D 空间智能 | ECCV 2026
主会论文则把这种变化落到了更具体的方法和评测问题上:
论文 DreamWorld 把三维几何先验接进视频生成,希望生成的世界在不同视角下仍然保持稳定的空间结构;
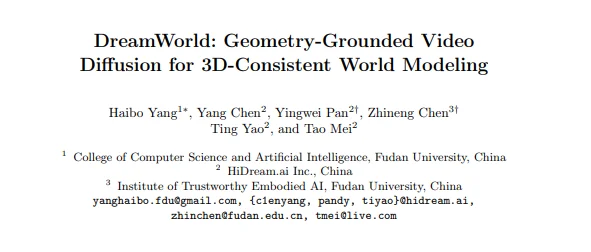
论文链接:https://yanghb22-fdu.github.io/DreamWorld/asserts/DreamWorld.pdf
论文 《Interaction-Aware 4D Gaussian Splatting for Dynamic Hand-Object Interaction Reconstruction 》处理手与物体交互过程中不断变化的四维场景;
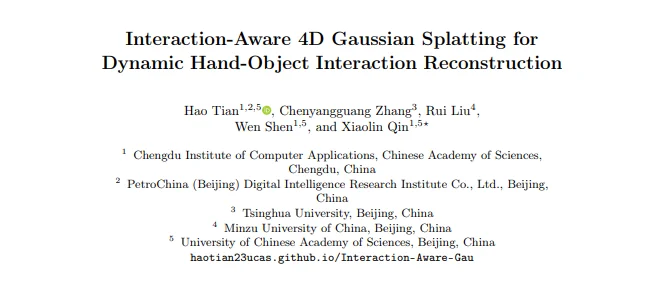
论文链接:https://arxiv.org/pdf/2511.14540
论文《 A Physics-Grounded Benchmark for Multi-Agent Dynamics in World Models》进一步追问,多个智能体相互作用后,世界模型生成的状态变化能否符合真实物理规律。
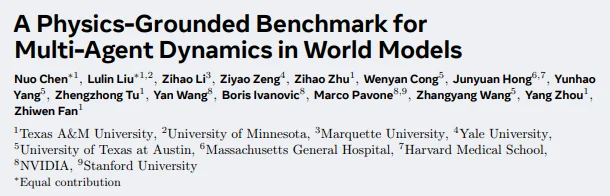
论文链接:https://arxiv.org/pdf/2606.28757
这几项工作对应了三个层次:保持空间一致性、表示动态 4D 场景、预测交互后的状态变化。问题也从“怎样表示变化”,继续走向“怎样预测变化”。
但对具身智能来说,模型仅预测动作会带来什么结果还不够,最终还要把这些理解转成真实环境里的动作。
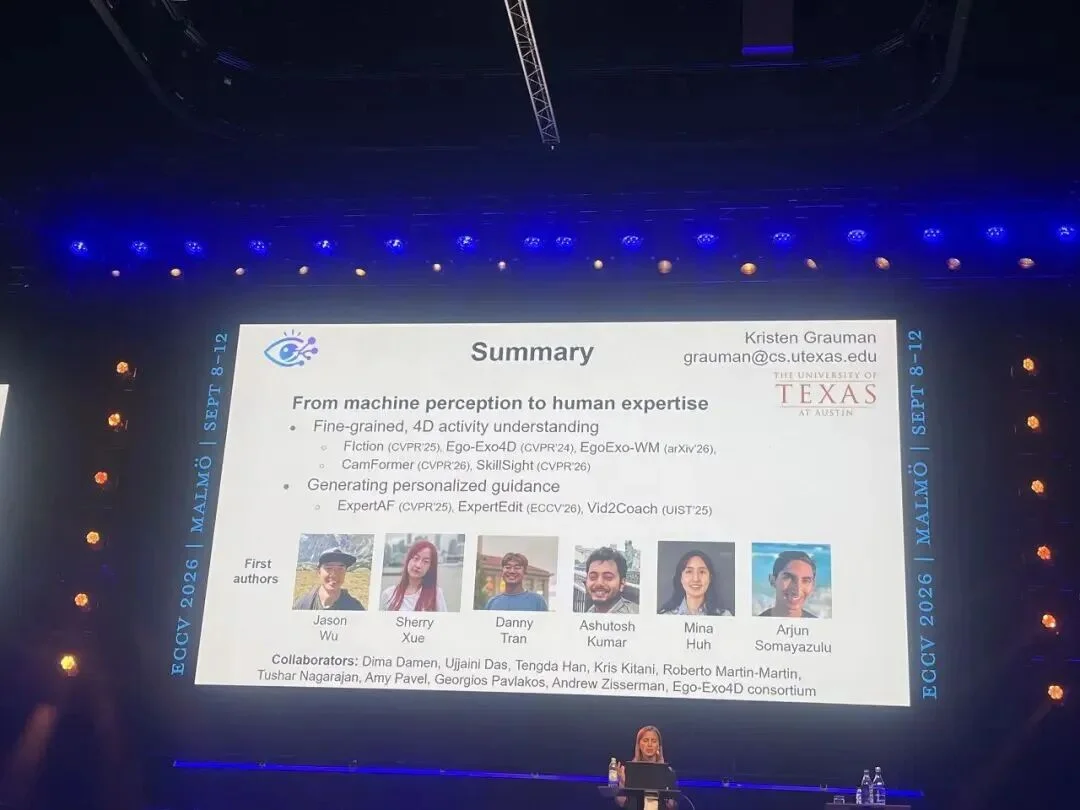
首场 Keynote 演讲中,前 Meta FAIR 研究总监、现任得克萨斯大学奥斯汀分校计算机科学教授的 Kristen Grauman,提出 AI 要从 understanding 走向 enabling,最终成为帮助人学习现实世界技能的
AI Guide。她把问题说得很直接:模型需要弄清“什么样的动作,会把当前状态带到另一个状态”。
但要让模型真正进入真实交互,机器人还需要从更多感官里判断环境状态。
NVIDIA Research 科学家李柏依在 workshop 分享了两项工作。MultiGen用生成模型给仿真视频补上声音,让机器人在倒水等任务中借助音频判断物理状态;DexImit 则从单目人类操作视频中恢复手物交互,把人类示范转成双手机器人训练数据,覆盖工具使用、长程任务和精细操作等场景。
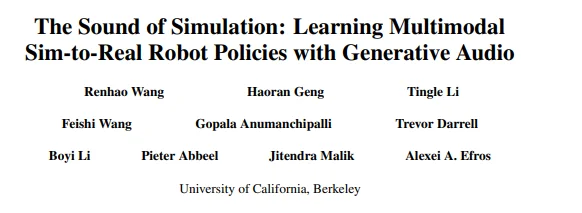
论文链接:https://arxiv.org/abs/2507.02864
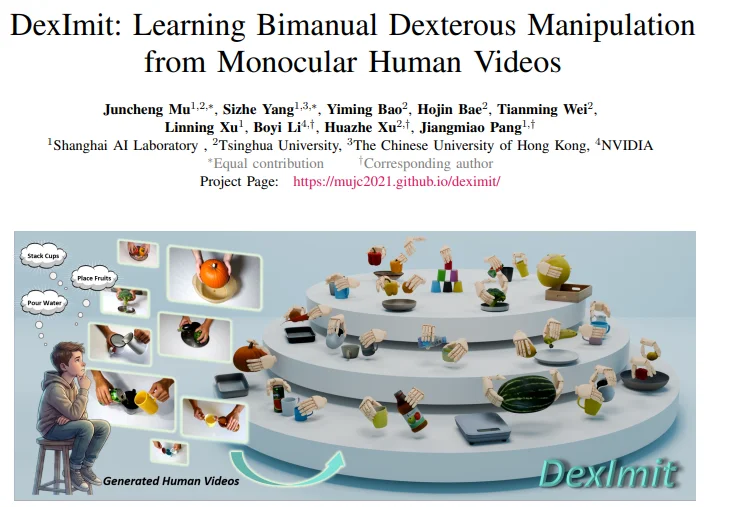
论文链接:https://arxiv.org/pdf/2602.10105
有了对物理状态和手物交互的理解,下一步就是让动作在三维空间里真正展开。对机器人来说,知道“水壶在桌子的右边”还不够。它还要判断水壶离自己多远,从哪个方向接近,中间有没有障碍。
北航、北大、智源和中科院自动化所等团队提出的 RoboTracer,处理的就是这个问题。它让模型同时理解空间指称和真实物理尺度,再把语言指令转成一条带有深度和距离信息的多步 3D 轨迹,交给下游运动规划器执行。轨迹采用图像坐标加绝对深度的方式表示,因此可以接到不同机器人本体上。
论文链接:https://arxiv.org/pdf/2512.13660
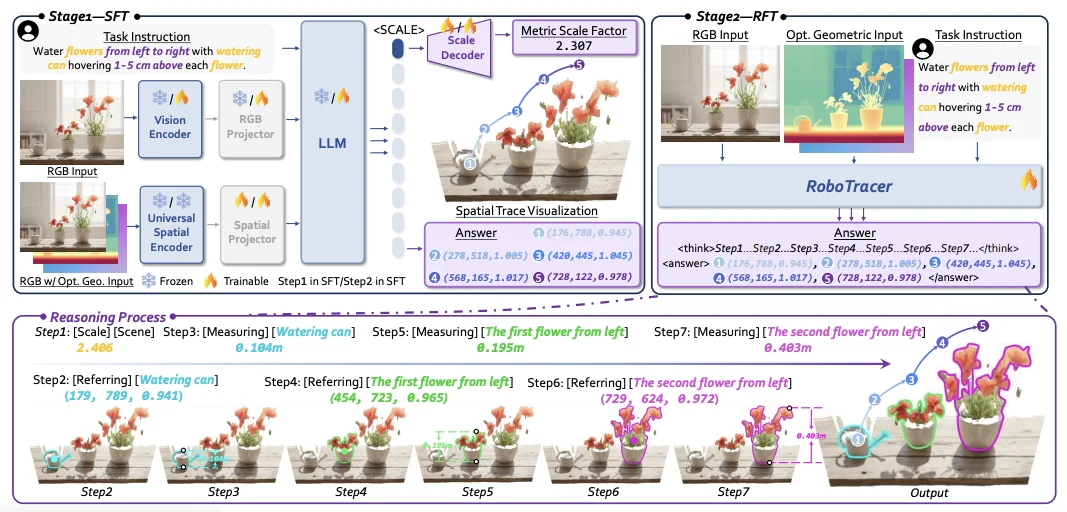
RoboTracer 总体架构与 Step 1-7 多步感知推理示例
空间轨迹解决了“往哪里走”,但物理动作还涉及一个更直接的维度:接触力。主会 Oral 中的 FEEL(Force-Enhanced Egocentric Learning)将第一视角视频与手部受力信号同步起来,构建了约 300 万帧力同步数据,用于理解接触和物理动作。
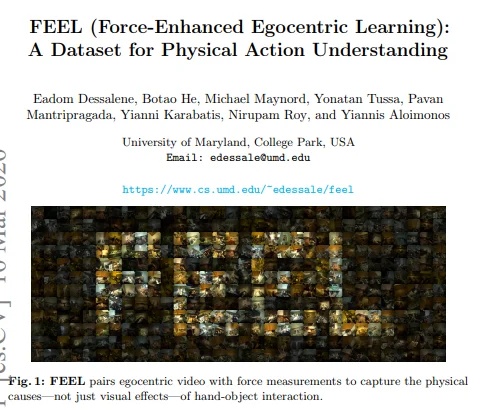
论文链接:https://arxiv.org/pdf/2603.15847
感知、轨迹和力信号要真正训练起来,还需要一个可以大规模反复练习的环境。SPEAR 把 Unreal Engine 做成可编程的具身仿真环境,支持行人、车辆、四足机器人等多类智能体,也可以和物理引擎协同运行,为感知和动作训练提供虚拟三维场景。
论文链接:https://arxiv.org/pdf/2607.06701
从多感官感知,到空间轨迹与力,再到可反复试错的仿真环境,这些工作最终都指向同一个目标:让模型对环境的理解,真正变成可以在三维空间里执行的动作。
把前面的工作放在一起看,方向已经很清楚。3D 视觉开始处理更复杂的动态场景,长时记忆要维持对同一环境的持续认识,世界模型关注状态变化和动作后果,具身智能还要把这些理解接到规划和行动。
这些方向最终都指向同一个目标:让 AI 能够持续理解一个会变化、会交互的物理世界。
这些工作进一步推进,也都触及一个更基础的问题:究竟应该建立在怎样的世界表示之上,尤其是空间结构应该如何表示。
围绕这个问题,相关讨论早在大会前就已出现在社交媒体上,并一直延续到 ECCV 期间和会后。
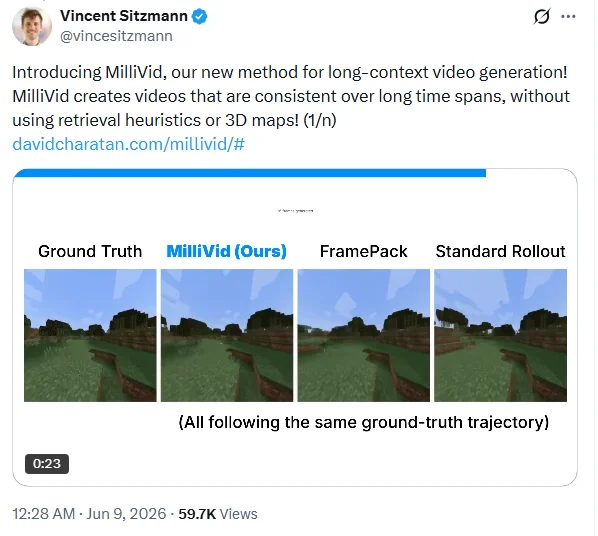
今年 6 月,MIT CSAIL 副教授 Vincent Sitzmann 在 X 上发布 MilliVid(长时视频生成模型)时,就展示了一种不同思路:视频模型可以在不依赖 3D 地图的情况下维持长时场景一致性。
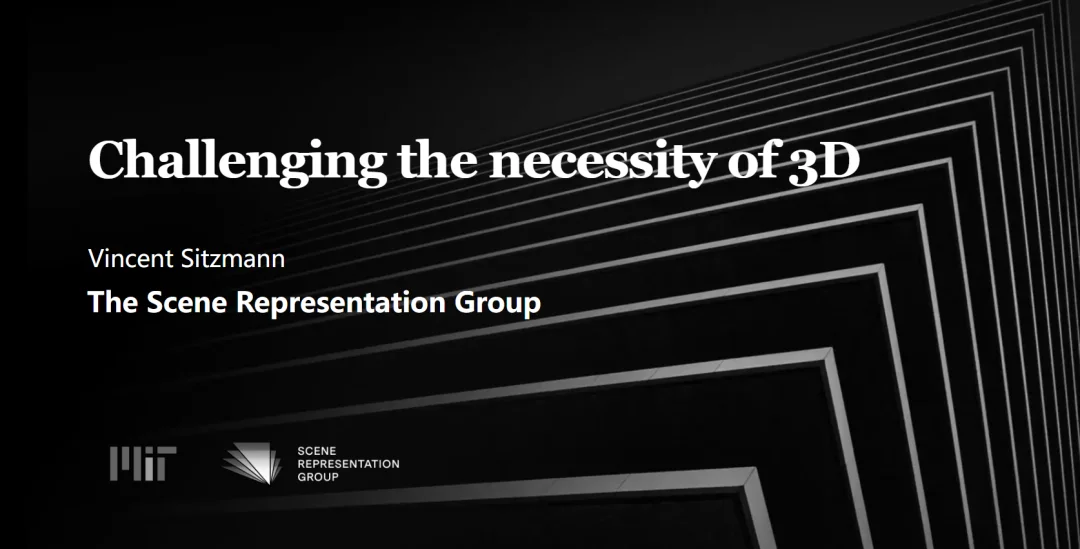
ECCV 会议期间,他又连续参加了多场与 3D、视频模型和世界模型相关的 Workshop,并在 Wild3D 以 “Challenging the Necessity of 3D” 为题发表演讲,把“显式 3D 是否仍然必要”这一问题直接带到了现场讨论中。
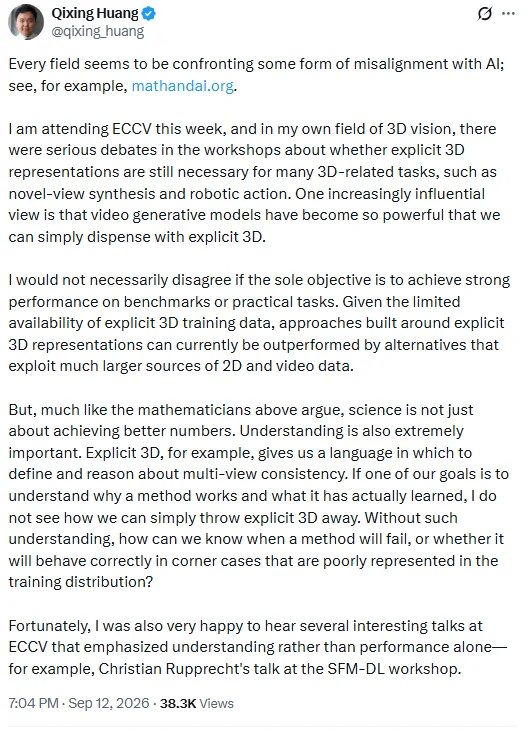
到了 ECCV 期间,长期研究 3D 视觉和计算机图形学的得克萨斯大学奥斯汀分校副教授黄启兴(Qixing Huang) 也在 X 上谈到了同一个问题:随着视频生成模型越来越强,显式 3D(如点云、网格、3D Gaussian 等)表示是否仍然必要。
在他看来,如果只追求 benchmark 或实际任务表现,利用海量 2D 和视频数据的方法可能更有优势;显式 3D 仍然提供了一套定义和推理多视角一致性的方式,也有助于理解模型究竟学到了什么。
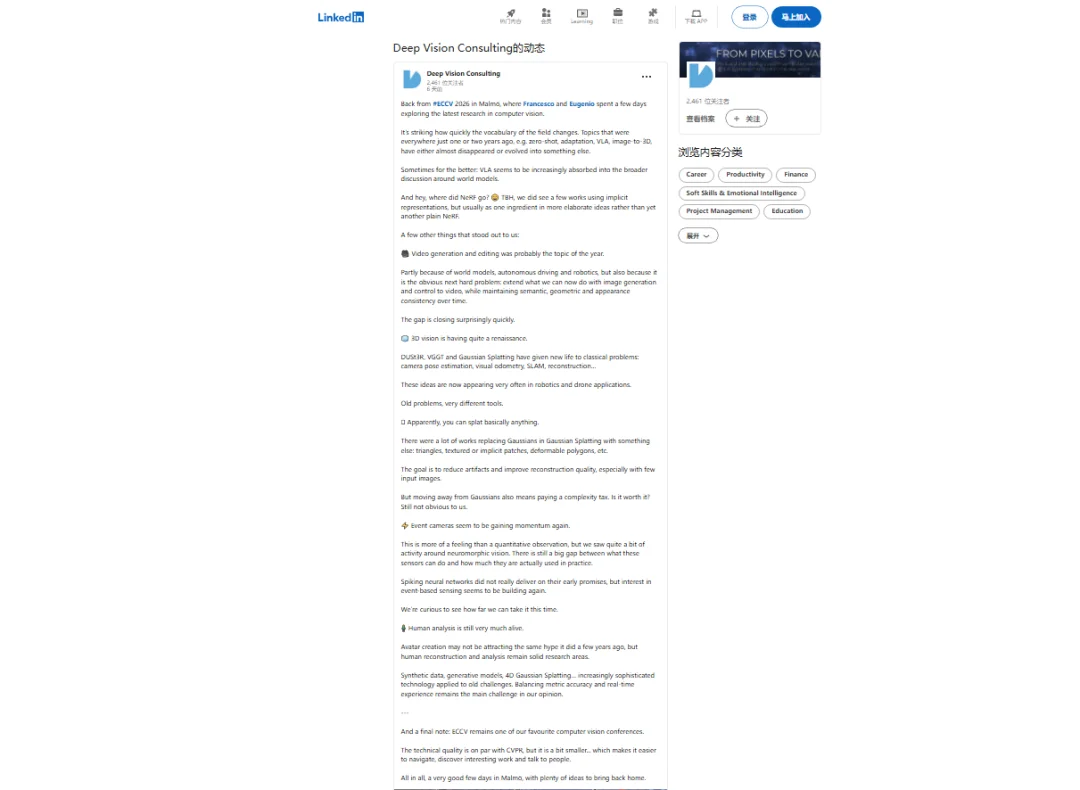
大会结束后,相关讨论仍在继续。长期从事计算机视觉、3D 视觉和机器人技术的意大利团队 Deep Vision Consulting 在领英分享了他们对本届 ECCV 的观察:视频生成与编辑成为大会很突出的方向,并与世界模型、机器人结合;3D Vision 也重新活跃起来,DUSt3R、VGGT 和 Gaussian Splatting 等方法让相机位姿估计、SLAM 和三维重建等经典问题再次受到关注。
可以看到,空间表示目前还没有收敛到一条路线。视频模型正在尝试把更多空间结构学进内部表征,显式 3D 也仍在持续发展。但无论最终采用怎样的表示,AI 要真正进入物理世界,都需要持续理解空间、判断状态变化,并进一步完成预测和行动。
技术路线还在变化,但空间智能作为 Physical AI 基础能力的重要性,正在变得越来越清晰。
文章来自于"AI科技评论",作者 "张岂萍"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】DeepBI是一款AI原生的数据分析平台。DeepBI充分利用大语言模型的能力来探索、查询、可视化和共享来自任何数据源的数据。用户可以使用DeepBI洞察数据并做出数据驱动的决策。
项目地址:https://github.com/DeepInsight-AI/DeepBI?tab=readme-ov-file
本地安装:https://www.deepbi.com/
【开源免费】airda(Air Data Agent)是面向数据分析的AI智能体,能够理解数据开发和数据分析需求、根据用户需要让数据可视化。
项目地址:https://github.com/hitsz-ids/airda
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
