
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
具身智能赛道,苦数据久矣。
难题远不止数据短缺。真机采集昂贵、耗时,规模化落地门槛很高;好不容易拿到物理交互样本,距离真正转化成机器人能力,依然隔着很长一段距离。
该怎么走,行业玩家给出了不同解法。
国际上,Tesla Optimus依托工厂场景的真机遥操快速积累万级episode数据;Figure AI与英伟达则大力押注仿真合成与世界模型,试图以「数字孪生」突破物理采集的成本瓶颈。
国内,头部具身智能企业也纷纷自建数据工厂,从UMI手持采集到EgoCentric第一视角视频,希望扩大可用数据的来源和规模。
为什么大家都这么重视数据?因为没有足够的数据,很难涌现出真正的智能。
但具身智能的数据问题,可不是盯着数据本身就够了。
AI正在从Intelligence走向Action。
进入物理世界之后,具身智能形成了一个很典型的三角关系:算力驱动数据加工,数据喂养模型,模型又持续消耗算力。
三者首尾相接,构成一个持续运转的「数据飞轮」。
但这只飞轮天然带着一个「鸡生蛋」难题:模型需要好数据,好数据又需要更强的模型。
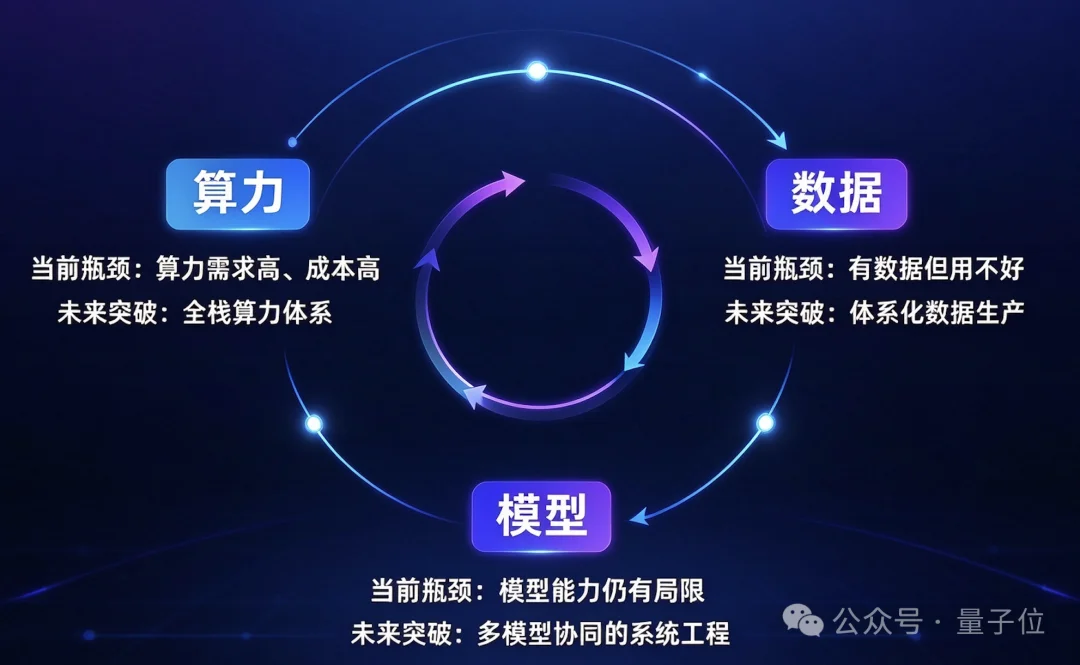
于是,具身智能的数据问题,也从「怎么多拿一些数据」,变成「怎么让算力、数据和模型真正循环起来」。
「数据飞轮」该怎么高效运转?
特别是当机器人数量从几十台走向几百台、几千台,且真机、仿真、视频、点云和动作数据同时涌入时,飞轮要如何转动,才能持续保障模型迭代速度?
9月23日,在「2026云栖大会」的具身智能论坛上,我们看到了几个越来越集中的行业判断:
想要让「数据飞轮」真正向前推进,需要的是一套覆盖数据、模型、训练到算力的全栈工程能力。
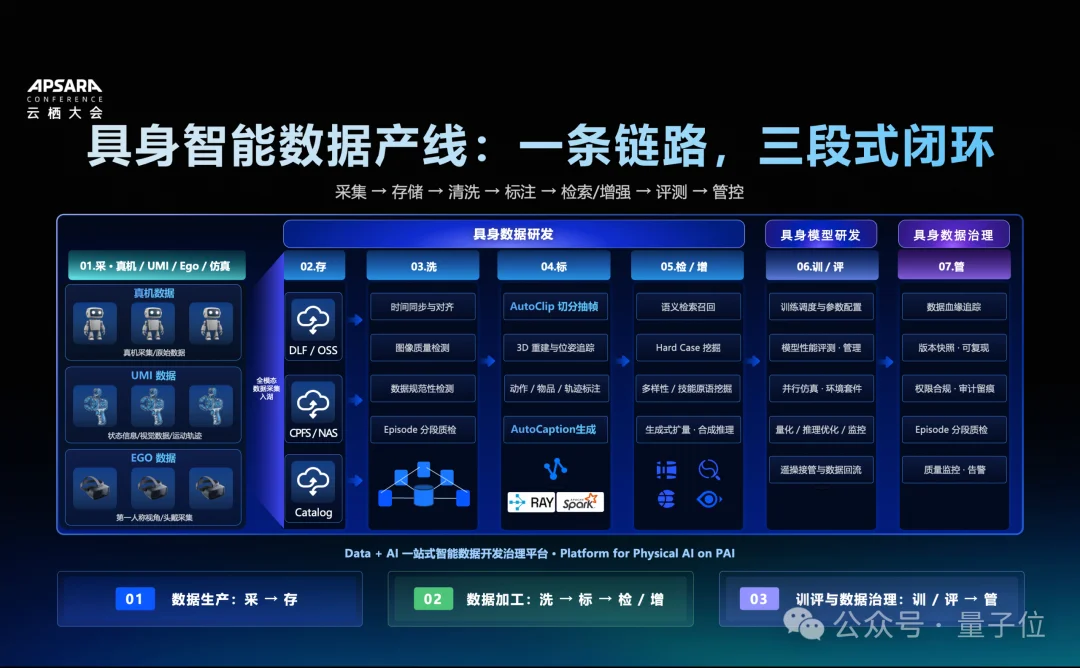
其中,数据侧首先要建立起一条完整的「数据产线」:从采集、存储、清洗、标注、质检与增广、训练评测,再到数据管理和反馈回流。
这七个环节,基本覆盖了具身数据从原始素材变成模型能力的全过程。
而且,每一环都有自己的难点。
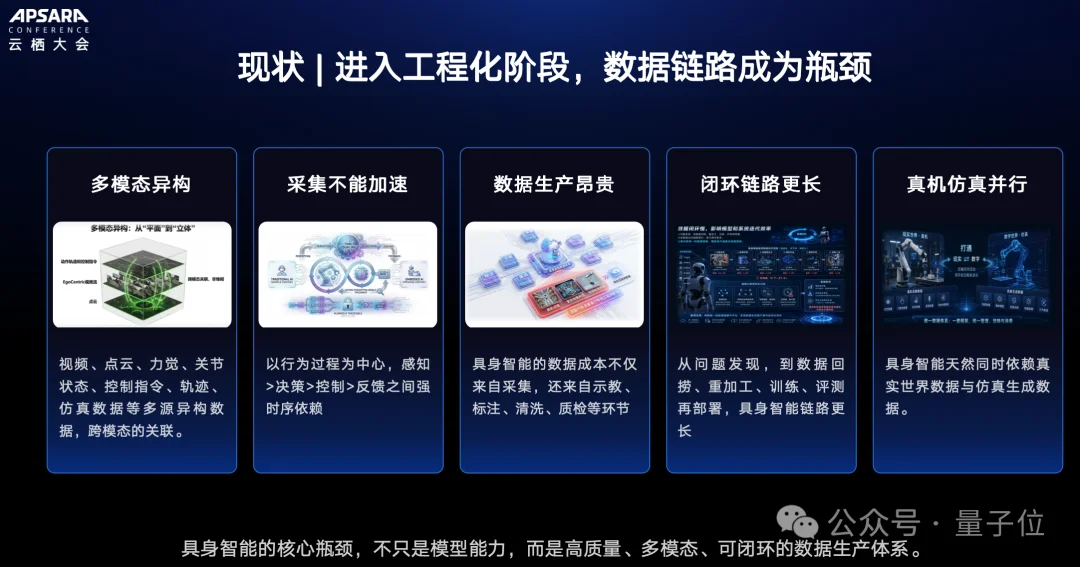
采集要在精度、规模和成本之间取舍,不同来源的数据需要统一采集入湖。
清洗涉及视频、点云、轨迹等多模态数据的大规模处理。
再看数据标注。
传统方法是给图片框选目标、补充类别。
但具身数据复杂得多。一段机器人操作视频,往往需要识别动作发生的时间边界、判断左右手或机械臂归属、理解操作对象、完成动作语义描述,还可能涉及位姿恢复、多视角对齐和复杂动作拆分。
因此,现阶段的数据标注,越来越依赖模型参与。
比如,AutoClip调用Qwen模型实现动作片段自动切分,AutoCaption调用Qwen模型生成语义描述。
对于特定场景的高精度标注需求,基于基模+客户数据后训练领域模型,也正在成为提升标注精度的路径。
标注之后,还要继续做质检与增广。
哪些样本存在问题,哪些Bad Case需要人工介入,可以通过样本质量筛选继续处理;对于数据不足的部分,也可以通过生成方式进一步扩充。
到了训练这一端,问题则变成这些数据能不能「及时」进入模型迭代。
训练侧需要分布式训练平台承接模型开发与评测,并通过训推加速框架压缩工程开销。
训练结束,还不是终点。
“对于具身来说,幻觉是灾难性的。”无界动力联合创始人兼CTO夏中谱在论坛上表示。
机器人最终要在真实世界里做决策和动作,模型有没有学到正确的物理关系,不能只看训练loss,还要回到真实任务里验证。
针对评测中暴露出来的Bad Case,还要重新回到前面的筛选、补采、清洗和标注,成为下一轮数据生产的起点。
至此,一圈飞轮才算真正跑完。
围绕这条数据产线,以阿里云为代表的云厂商已经开始补齐对应工具——从大规模数据处理、大模型参与标注,到分布式训练与评测平台,工具链正在逐步完善。
现在,数据飞轮长什么样,已经基本清楚了。
支撑它的七个环节,任何一个地方卡住,压力很快会传导到下一环。
接下来要解决的,是整条链怎么一起跑起来。
在具身智能实际研发环境里,七个环节的卡点很少孤立出现。
清洗慢,背后可能是计算资源无法弹性扩展;标注堵住,可能是数据和模型系统没有打通;训练一直等数据,又可能是前面的存储、处理和调度吞吐跟不上。
七个环节暴露的是不同症状,背后指向的却是几类相同的系统性问题。
一个是环节割裂。采集、数据处理、仿真和模型训练往往由不同团队、不同系统承接,数据来回搬,反馈也很难快速回到上一环。
另一个是工具不打通。自研脚本、标注平台、训练集群各自能跑,但任务触发、数据版本、模型版本和血缘关系没有真正接起来。
再有,规模化之后的吞吐瓶颈。数据从几百小时涨到几千、几万小时后,最慢的一环很快就会变成整条飞轮的上限。
对于「数据越多,模型就一定越强」这件事,行业也开始变得谨慎。
论坛上,原力灵机联合创始人范浩强直言:“加数据涨点,这不是必然的。”
对具身智能来说,问题可能已经不只是数据规模。模型结构、评测方式,以及能不能真正学到物理因果,都还没有完全解决。
无论数据来自哪里,七大环节的工程挑战也高度相似。
具身智能今天缺的,是这一套覆盖数据、模型、训练到算力的「全栈工程能力」。
科学的天花板,一定要有工程能力作为基础。
阿里云承接的,正是这条链上各环节之间的衔接工作。
数据侧,采、存、洗、标、质检与增广需要被组织成连续的数据生产流程。
标注端,Qwen负责识别,HappyHorse通过视频生成进行数据增广。DataWorks/Argo Workflows则把上述工具编排为连续流水线,让数据在加工与训练之间不再需要人工中转。
这一步很关键。
具身数据复杂度越来越高,单靠人工很难跟上规模。模型参与越深,数据处理、标注和质检才有机会真正走向自动化。
再往后,是训练和评测。
前端数据生产速度提上来之后,后端训练系统也要同步承接,否则前面生产得越快,后面积压得越多。怎么接住?
阿里云人工智能平台PAI,承接分布式训练与评测,与前端数据生产直接打通;PAI-TurboX等高性能加速组件,继续压缩训练和推理过程中的工程开销。
到了最底层,则是算力。
具身智能同时包含数据处理、仿真、预训练、微调、评测和推理,对底层计算的需求越来越重。
平头哥真武AI芯片提供训推一体能力,并通过M890超节点架构组成超节点服务器,承接更大规模的训练和推理任务。
据阿里云方面披露,平头哥真武810E芯片已经在具身智能赛道出货超过万片。
由此,一条「芯、云、模」协同的技术栈开始形成,从Qwen参与标注,到HappyHorse生成增广数据,再到DataWorks编排流水线、PAI完成训练——这些能力需要协同运转,才能真正压缩飞轮一次完整周转的周期。
据了解,阿里云提供的一体化数据与训练体系,已经可以把具身智能企业日常训练中的部分反馈迭代周期,从周级压缩到日级。
由此可见,不管数据从哪里来、技术路线有几条,底层工程需求已经率先一步收敛了。
飞轮是一整套系统,但真正落到企业研发里,不同技术路线的重点并不一样。
更值得看的,是一些企业已经根据各自业务重心,率先把数据飞轮里的关键几环跑顺了。
穹彻智能就是一个典型案例。
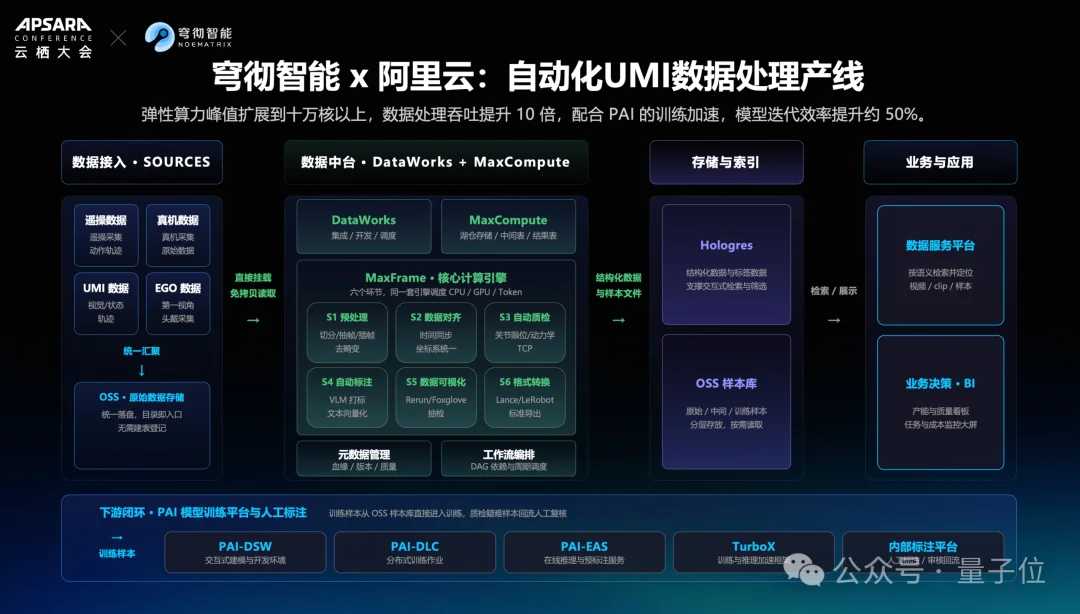
为了研发具身预训练模型,他们采用自研的Robopocket无本体数据采集方案在真实场景中采集操作数据,覆盖不同的场景、物体和任务,数据多样性丰富。这也对后续加工处理提出了更高要求。
原始数据进入系统后,首先要经过时间戳对齐、视频编解码、分辨率与帧率转换;随后又要经过数据质量检测与数据标注。
因此,在模型研发链路中真正影响效率的,是原始数据多久能变成模型可直接使用的样本。
穹彻的数据处理流程中,阿里云为穹彻提供充足的弹性资源、MaxCompute MaxFrame承担分布式计算、千问大模型参与自动打标,三者配合将原本分散的处理步骤整合为高效的连续产线。
目前,约80%-90%的标注工作可以由AI完成,人工主要处理复杂Bad Case。标注完成后,数据进入穹彻世界动作模型Noe的训练管线。
也就是说,采集、处理、标注和训练开始真正接成一条连续链路。据悉,基于这套体系,穹彻已经推出世界动作模型Noe-0。
苏度科技则展示了另一种实践。
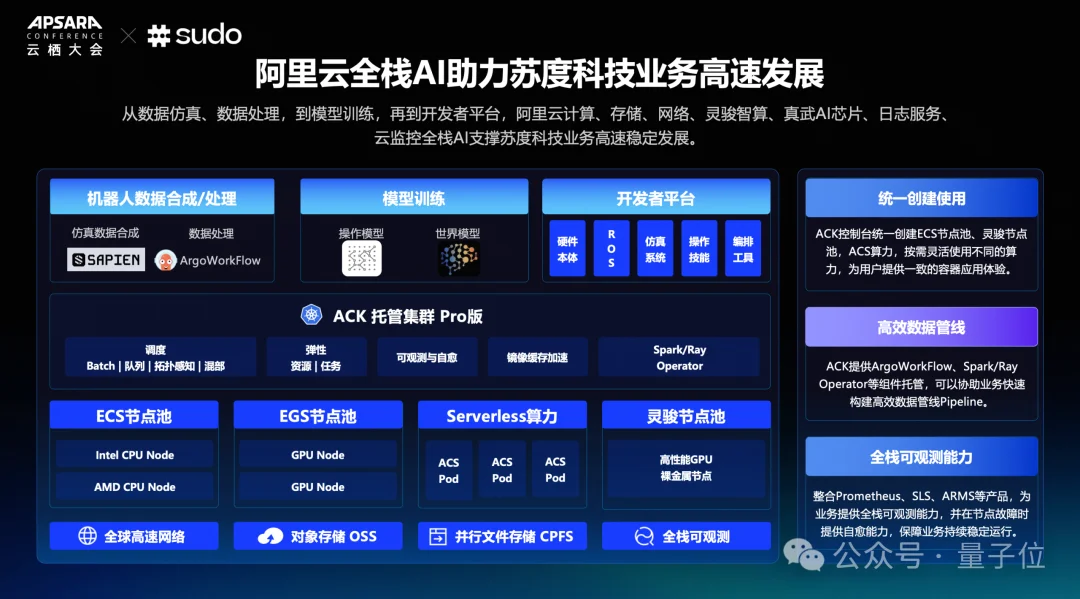
苏度采用「虚实融合」路线, 其中的real2sim2real技术,通过高保真仿真生成训练数据,再把模型迁移回真实世界。它要解决的核心问题,是仿真数据怎样持续生成、处理,并稳定进入模型训练。
因此,苏度基于阿里云搭建了数据仿真、质检、标注、分割、增强的全链路数据产线,并利用多模态模型提升标注和数据处理效率。
数据生产速度一旦提高,压力也会自然传导到训练端。
苏度进一步使用真武810E芯片作为核心训练算力,在提升模型训练效率的同时降低TCO。
训练吞吐的重要性,也能从莫刻机器人的实践中得到印证:
其使用2台、32卡平头哥真武810E完成世界模型预训练和继续训练,并取得WorldArena榜单第二。
这说明,前面的数据产线跑得再快,训练端也必须具备足够的吞吐能力,把持续产生的数据及时消化掉。
否则,飞轮仍旧无法高效转动,问题只会从数据处理环节继续向后转移。
穹彻、苏度、莫刻只是企业实践的三个侧面,却已经能拼出一个越来越清晰的趋势:
具身智能的数据竞争,正在从单个环节的能力比拼,走向整条数据飞轮的工程化协同。
谁能把整条飞轮转得更快,谁就能更快把数据变成能力。
具身很新,数据形态也很新,但这套「数据→模型→反馈→再生产」的工程命题,行业早就做过两遍。
自动驾驶先跑过一轮,大模型又跑过一轮。
两条赛道技术对象不同,却经历了相似的阶段变化。
早期大家更关注模型本身够不够强、手里的数据够不够多。等数据和任务规模真正上来以后,竞争很快从「有多少」转向「能不能持续生产」。
自动驾驶要不断从真实道路中发现corner case,再回收数据、重新训练、评测和部署;大模型同样需要持续完成数据清洗、合成、训练、评测和反馈回流。
到了Agent阶段,这条循环进一步拉长,任务执行本身也开始反过来生产新的训练数据。
浙江大学教授、影溯科技创始人章国锋在论坛上提到一句很关键的话:
做出一批效果好的数据,跟持续稳定地规模化生产高质量数据,其实还不一样。
真正进入规模化阶段以后,问题已经从「能不能做出一批好数据」,变成「能不能持续生产,而且规模起来之后,质量还不掉」。
真正拉开差距的,也就变成了一套能持续把新数据变成新能力的工程系统。
这套Data+AI工程能力,阿里云已经在自动驾驶和大模型里锻炼过。到了具身智能,数据更复杂、链路更长,但底层工程方法仍然可以复用。
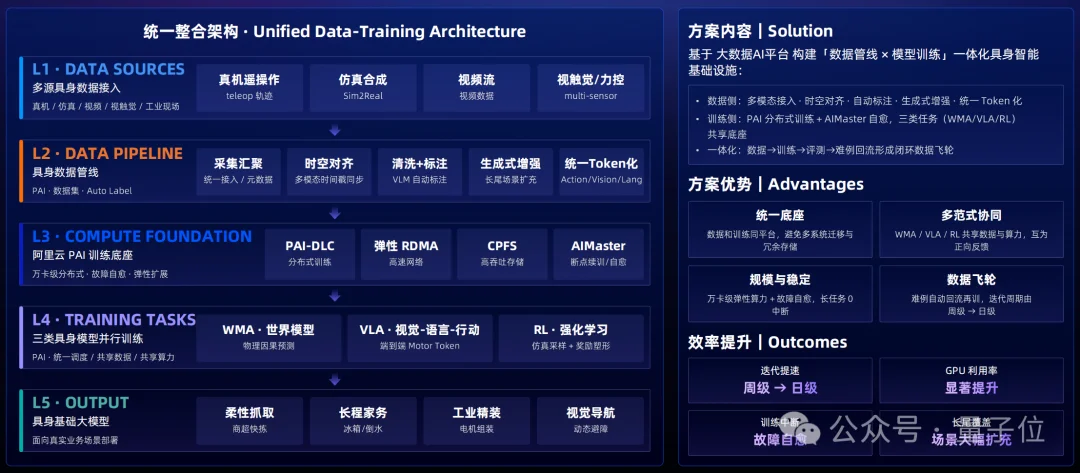
背后的方法论,可以概括成12个字:一份数据、多类模型、一站训练。
换句话说,一份数据,不再只对应一次训练,而是可以在不同模型之间流转和复用;训练也不再是链路终点,评测暴露出来的问题还要继续回到数据侧,决定下一轮该补什么、怎么补。
这也把具身智能的数据竞争推向了下一个阶段。
过去大家容易比存量。谁有10万小时,谁有100万条episode,谁的数据工厂规模更大。
但简智机器人副总裁雷腾指出,当前具身行业最被高估的,就是「数据小时数」。真正被低估的,是「数据治理」。
同样是10万小时数据,生产成本可以相差1到2个数量级,市场价格也能相差1到2个数量级。
所以,到了这一阶段,衡量模型迭代速度,需要看另一组指标:
每天能新增多少有效数据,原始数据多久能变成训练样本,模型一次失败多久能反馈到下一轮数据生产,一批新数据又多久能重新进入训练。
这比的,是产能。
这里的产能,也不等于采集速度。它衡量的是整条飞轮一次完整周转的效率。
从Intelligence到Action,AI真正进入物理世界之后,Scaling Law已经换了一种写法。
参数可以继续涨,数据可以继续堆,但具身智能真正开始比拼的,是把真实世界的问题转化成下一轮模型能力的速度。
数据飞轮的转速,正在决定具身AGI到达的速度。
文章来自于微信公众号 “量子位”,作者 “量子位”


【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
