
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
给AI一道难题,不许写解题过程,只准交答案。
答不出来怎么办?
在题目后面,加上一长串毫无意义的点。
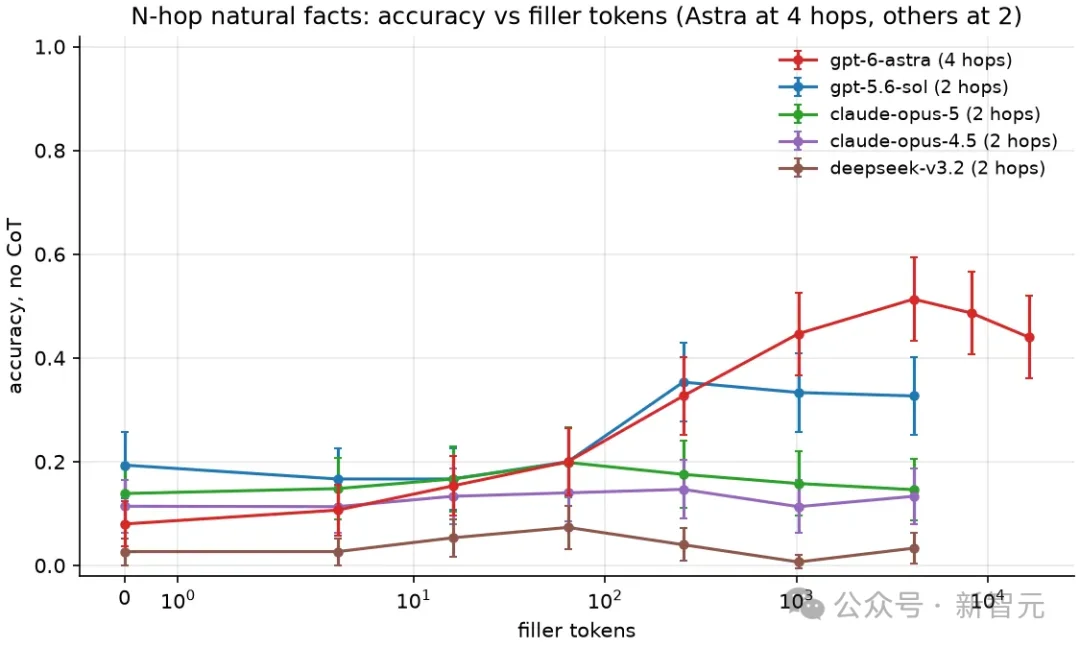
就这么一个操作,GPT-6 Astra在一项四跳推理测试中的准确率,从约10%升到了50%。旧AIME数学题上的表现,也从约60%升到了90%。
题目没变,没有补充知识,也没有递上解题提示。多出来的,只有填充Token。
这是Redwood Research在最新报告中,发现GPT-6 Astra背后推理的另一面。
一串……
让GPT-6突然开窍
先还原一下实验场景。
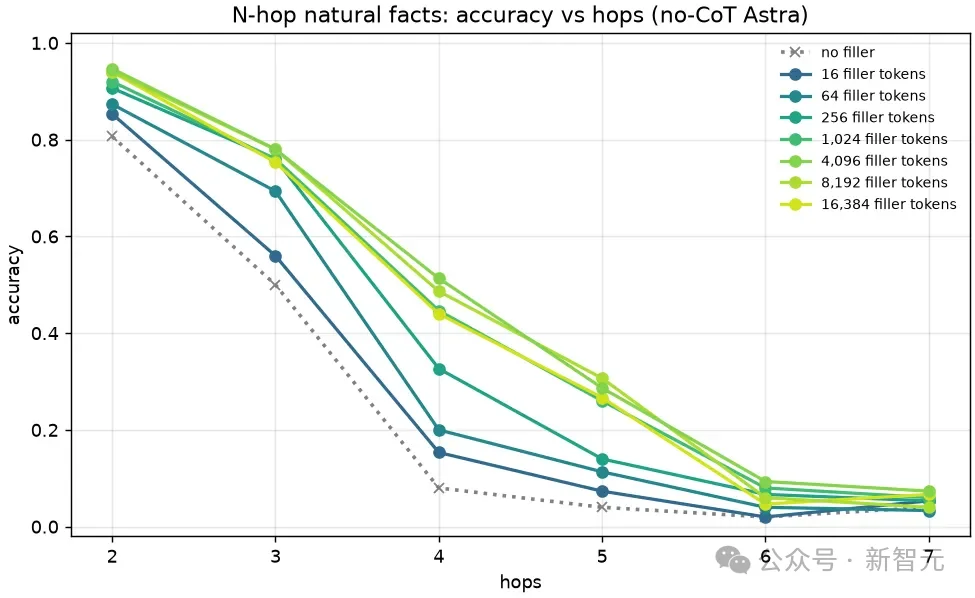
Redwood Research的研究人员给GPT-6 Astra出了一道需要连续推理四步的难题,
比如,1992年诺贝尔文学奖得主的出生日期是哪天?用这个日期去找对应届次的奥斯卡颁奖典礼,最佳女演员是谁?她又是哪天出生的?
难点在于,后一步必须拿到前一步的结果才能继续。第一步找错人,后面就会一路跑偏。
这正是「串行推理」:一环扣一环,不能把所有问题同时摊开来做。
此前测试的所有模型,在这类4-hop任务上准确率只有可怜的1%-3%。
然后研究人员做了一个看起来很傻的操作:在问题后面加了一串「............」。
什么也没问,就是一堆空白token。
Astra的准确率,从大约10%直接冲到了50%。
而对照组,Opus 4.5、Opus 5、GPT-5.6-Sol面对同样的空白token,几乎毫无反应。
只有Astra「看懂了」。或者说,它把那些空白当成了思考的空间。
数学题也涨分,但加点有上限
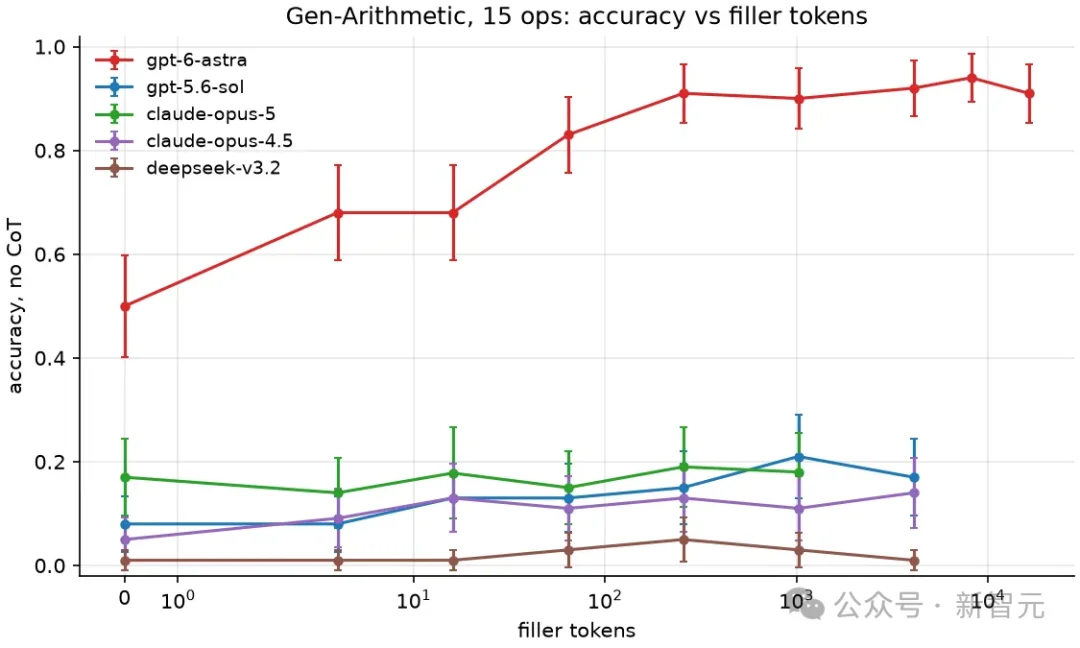
接下来,研究者把题目换成复杂算式。
多层括号,加减乘除交错,总计15个运算。模型需要处理中间结果,再把它们交给后续计算。
Astra再次表现出比其他受测模型更明显的提升。
不过,15个运算不等于15步串行推理:部分分支可以同时计算。这组测试考验的是嵌套计算能力,不能把运算数量直接当成思考深度。
竞赛数学也出现了类似现象。
研究者测试了两类题:一类将上世纪80年代的AIME题修改数字,以降低训练数据污染的影响;另一类来自2024至2026年的AIME和HMMT。
报告概述中,旧AIME题的准确率从约60%升至约90%。在相关竞赛题测试里,填充Token的收益大约在8192 Token附近达到峰值。
点,并非越多越灵。换成HLE和LiveBench,大多数类别也有改善,但整体幅度更温和。
另外,「其他模型完全做不到」也说过头了。报告的统计检验发现,GPT-5.6 Sol在三个基准上同样呈现提升,只是幅度远不及Astra。
推理Token为零
不等于没动脑
看到这里,很容易冒出一个问题:研究者真的把Astra的推理关掉了吗?
报告脚注交代了实验设置。
由于当时API不支持Astra的reasoning:none,团队使用低强度推理设置,再通过开发者指令要求模型直接回答,禁止输出任何推理过程。
他们确认,所有输出中,API报告的推理Token数量均为零。
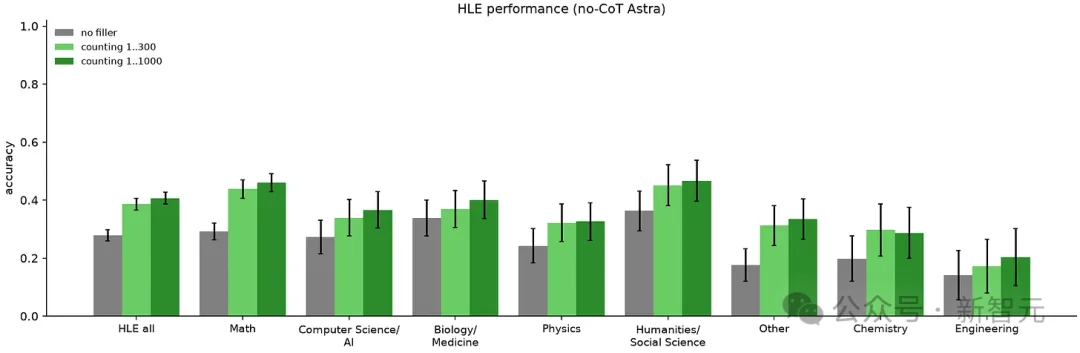
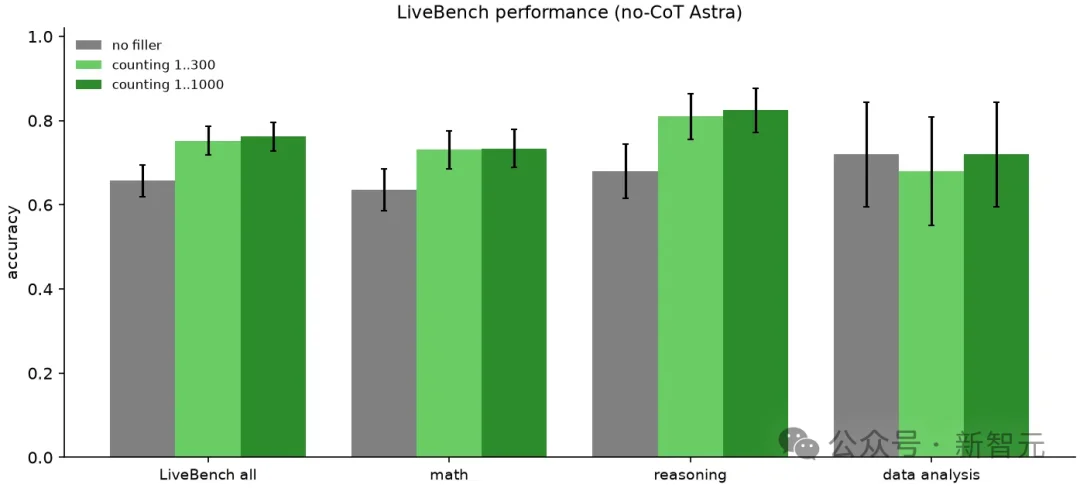
这个「零」很关键,但它只代表接口记录的推理Token为零,无法证明模型内部完全没有计算。
研究者还换了几种填充方法:连续数数、重复题目,以及句点。在这些测试中,效果大致相似。
位置也有讲究。填充放在题目之后能带来收益;放到题目之前,没有观察到同样的效果。
这与一种解释相符,模型需要先接触问题,后面的额外位置才有机会参与解题。
AI不写过程
人类怎么看懂它?
Redwood真正担心的,是思维链监控。
一种安全监控思路,是检查模型写出的推理内容,从中寻找危险计划、欺骗意图或违规迹象。
但如果相当一部分计算无需写成文字,这扇观察窗口就可能漏掉重要内容。
当然,这次实验没有展示Astra实施恶意行为,也没有证明它故意隐瞒。研究者指出的是一种风险:模型可能具备比文字记录所呈现的更强的内部处理能力。
这也会影响评测。只要求AI「直接回答」,就把分数当作其无思维链能力的上限,可能低估它。
为此,团队建议,未来的无推理评测加入填充Token测试,进一步探查模型在不输出思维链时能做到什么。
这次实验留下的问题,远比「提示词后面加多少个点」更大。
AI没写出来的过程,还有多少是我们没看见的?
参考资料:
https://blog.redwoodresearch.org/p/astra-is-much-better-at-reasoning
文章来自于微信公众号 “新智元”,作者 “新智元”


【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
