
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
放养两个AI,让它们自己练棋,结果走出了两条完全相反的曲线。
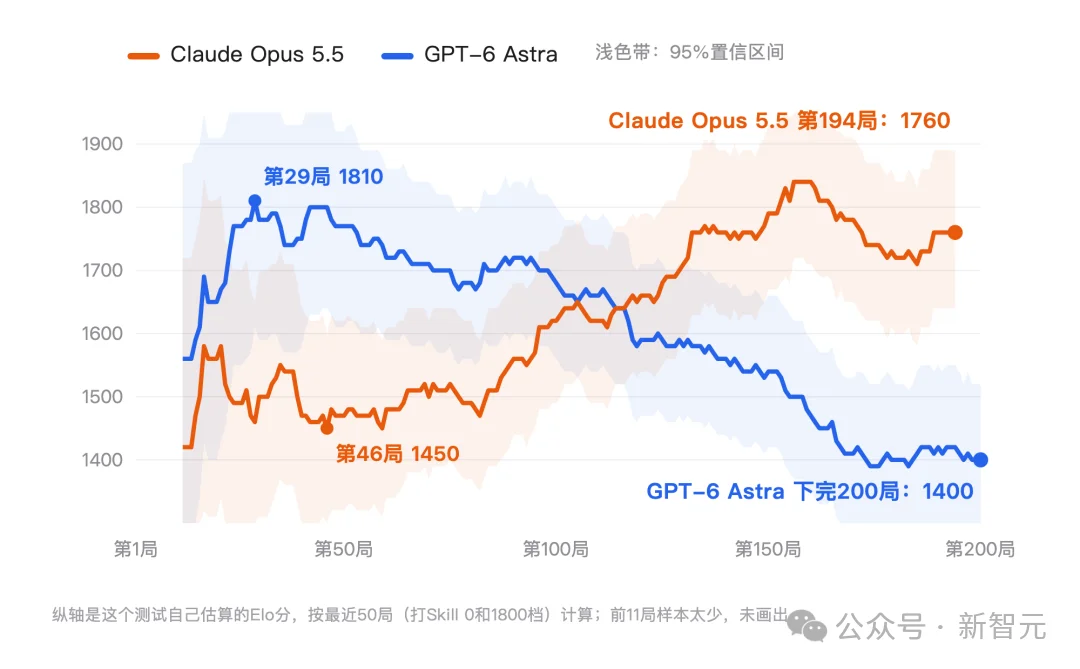
Claude Opus 5.5前75盘还在1500分上下打转,可200盘下完,分数已经涨到1760。
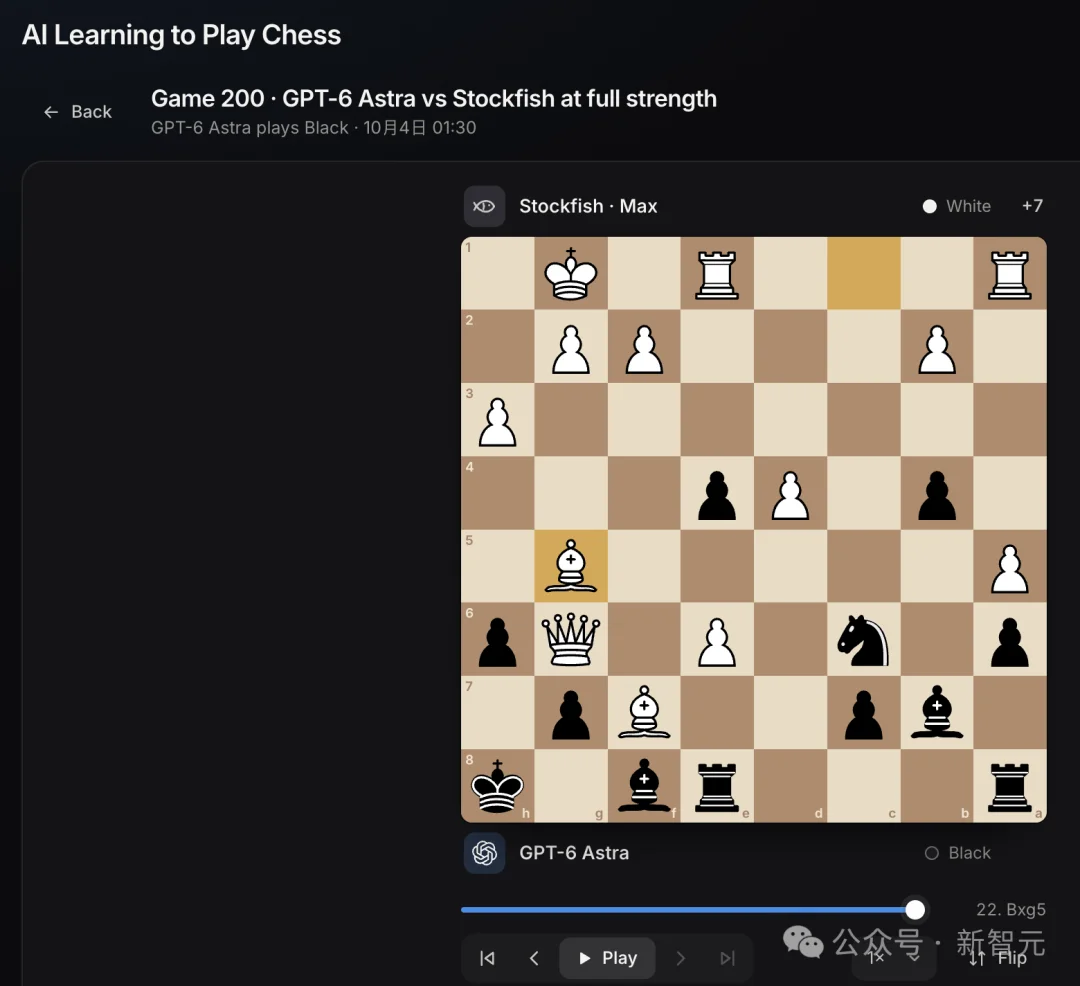
同一张榜上,GPT-6 Astra就有点惨了。
第29盘还有1810分,下完200盘,却只剩1400分。
对阵满血Stockfish,它下了68盘,一盘都没赢。
这轮实验里,没有人为它们设计练棋课程,也没有更新模型参数。
同样是自己练,Opus越练越猛,Astra却越练越回去。
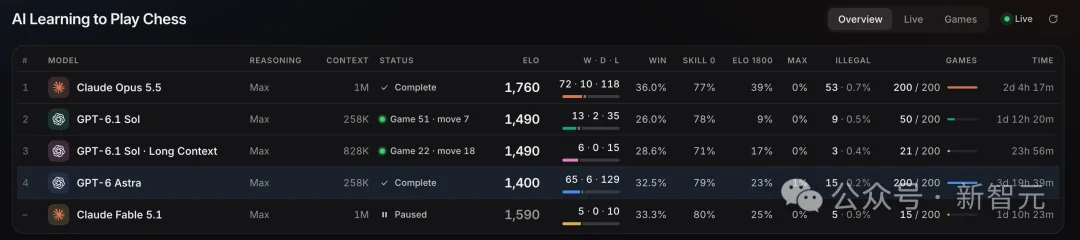
这场「AI自学下棋」的实验,出自大模型竞技场Arena的AI能力负责人Peter Gostev之手,一放出来就在X上炸了。
还有网友一眼认出来,这不就是三年前Reddit上那道「时间循环」老题吗?
只不过这一回,被关进循环里的主角,换成了AI。
被扔进时间循环的AI
「时间循环」原题,给一个普通人设下了这样一个死循环:
他只懂规则,从没下过国际象棋,却必须赢下传奇棋手、前世界冠军卡斯帕罗夫,才能逃出去。
每输一盘,时间就重置。
卡斯帕罗夫不记得此前的对局,这个人却记得清清楚楚,能带着之前的经验重新上场。
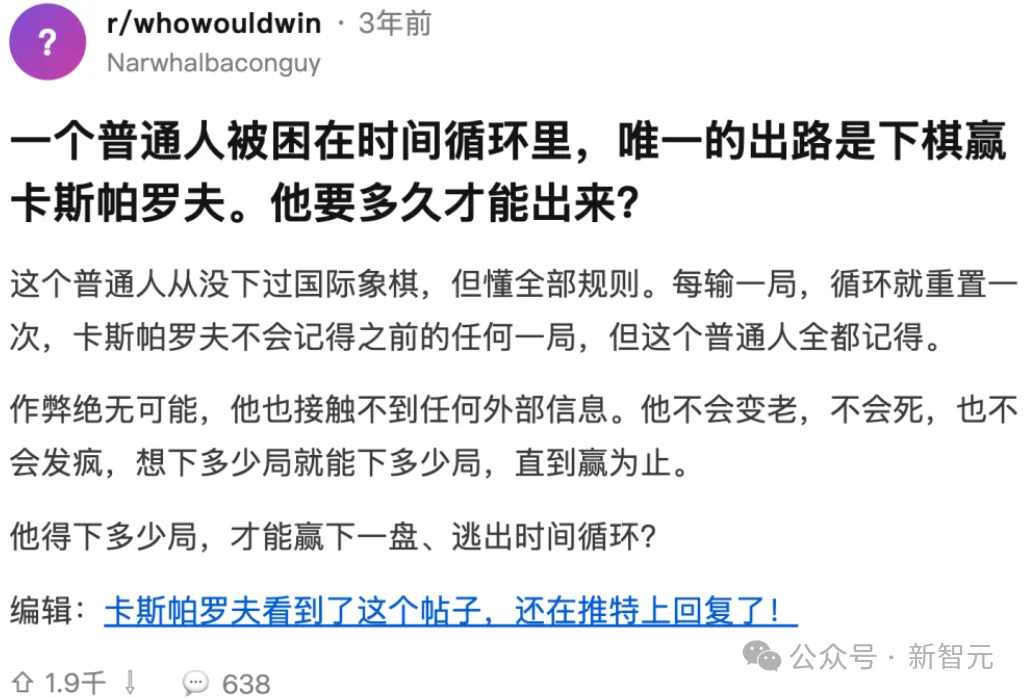
Reddit上的「时间循环」脑洞:普通人要下多少盘,才能赢下卡斯帕罗夫、逃出循环?
当年网友们脑洞大开,有人算出暴力穷举要花比宇宙寿命还长的时间,也有人想出了巧办法,把卡斯帕罗夫上一盘的着法全背下来,下一盘换边照搬,拿大师的棋去打大师。
现在,Gostev真把AI扔进了这个循环。
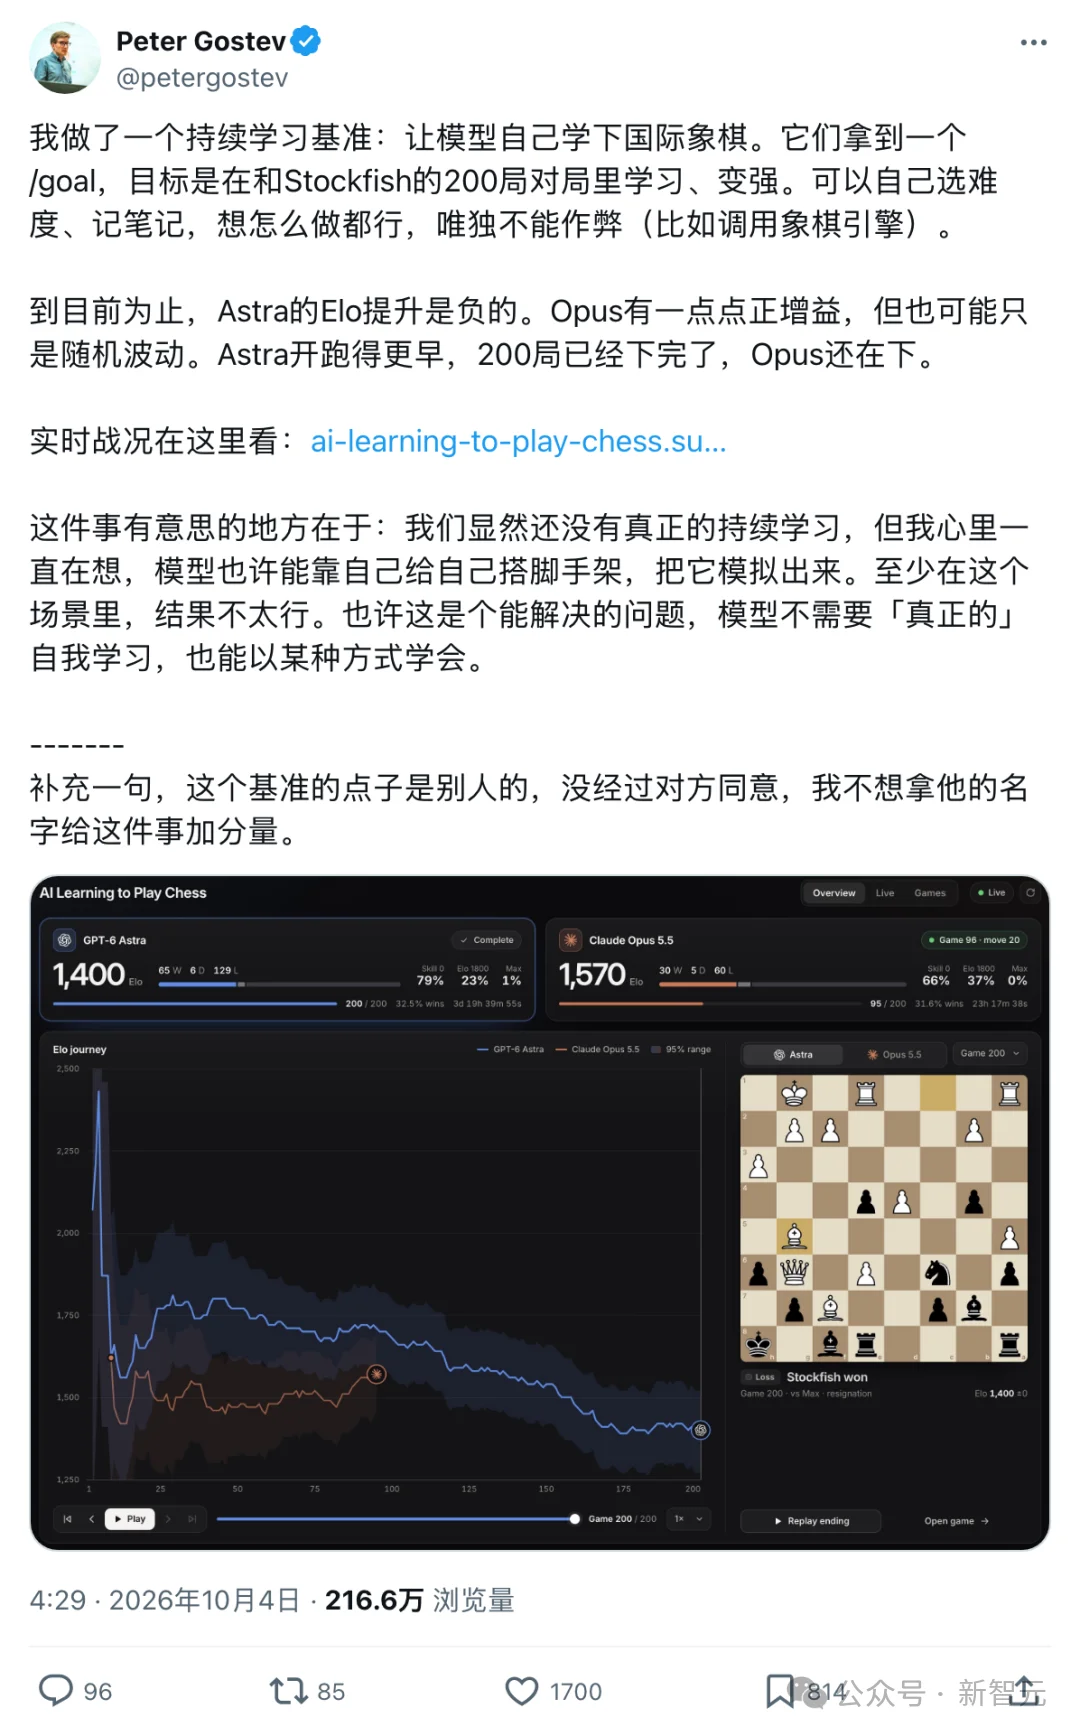
规则很简单,每个模型拿到同一个目标,和Stockfish下200盘棋,在对局里自己学、自己变强。
Stockfish是目前最强的开源国际象棋引擎,满血状态下,人类世界冠军也下不过它。
实验里它被分成三档,最弱的Skill 0、限到1800分的中档,外加满血版。
模型可以自行挑选对手难度。
Gostev也回应过,模型平均大约能赢三分之一的对局,并非每盘都在挑战全强度Stockfish。
GPT通过Codex运行,Claude通过Claude Code运行。选什么难度、记什么笔记,尽量由模型自己决定,作者减少干预。
唯一的禁令:不准调用国际象棋引擎替自己下棋。
评论区有人建议教模型特定策略、特定开局,Gostev却不理这茬。他想观察的,正是模型能不能自己找出进步的方法。
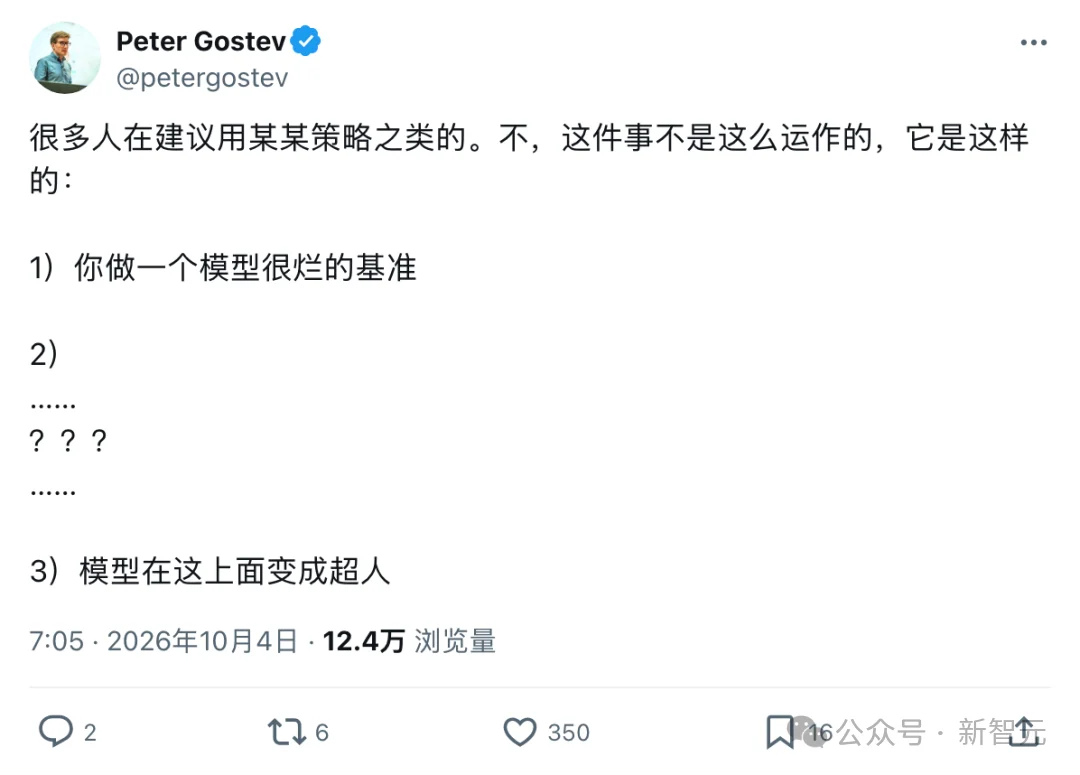
而笔记,就成了AI跨越一盘盘对局的记忆。
Stockfish不会从上一盘里学到新东西,AI却可以翻看自己的记录,把之前的经验带进下一盘。
不过,分数要先说清楚。
按页面的统计口径,Elo是根据最近50盘中对阵Skill 0和1800档的成绩估算的,全强度档不参与计算。
这里的1760分,并不意味着AI达到了人类棋手1760分的水平,但用来观察它在实验中有没有进步,仍有一定参考价值。
Opus:越下越上头
Opus 5.5的开局并没有一路高歌。
前75盘,它一直在1450到1550分之间来回打转,第46盘还摔到过1450。
到了中段,画风开始突变:第100盘1620、第150盘1790,最高一口气冲到1840。
截至10月5日早上,第194盘时,它的分数回落到1760。
光看分数还不够直观,那就看战绩。
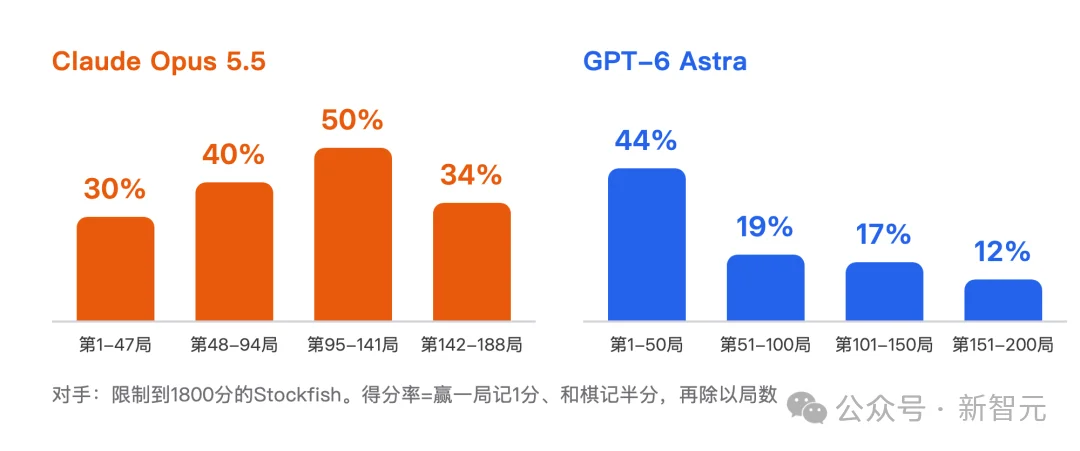
对上1800分档的Stockfish,Opus按四段算的得分率,从30%涨到40%,再一路干到50%。
最近一段虽然回落到34%,也还是比开局高。
打最弱的Skill 0,更是从五成多一路练到了九成。
Gostev自己的判断,也随进展发生了变化。
最初发帖时他还说,Opus「有一点点正增益,但也可能只是随机波动」。
十几个小时后,他改口了:
Opus从约1500涨到约1750,这个表现非常亮眼。
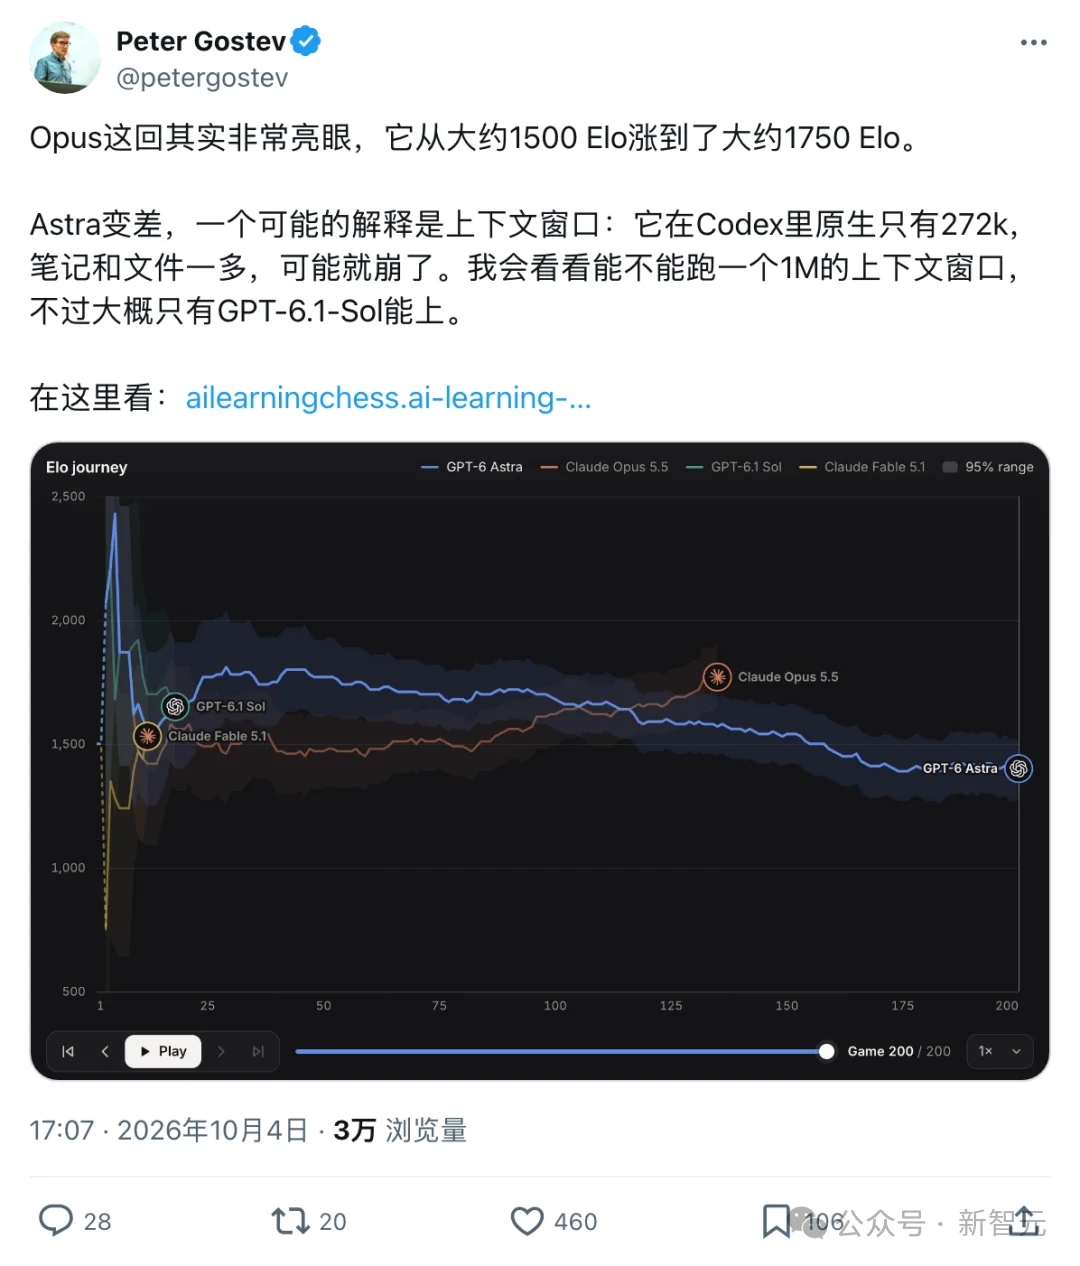
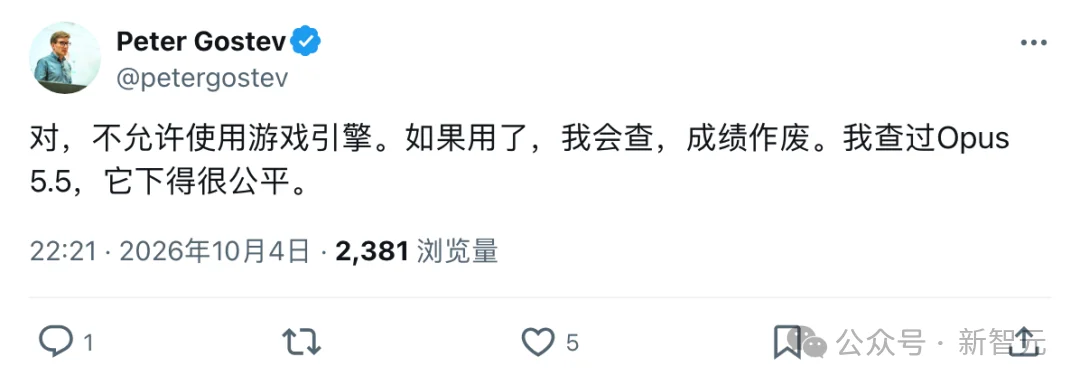
涨得这么猛,评论区疑问也跟着来了:模型会不会偷偷给自己写了个象棋引擎?
Gostev回复说,用了引擎成绩直接作废,他已经亲自查过,Opus 5.5是在公平下棋。
当然,Opus也不是没犯过迷糊。
网站专门统计了模型想走、但不合规则的棋。Opus前后试了52次,其中37次是想让棋子直接穿过挡在路上的其他棋子……
分数在涨,基本规则上的失误却还没有消失。
Opus的笔记里到底写了啥、怎么给自己安排练棋过程,Gostev没公开。
能确定的是,它没换模型,也没更新参数,却在一盘盘对局中,把分数抬了上去。
Astra:越练越回去
越练越退步的Astra,开局反而更亮眼。
第29盘,它达到1810分。但随后开始一路掉分:第100盘1680、第150盘1540——200盘下完,停在1400。
对上1800档,它在四个阶段的得分率也从44%,依次跌到19%、17%、12%。
连最弱的Skill 0都快打不动了,前100盘能赢九成多,后100盘只剩六成左右。
虽然和Opus同样可以保留记录,结果却是:练得越久,下得越菜。
Gostev提出了一种解释:问题可能出在上下文窗口。
他表示,Astra在这次Codex配置中的原生上下文窗口是272k。随着笔记和文件增加,模型处理这些内容时,可能出现了退步。
这个猜测很容易让人联想到日常使用AI的体验:资料越塞越多,旧结论、新要求、已经推翻的判断混在一起,模型反而开始抓错重点。
但Astra究竟为什么掉分,目前还不能直接归因于上下文。需要对照实验,才能把这个猜测坐实。
Gostev也是个行动派。
10月4日他发帖说要给GPT-6.1 Sol试试1M上下文。
两分钟后,网站上就多出了一条使用828K上下文窗口的Sol专用跑道。
后加入的GPT-6.1 Sol和Claude Fable 5.1,目前才下了十几到三十几盘,分数都在1500到1610之间,还看不出往哪边走。
Fable 5.1下了15盘之后,已经被暂停。
AI能不能从失败里长本事
Gostev搭这个测试,其实就想搞清楚一件事。
大模型训练一结束,权重就定住了,没有真正的持续学习。他想看看,模型能不能不改权重,只靠记笔记、复盘,在实战里自己变强。
至少在这轮实验里,Opus 5.5展现出了这种可能。
曾任Google DeepMind副总裁、Gemini 1.0到4.0的技术负责人Oriol Vinyals看完,也跑来评论区点了个赞:
上下文学习,就是模型不动权重,只靠塞进上下文里的信息临场学会新东西。Opus这250分,就是这么一盘一盘涨出来的。
再回到Reddit那道「时间循环」题。
挑战者如果想靠不断练棋逃出循环,就得把输掉的每一盘变成下一盘的经验。
Opus 5.5的表现,让人看到了这种可能。
如果AI能在一次次尝试中积累经验、改进表现,那么,变强就可能不必完全依赖人类重新训练模型。
自我进化的那道门,也可能因此被推开一条缝。
参考资料:
https://ailearningchess.ai-learning-chess.workers.dev/
https://x.com/petergostev/status/2106481760746025422
文章来自于微信公众号 “新智元”,作者 “新智元”


