
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
把杯子放进微波炉里,这一人类几乎不用思考的日常动作,机器人却可能在杯子放不稳、夹爪碰到门框这样的细节上频频出错。
让它从一次次失败中改进当然可行,但每次都让真机试错,执行、重置和硬件维护又是一笔不低的成本。
如果把探索搬到仿真里,新的问题又来了:场景重建得确实很像,但真的能复现视频里的操作吗?
针对这一问题,来自上海人工智能实验室、上海交通大学、浙江大学、中国科学技术大学、香港中文大学和香港大学的研究团队提出Real2Gym:从人类或机器人视频构建可交互的仿真环境,让Agent在其中探索、积累技能,再将经验用于真实机器人。论文与代码现已公开。
多模态模型已经能调用建模工具生成细致的三维场景,但机器人操作对几何误差尤其敏感。杯口稍窄、物体偏移,或容器内部被碰撞模型封住,都可能让画面中合理的动作在物理执行时失败。
Real2Gym把动作能否在物理引擎中完成作为场景验收的一部分。系统既要保留视频中的物体、布局和视角,也要让机器人真正完成抓取、放置和接触。
对于多视角视频,Real2Gym利用Pi3X提供的几何线索,结合SAM2分割关联不同视角中的物体,约束它们的尺度和位置,再构建可编辑的Blender场景及对应的MuJoCo环境。单视角输入则采用相应的几何初始化方案。
接下来,系统关注的是交互发生变化的时刻:物体何时被抓起、何时接触支撑面、夹爪何时释放。围绕这些关键帧,Agent自我检查视角、布局、接触和外观,并结合相邻画面局部修正。
以倒杯为例,即使桌面和物体已经对齐,杯沿附近的尺寸误差仍可能导致穿模。关键帧检查能把修正集中到真正影响操作的区域,避免只凭一张整体渲染图判断重建质量。
经过修正的动作会在MuJoCo中执行,检查任务完成情况以及支撑、接触和稳定性。执行轨迹随后导回Blender,与原视频对照,核查视觉对应和物理可行性。

通过验证的场景还可以改变物体位置、桌高、材质、背景、光照或干扰物。会影响运动空间的变化需要适配动作并重新验证,从而为Agent提供更多可练习的任务环境。
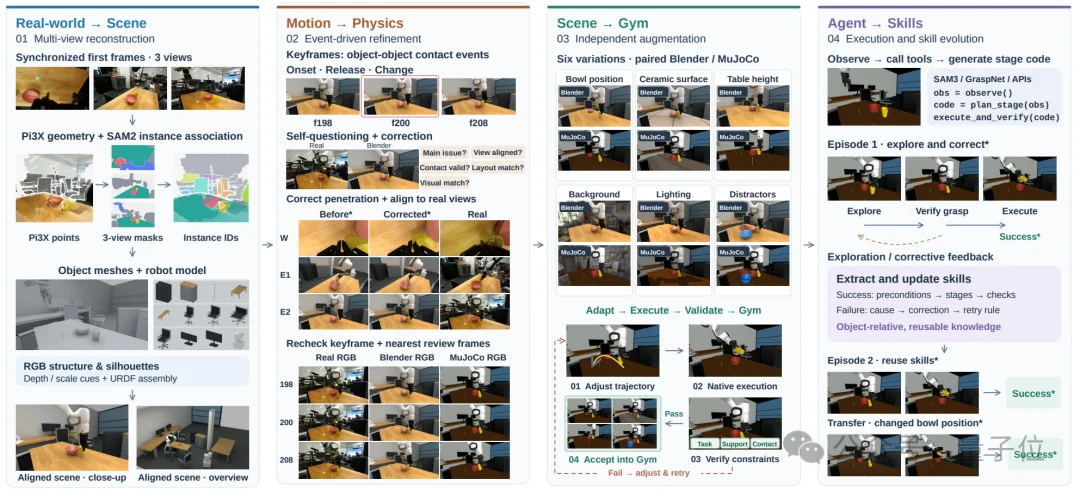
有了练习场,Agent还需要高效地完成探索。Real2Gym将每轮决策的目标从生成单个动作,提升为生成执行一个操作阶段的代码。
例如,一轮响应可以安排接近杯子、闭合夹爪、抬起并检查是否抓稳,将多个动作和验证条件组织在一起,减少反复请求模型的次数。SAM3提供物体定位线索,GraspNet提供抓取候选,帮助Agent把任务意图落实为可执行动作。
执行后,Agent根据反馈整理成功步骤、失败原因和恢复方法,形成可复用的skills。经验描述的是相对物体如何行动、何时检查、失败后怎样修正;再次使用时,要根据当前观察重新定位和调整。
这里的自我改进通过更新技能库实现,底层模型权重保持不变。每次新任务从独立上下文开始,接收选定的技能,因此可以检验经验本身的作用。
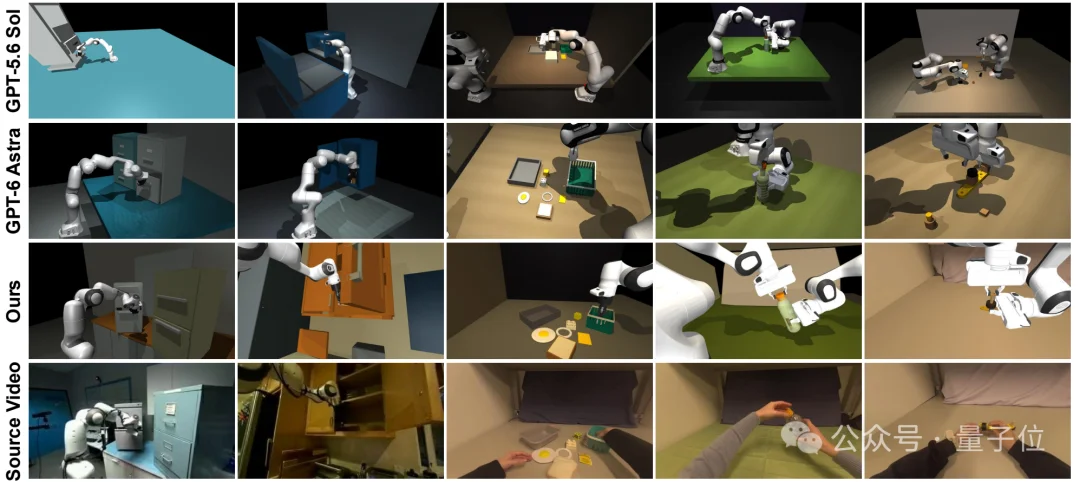
团队选取DROID和EgoDex的24个场景,覆盖机器人示范和人类操作视频。重建评估中,Real2Gym在内容对齐、视角对齐、动作保真度和仿真成功评分上均优于所比较的GPT基线。定性对比显示,它更好地保留了柜体结构、物体相对尺寸与位置,以及原始相机视角。
在这些环境中的Agent评估里,复用首轮经验后的第二次执行,平均成功率达到87.5%,GPT-6 Astra Direct Mode基线为70.8%;策略执行的Token用量减少约74.9%。平均模型响应次数也从约31次降至约14次。
阶段代码让一轮决策能推进更多动作,技能复用则减少重复探索。论文还展示了叠碗任务中Real2Gym成功、两个GPT基线失败的案例,以及经验复用后更直接的柜体操作与适配器放置过程。上述开销统计针对策略执行,不包括场景构建和单独的技能提取。
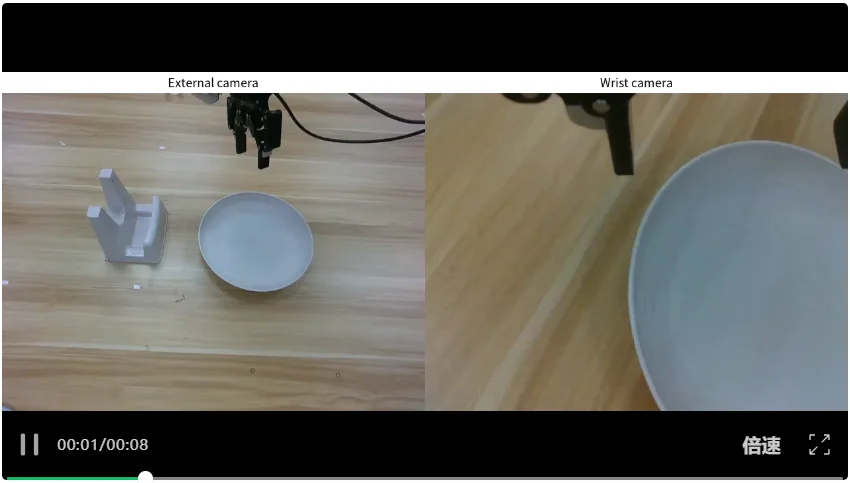
在Franka机械臂上,团队测试了方块入盘、挂杯、杯子放入微波炉并关门,以及盘子上架四项任务。前三项各3次尝试中,Real2Gym均成功;GPT-6 Astra基线分别成功1次、3次和1次。
盘子上架则让两种方法都遇到了困难:抓取深度、盘沿朝向和狭窄空间中的放置精度必须同时满足要求。初始执行中,两种方法都未成功。
团队随后录制人类示范,重建可交互的数字孪生。Agent在仿真中的前两次尝试失败,第三次迭代获得可用技能,再结合真机实时观察执行,完成了原本失败的任务。这展示了从真实示范出发,经仿真探索改进技能,再回到真实世界验证的完整过程。
Real2Gym提供了一条利用操作视频的路径:从示范构建环境,让机器人通过执行获得反馈,再把经验保存为可复用的技能。随着更多视频转化为可交互任务,机器人有望在仿真中积累更丰富的操作经验。
目前,点云噪声仍会影响重建,阶段级控制在精细操作中也有改进空间;真机验证限于Franka和平行夹爪。向灵巧手和人形机器人扩展,还需要进一步实验。
论文标题:Real2Gym: Building Gyms from Videos, Bringing Skills to Robots
作者:Kerui Ren、Yingxiang Xu、Kaiwen Song、Lingning Xu、Bo Dai、Mulin Yu、Tao Lu。Kerui Ren与Yingxiang Xu为共同第一作者,Mulin Yu与Tao Lu为通讯作者。
项目主页:https://real2gym.github.io/
论文:https://arxiv.org/abs/2609.37089
Real2Sim代码:https://github.com/real2gym/Real2Gym
Agent代码:https://github.com/real2gym/R2G_Agent
文章来自于"量子位",作者 "上海人工智能实验室"。


【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
