
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
增强模型的表达能力,可以让Transformer更灵活地读取和整合信息。Attention Residuals(AttnResidual)沿着这个方向,将注意力从token之间的信息交互扩展到网络深度,让每个子层学习选择哪些历史层输出。
但新增的选择能力也带来了新的问题。在研究团队评估的AttnResidual设置中,模型对初始token的注意力集中更加明显,激活异常值也显著增大。这些变化在低比特量化和长上下文评测中,进一步表现为性能退化。
来自西北大学、伊利诺伊理工学院、罗格斯大学等机构的研究团队提出OASIS,为这种双层信息路由提供显式的null选项,并用token层的null概率调整depth层的分支选择。该研究已被NeurIPS 2026接收。
论文:https://arxiv.org/abs/2605.17887
代码:https://github.com/robinzixuan/OASIS
相对于Vanilla AttnResidual,OASIS在LLaMA-3.2-1B、Qwen3-0.6B和Phi-4上,平均降低激活峰度95.90%、最大激活幅度81.75%,降低W8A8困惑度82.00%,并将W4A4 GSM8K Pass@1平均相对提升42.11%。这里的提升是相对比例,准确率的绝对变化见后文表格。
普通Transformer的self-attention决定一个token应该读取哪些token。AttnResidual则增加了一次沿深度的选择:同一个token在当前子层,应该使用哪些历史子层产生的表示。
在普通残差连接中,初始embedding和此前子层的输出以固定权重累加。AttnResidual将这种累加改成可学习的加权混合,再把混合结果送入当前attention或MLP子层。其depth query是当前目标子层的可训练向量,key来自经过归一化的历史输出,value则是历史输出本身。
这样,模型同时进行两种选择:token层选择上下文位置,depth层选择历史计算结果。两种选择都由softmax归一化,而普通softmax要求候选的权重总和等于1。
如果一次读取只需要很小的贡献,模型仍要把全部概率分给真实token;如果一些历史分支没有提供多少有效信息,depth层仍要在真实分支之间分配全部质量。两处归一化都缺少显式的「这次不选」选项。
Attention sink指某些位置长期吸收大量注意力,即使这些位置本身承载的信息有限。论文中的注意力图显示,在所研究的AttnResidual模型中,序列起始token上的集中条带比原始Transformer更强,并随网络深度持续出现。
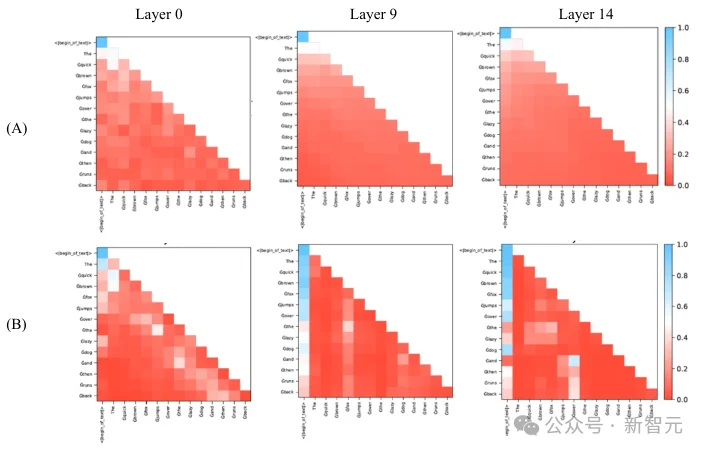
图1 论文中的注意力诊断。上排为原始Transformer,下排为AttnResidual,分别展示第0、9、14层。起始token上的竖直条带反映注意力集中。来源:论文Figure 2。
异常激活会扩大数值范围,使有限的量化刻度更难兼顾大多数普通数值。以LLaMA-3.2-1B为例,Vanilla AttnResidual的平均激活峰度为91.71,最大激活幅度为84.43;OASIS将两者降至3.02和12.25。
论文还给出了条件性的机制分析:在值向量满足规定的分离条件时,普通softmax若要产生足够小的attention输出,可能必须把大量概率集中到低范数候选上。沿深度的混合也存在类似的条件性集中约束。这为同时处理token和depth两层归一化提供了动机。
OASIS首先沿用Softmax₁,为真实候选增加一个零值null选项。对真实候选i,其权重为:
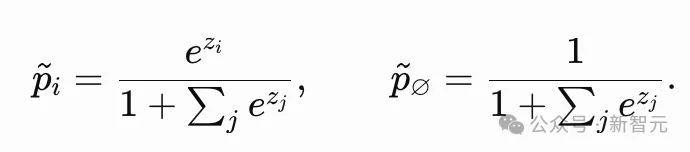
分母中的1对应一个固定logit为0的null候选。真实候选的权重可以合计小于1,剩余质量进入null,从而减小真实内容的总贡献。论文将token和depth两处都使用Softmax₁的版本称为AoS。
但两层各自拥有null选项,仍未解决两层如何协调的问题。一个分支的attention heads已经较多地选择null,depth路由却可能继续为这个分支分配较高权重。OASIS因此进一步引入token-to-depth null coupling。
具体而言,在每个token位置,OASIS对一个源分支内各attention head的null概率取平均,得到分支统计量ψᵢ,再与候选变换分支的平均值比较,用差值调整depth logit:
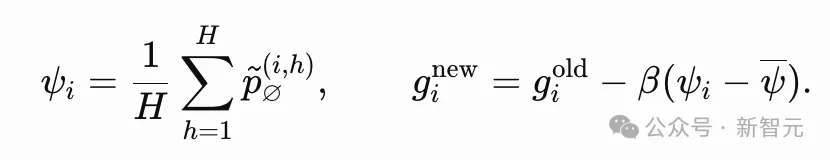
null概率高于分支平均水平,depth logit就降低;低于平均水平,则相应提高。初始embedding分支没有token attention的null统计,其logit保持不变。调整后的logits再经过depth Softmax₁,得到最终的混合权重。
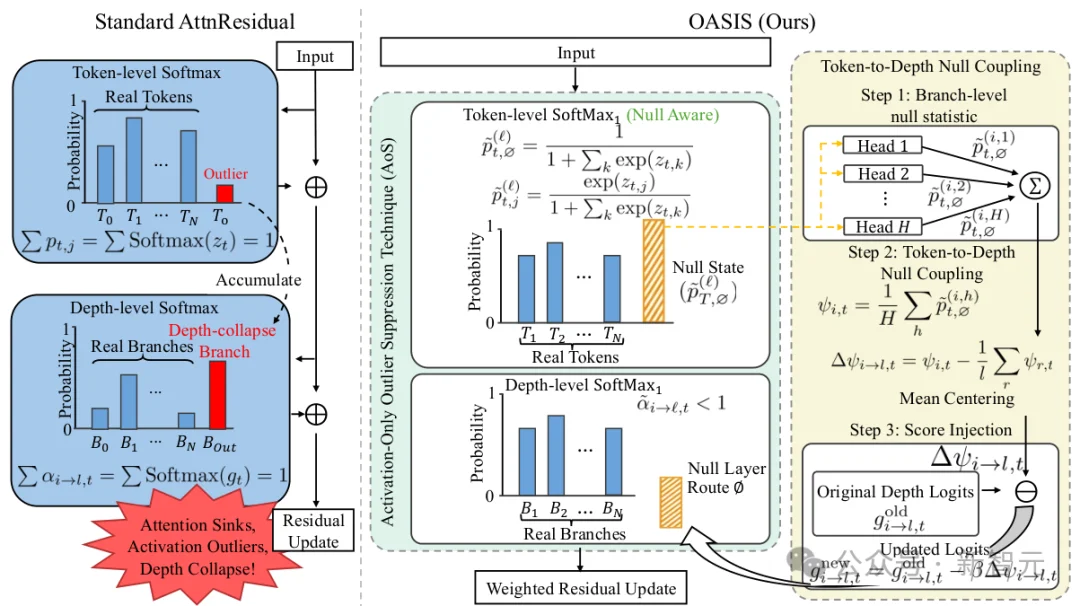
图2 OASIS的双层路由结构。两处Softmax₁提供null选项,右侧coupling将token层的null统计注入depth logits。来源:论文Figure1。
OASIS保留原有训练目标,修改的是路由机制。token层的null对应零值贡献,depth层的null则衰减真实源分支的混合贡献;depth null本身并不意味着直接保留上一层hidden state。实验通过继续训练适配这些改动,随后再进行量化评测。
团队在LLaMA-3.2-1B、Qwen3-0.6B和Phi-4上验证方法,使用BookCorpus和Wiki40B/en进行继续训练,并与标准AttnResidual、OutEffHop、裁剪及门控等方案比较。实验采用三个独立随机种子。
首先看Qwen3-0.6B的W4A4 GSM8K消融。只加入token null、只加入depth null、同时加入两处独立null,以及加入coupling,分别得到以下结果:
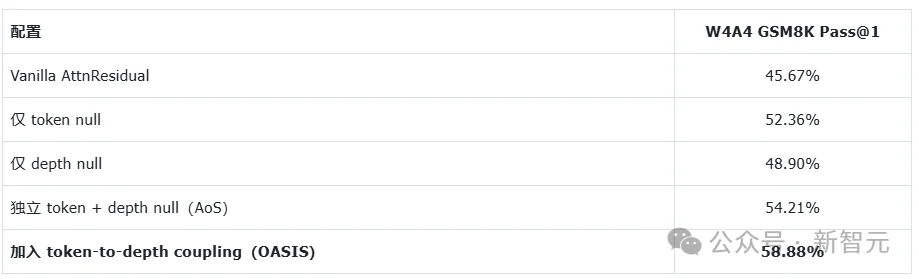
表1 Qwen3-0.6B的组件消融,GSM8KPass@1越高越好。数据来自论文Table8。
两处独立null已经改善性能,而coupling在此基础上再提高4.67个百分点。完整OASIS相对Vanilla AttnResidual提高13.21个百分点。这组结果直接支持了跨层协调的作用。
在语言建模与数学推理中,OASIS同样改善了量化后的表现。W8A8表示权重和激活均使用8bit,W4A4则均使用4bit;论文中的W4A4结果采用OmniQuant。下表摘录论文Table2的均值。
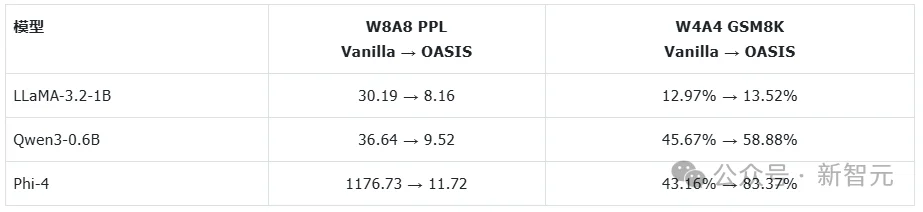
表2 三模型的量化结果。PPL越低越好,GSM8KPass@1越高越好。
以Qwen3-0.6B为例,OASIS的FP16 GSM8K为62.68%,量化至W4A4后保留58.88%;Vanilla AttnResidual则从FP16的62.58%降至45.67%。两者全精度表现接近,但低比特下的能力保留明显不同。
这些改善也出现在其他任务上。Qwen3-0.6B的ThePileW8A8PPL从44.52降至11.58;W4A4 MMLU、TriviaQA和MATH500准确率分别从33.21%、12.09%、15.41%提升到41.00%、16.14%、21.51%。
长上下文实验比较了训练最大序列长度为12K的模型。在RULER和LongBench上,Vanilla AttnResidual明显低于原始backbone。OASIS缓解了这部分退化,并明显优于只有独立null路由的AoS。
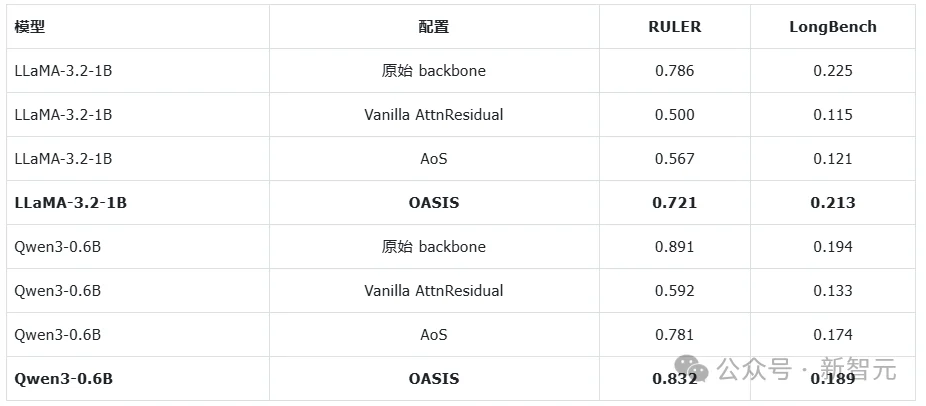
表3 12K tokens的长上下文结果,数值为论文原始分数,越高越好。数据来自论文Table 3。
相对于Vanilla AttnResidual与原始backbone的差距,OASIS在两模型上分别恢复了77.3%和80.3%的RULER性能损失,以及89.1%和91.8%的LongBench性能损失。
全局attention统计也支持了sink的缓解。这些统计覆盖所有层、attention heads、query位置及评测样本:Qwen3-0.6B分配给BOS的平均质量从0.4990降到0.0013,LLaMA-3.2-1B则从0.5630降到0.0099,说明变化并不限于少数可视化样例。
OASIS从AttnResidual的双重归一化出发,连接了表达能力、信息路由和低比特鲁棒性。模型拥有更灵活的选择接口之后,还需要表达候选内容应当贡献多少,以及不同选择层级之间如何协调。
显式null路由提供了可衰减真实内容贡献的接口,token-to-depth coupling则让跨层选择能够利用token层的null信号。
组件消融、量化评测和长上下文实验共同表明,这种协调有助于所研究模型更稳定地发挥新增的路由能力。
参考资料:
https://arxiv.org/abs/2605.17887
文章来自于"新智元",作者 "LRST"。


【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
