
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
Kimi想要把自己放到海外模型的坐标系里
10月24日凌晨,Kimi K3.1 Pro发布了。月之暗面官方公众号写道,“我们正式推出Kimi K3.1 Pro,这是K3.1系列的第一个模型,也是我们迄今能力最强的3万亿级参数模型。”距离上一次Kimi发布K3旗舰模型已经过去了99天。
值得注意的是,这里的“3万亿级参数”并不意味着模型又扩了参数。K3.1 Pro依然维持K3的2.8T,即2.8万亿总参数规模。这次升级并没有重新进行预训练,重点则是在既有底座上进一步增强后训练。官方也明确解释,K3.1 Pro是K3的后训练版本,大幅增加了后训练的算力投入,尤其是面向数百个下游领域的联合强化学习。
而就在过去两周,国内模型厂商也接连发布了最新模型:先是10月17日,DeepSeek发布V4.1 Flash-1017,紧接着10月19日,MiniMax发布M3.1 Flash。两家都在提升能力的同时,强调更高的推理效率和更低的任务成本。
相比之下,Kimi这次的侧重点有所不同。尽管K3.1 Pro的API价格较K3也有所下降,但与DeepSeek、MiniMax此次推出的Flash模型相比,它仍处于明显更高的价格区间。Kimi这次率先推出的,是继续提升能力上限的Pro版本。
但与此同时,虎嗅也了解到,Kimi正在研发Flash版本,并计划在下一代旗舰模型中继续扩大参数规模,追求SOTA。
这意味着,月之暗面在IPO前的关键节点,既保持了以往的思路,继续追求SOTA,同时也想通过Flash版本、Pro版本等等,提高商业化成绩。但问题是,在有限的资源范围内,如何平衡两者?
据彭博社报道,截至2026年8月,月之暗面向投资者披露的ARR已突破10亿美元,6月时这一数字还是3亿美元,并且到今年年底,其ARR有望突破20亿美元。值得注意的是,在今年年初,Kimi透露其商业化进展时便强调过,其海外收入远高于国内。
而本次的K3.1 Pro版本发布便得以体现,在国内模型厂商都在追求性价比的时候,Kimi继续选择了追求能力上限,这当然是好事。不过从目前部分开发者反馈来看,K3.1 Pro也并非完美。部分用户反馈,在使用3D-Maker功能时,仅一个任务消耗过多Token导致达到额度上限,影响用户体验。
对比DeepSeek V4.1-Flash和MiniMax M3.1-Flash后发现,K3.1-Pro是前两者的16倍
回顾过往Kimi发布的模型,虽然也有侧重速度和特定任务的版本,但Flash此前并未成为其主要产品命名,这次依然没有。对于一家正在追求商业化成绩的模型公司而言,兼顾速度、成本与能力的产品越来越重要。在这一轮Flash产品的竞争中,Kimi尚未出牌。
但Kimi这次的模型思路有所不同。Flash通常强调速度、成本与能力的平衡,Pro则更偏向复杂任务和能力上限。
对此,虎嗅对近期发布的三款模型进行了比较。虽然Kimi K3.1 Pro与DeepSeek V4.1 Flash-1017、MiniMax M3.1 Flash并不属于同一档位,但它们都面向编程、工具调用和长流程任务,在这些共同场景中,依然具有可比性。
先看能力。在第三方评测机构Artificial Analysis的综合智能指数中,Kimi K3.1 Pro约为55分,DeepSeek V4.1 Flash-1017在max推理设置下约为45分,MiniMax M3.1 Flash约为43分。至少在这一评测体系下,Kimi的综合能力领先,另外两款Flash模型的得分则较为接近。
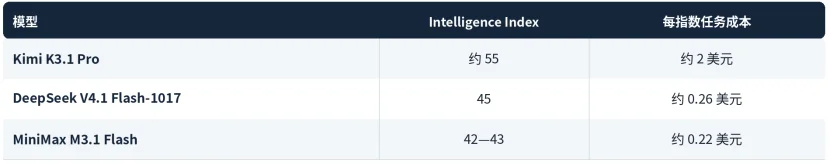
来源:Artificial Analysis
更值得关注的是,相比K3约44分的成绩,K3.1 Pro提升了约11分。这意味着,即便没有进一步扩大参数规模,Kimi依然通过这轮更新获得了明显的能力增益。按照AA的评测,这种进步在Agent任务上更为突出,部分知识、科学推理测试的提升则相对温和。
不过,更高的能力也对应着更高的调用价格。
按照三家官方美元API定价,Kimi K3.1 Pro每百万未缓存输入token收费2美元,输出收费10美元;MiniMax M3.1 Flash分别为0.15美元和0.60美元,DeepSeek V4.1 Flash-1017在空闲时段与MiniMax一致,高峰时段翻倍。
如果按累计输入、输出各100万token计算,不使用缓存,也不计工具调用等其他费用,Kimi的账单为12美元,MiniMax与DeepSeek空闲时段均为0.75美元,Kimi的费用是后两者的16倍;相对于DeepSeek高峰时段的1.5美元,则为8倍。相比K3,K3.1 Pro的输入、输出单价已经下降了约三分之一,但降价后仍明显高于另外两款Flash。
当然,这一差距并不意味着Kimi的性价比一定更低。同等token用量不等于同等工作成果。对于三款模型都能完成的工作,低价更有吸引力;但如果Kimi能解决另外两款模型难以完成的问题,或者显著减少人工返工,更高的价格就可能有其价值。
因此,比总分更值得进一步观察的是,三家分别在强化哪些工作能力,以及这些能力能够吸引什么样的付费需求。同时,通过三家在RL上的重点方向,也体现了三家不同的商业化探索方向。
从本轮发布重点看,Kimi更突出3D建模和金融研究,DeepSeek强调完整项目开发,MiniMax则将电脑操作与跨应用工作流放在显著位置。
Kimi选择的3D和金融场景,都需要模型与专业工具、专业知识结合。例如,3D建模需要将物体的形状和空间关系转化为可用的模型资产;金融研究不仅需要整理信息,还涉及跨文档核对、数值推理和财务建模。这与单纯生成一段文字相比,对最终结果的要求更具体,也更容易暴露模型能力的不足。
这种侧重已经体现在产品中。Kimi在此次发布时同步上线了3D Make功能,支持模型在线预览、编辑及用于3D打印的导出。在金融方向,其公布的内部测试则分别考察财务建模、研究和模拟商业运营能力。虽然内部成绩仍需要更多外部验证,但可以看出,Kimi正试图将通用能力的提升,转化为专业场景中的可用性。
相比之下,DeepSeek和MiniMax本轮强调的,是让开发与办公中的执行能力能够被更低成本地使用。前者展示从零开发游戏、搭建3D场景等完整项目,后者则强调软件开发、电脑操作,以及销售、运营、财务等跨应用工作。
DeepSeek的1017版本采用自反馈强化学习,在提升项目开发能力的同时,缩短任务耗时和输出长度;其V4.1 Flash底座此前也已通过压缩、复用KV缓存等方式,降低长上下文处理负担。MiniMax则采用更激进的稀疏化,并称M3.1 Flash在线推理速度接近前代的三倍,Agent任务总体使用成本下降70%。
Kimi则明确增加了后训练算力投入,面向数百个下游领域开展联合强化学习,并配套优化训练框架、沙箱和任务调度等基础设施。它本轮更突出的选择,是继续挖掘大底座在高难度任务中的潜力,再用实际效果证明Pro的价值。
商业化与SOTA,Kimi都要
从已公开披露的参数规模看,Kimi K3已处于国内模型的最大规模之列。但在下一代旗舰模型上,Kimi仍瞄准了更大参数的SOTA模型。在其他条件相近的情况下,这意味着更高的训练算力需求。
而与之前不同的是,Kimi今年也在加速商业化,海外市场已经成为重要的收入来源。据澎湃新闻今年2月报道,Kimi当时近20天的累计收入已超过2025年全年,海外收入也已超过国内。到了8月,据彭博社报道,月之暗面向投资者披露的ARR已突破10亿美元,6月时这一数字还是3亿美元,并且到今年年底,其ARR有望突破20亿美元。
这也让Kimi追求SOTA的选择有了更直接的商业解释。面向海外市场,它需要争取的,是那些已经在使用海外旗舰模型的用户。在K3.1 Pro的官方评测中,Claude Opus 5.5和GPT-6 Astra便是主要比较对象。强化编程、3D建模和金融研究等专业能力,也可以理解为争取这部分用户付费的一种方式。
然而,Kimi在不断刷新模型能力上限的同时,用户体验也同样重要。K3.1 Pro上线后,Reddit上一位用户反馈,自己让模型制作一个基础的3D游戏演示,没有启用子Agent,约10分钟就耗尽了五小时窗口内的使用额度,仍未拿到结果。这意味着,3D任务可能消耗更多的Token,从而达到额度上限,并最终影响用户体验。
如果复杂任务频繁触及额度上限,那么模型展示出的能力,便很难充分转化为用户日常使用的价值。对希望留住海外付费用户的Kimi来说,任务完成效果、额度消耗和服务的连续性,都将影响下一次续费。
因此,月之暗面需要平衡的,不仅是下一代旗舰的训练投入,还有现有产品的推理成本与用户体验。这也是Flash版本的意义:用成本更低的模型承接日常任务,让旗舰服务于更复杂的需求。不过,降低成本的前提仍然是能够完成任务,否则省下的调用费用,也可能被重试和人工返工抵消。
商业化与SOTA并不天然冲突。但对于Kimi而言,仍然需要找到平衡,做一些取舍。
文章来自于微信公众号 “虎嗅APP”,作者 “虎嗅APP”

【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LGM是一个AI建模的项目,它可以将你上传的平面图片,变成一个3D的模型。
项目地址:https://github.com/3DTopia/LGM?tab=readme-ov-file
在线使用:https://replicate.com/camenduru/lgm
