# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
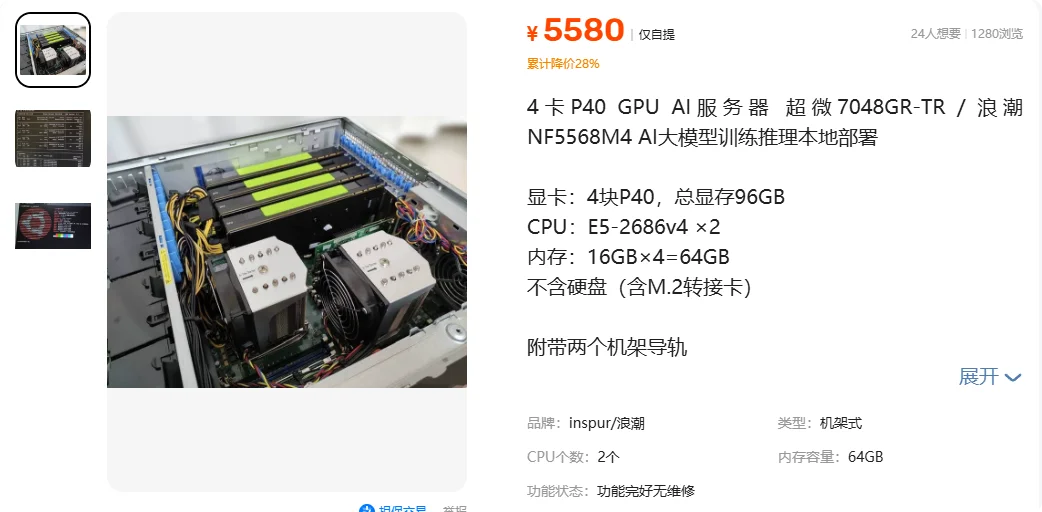
5580元,四张24GB P40,合计96GB显存。老计算卡就这么水灵灵地又上岗了。 这条闲鱼商品,卖家标称双路E5-2686 v4、64GB内存,不含硬盘,附M.2转接卡和导轨,仅限南京自提。
P40每张1150元,四张4600元;E5-2686 v4每颗100元,两颗200元;16GB DDR4-2133服务器内存每根300元,四根1200元。三项合计6000元,还没算主板、电源、机箱和散热。
这笔是参考价下的配件账;5580元是这条商品的挂价,整机还省去配套采购的麻烦。按相近成色、功能正常的配件比较才有意义,落地预算另加硬盘和搬运。
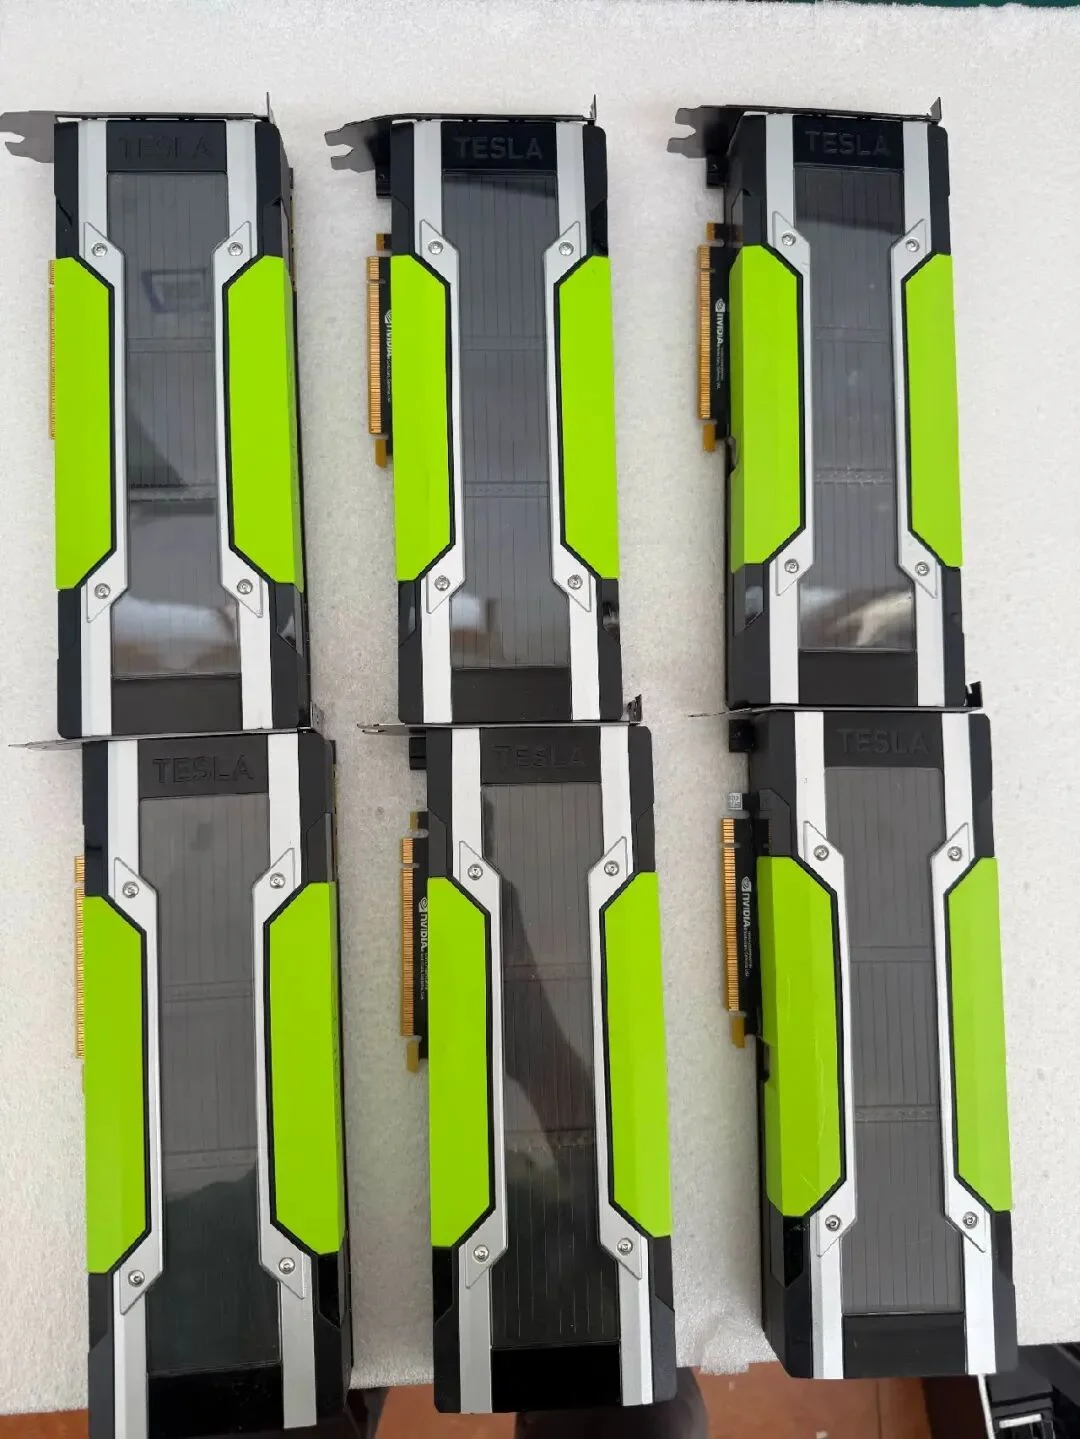
P40是2016年推出的Pascal架构推理卡,用训练好的模型生成结果。单卡24GB GDDR5决定能装多少权重,346GB/s显存带宽影响读取速度。它采用被动散热,靠服务器风道带走热量,单卡最高250W,四卡规格相加就是1000W,供电和散热配套很有分量。
商品列出的超微7048GR-TR,官方配置有四个PCIe 3.0 x16插槽、2000W冗余电源、多颗风扇,并提供被动GPU套件。卖家还列了浪潮NF5568M4,交付型号、电源配置需确认。超微这款深约67厘米,摆放还要留排风空间。
四张卡各有24GB独立显存,可用llama.cpp把模型层和KV缓存分配到不同卡上,每卡都要装得下,卡间通过PCIe传数据。
量化能缩小权重,代价是可能损失部分回答质量。现成GGUF文件中,Qwen2.5-32B-Instruct的Q4_K_M约19.85GB,Q8_0约34.82GB;Llama 3.1-70B-Instruct的Q4_K_M约42.52GB。
运行还要给KV缓存和计算缓冲留位置。KV缓存保存已处理文本的注意力信息,对话越长、并发越多,占用越大。
按单路对话、FP16缓存估算,Qwen32B开8192个token,KV约2GiB,Q8权重可考虑分到两卡;70B Q4分到四卡,开32768个token,KV约10GiB,容量仍有余地。两种方案都要另留计算缓冲,以每卡实际可用显存为准。token不等于汉字数,GB和GiB分别按十进制、二进制计量。
CUDA 13已移除Pascal离线编译支持。部署要选支持P40的llama.cpp构建,自行编译用CUDA 12.9或更早工具链,驱动也要选R580等兼容分支。
先选好兼容版本,省得搞成“拖拉机式努力”,环境折腾半天,模型还没开口。
速度可参考llama.cpp社区的单卡测试。在c76b420版本、CUDA后端、Llama 2 7B Q4_0、关闭Flash Attention的条件下,生成128个token约54.7 token/s。32B、70B需要读取更多权重,长输入也会增加等待。
按层分卡时,计算依次交给下一张卡,多卡首先扩展容量,单路回答不会自动快四倍。
双路E5负责系统、文本处理和任务调度,64GB内存供程序运行及模型加载使用。上述32B Q8、70B Q4文件各自都小于64GB,加载时仍需给系统和其他程序留空间。
硬盘可以从1TB SSD考虑,容纳系统、几个量化版本和文档索引。M.2转接卡本身不提供存储容量。
这套机器适合做私人文档问答库,先检索相关段落,再交给模型回答;也能离线改稿、整理长文、解释代码和起草脚本。整套软件都在本地运行,资料就可以留在自己的设备上。
经常处理不便上传的资料,又愿意维护软件,大显存才容易用出价值。每周只聊几次,投入、占地和风扇噪声就难摊薄。摆放宜避开工作、睡眠区域,免得AI还在干活,人先想说“我先润了”。
电费看插座实测功耗。假设整机平均800W,每天跑4小时,电价0.6元一度,30天约57.6元;全天维持同样平均功耗则约345.6元,空调另算。便宜的大显存搬回家,电表也算加入项目了。
5580元预算,你会选四卡P40跑70B,还是缩小模型、换台安静省电的机器?你想让本地AI干什么活?
这里是智选DIY装机,专注本地AI硬件方案,关注我,用最少的钱跑最大的模型。
文章来自于"智选DIY装机",作者 "智选DIY装机"。