
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
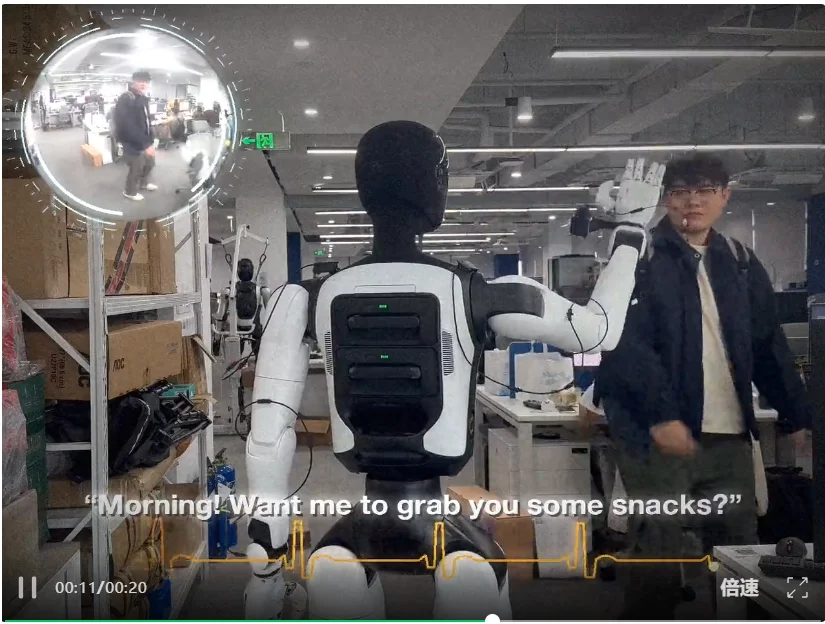
片头取自文末的完整演示。
现有的具身智能体大多存在一个结构性缺陷:它们是“任务驱动”的。接到指令,启动推理与工具调用;任务结束,系统归于沉寂。这种离散的交互模式,导致智能体缺乏对环境的持续感知,也没有跨时段的长程记忆。
当真实世界(如办公室、家庭)持续发生动态变化时,一旦需要回溯历史状态(如“一小时前谁来过”或“东西被挪到了哪里”),缺乏连续记忆的模型将无从下手。
为了解决这一问题,智元远征Research Team提出了 LIFE(Learning to Live)架构。该框架旨在让机器人具备持续感知、长期记忆存储与自适应探索的能力,推动具身智能从“即时响应”走向“终身学习”。
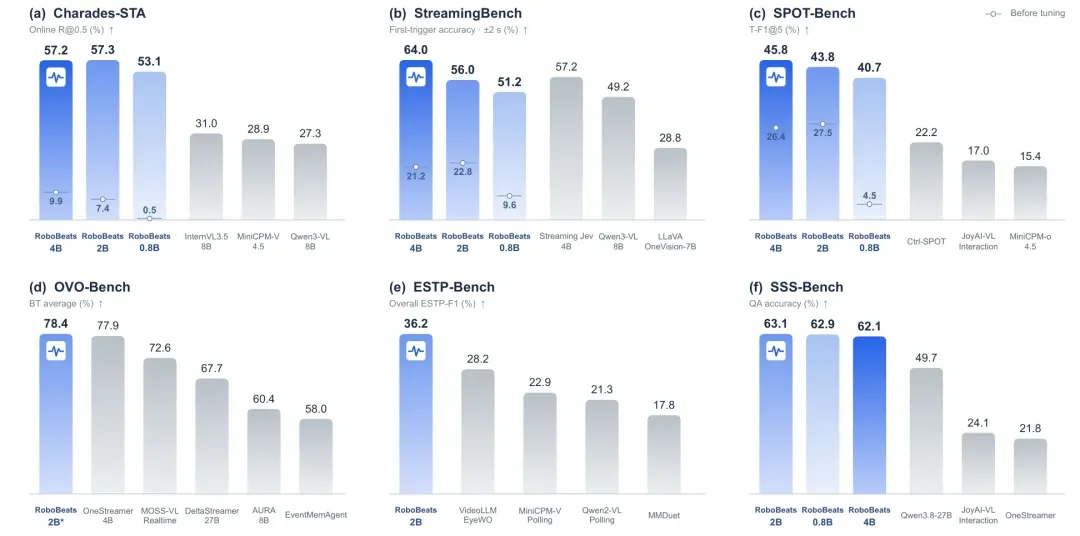
图 | 论文图1:从持续感知到记忆问答,RoboBeats 的六组基准测试结果。©【深蓝AI】编译
刚到一间办公室,你会先看看周围。谁坐在哪儿,东西放在哪里,什么时候适合打个招呼。有些事不用专门问,多待几天,自然就知道了。
我们也希望机器人能这样。有人在门口道别,它可以挥手回应;见过物品被挪走,下次就别再去老地方找。日子久了,再见到同一张脸,它能想起之前发生过什么,而不用每次都从自我介绍开始。
LIFE 的核心,是一个由多模态大模型(VLM)驱动的智能体。它把眼前看到的、过去记住的和用户的需求放在一起,判断接下来做什么,再调用工具行动。
但要熟悉一个地方,光等任务上门还不够。团队为它接上 RoboBeats,持续感知环境变化;经历则进入可塑性记忆(Plastic Memory),供日后回看;遇到不会解决的问题,再借助 EDM 探索新办法,把有效的办法留下。
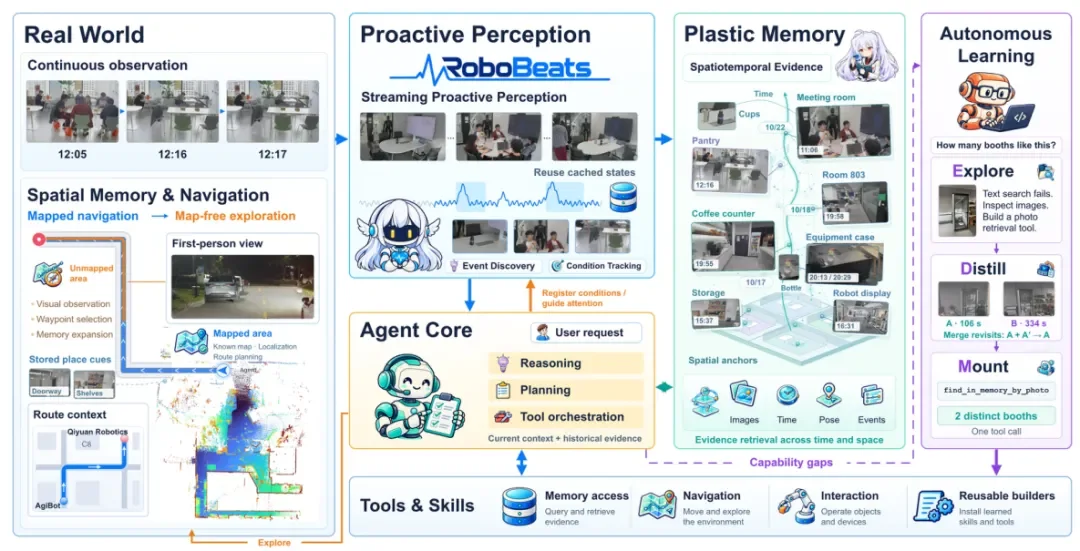
图 | LIFE 整体架构:持续感知与主动探索带来观察,记忆把经历存下来,智能体结合当前情境和历史证据推理、行动,并不断积累可复用的能力。©【深蓝AI】编译
交谈时,对方接起电话,我们会停下来;身旁有人把文件散落一地,我们可能问一句要不要帮忙。这些临场反应,往往不用等别人提醒。
VLM 智能体却常按“推理、调用工具、等待结果”的步骤往下走。工具还没返回,世界已经变了。机器人做着眼前的事,也得知道身边出了什么事。RoboBeats 就是在离散的工具调用与连续变化的现实之间,搭起这座桥。
这颗“心脏”是一个轻量决策模型(Decision Model),与 Jev 一类 System One 模型思路相近:不生成文字,直接判断每个条件成立与否的概率。
它复用视频流的计算缓存,让多个条件一起判断。在单张 RTX 5090 上,RoboBeats-2B 处理一帧新画面约 75 毫秒,同时盯住 16 个条件也只需约 77 毫秒。多留意几件事,延迟几乎没变。
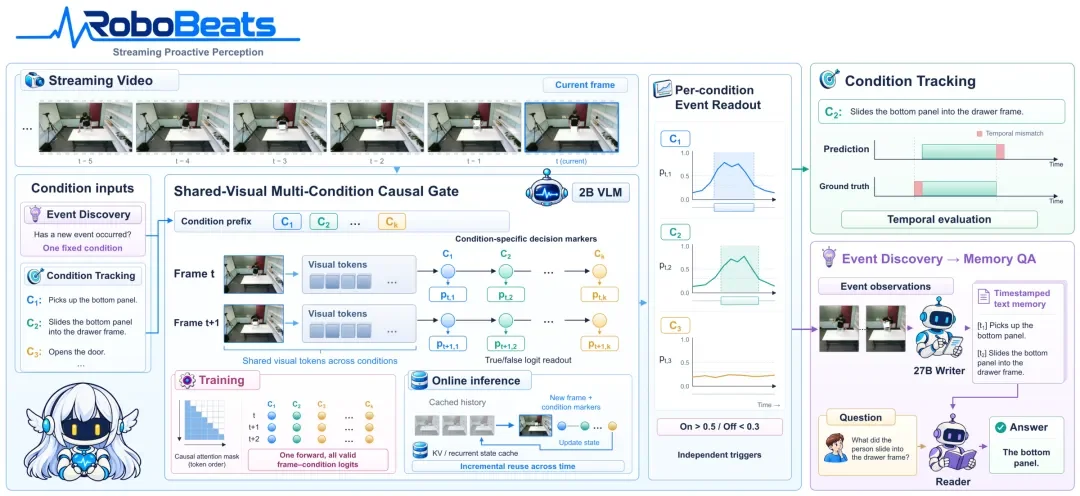
图 | 论文图4:RoboBeats 总览。多个条件共用一段视频流,每个条件独立给出概率。©【深蓝AI】编译
有任务时,智能体用自然语言告诉它要盯什么。RoboBeats 持续追踪条件何时出现、何时结束,让机器人能在行动途中调整,而不用等一个工具执行完,才发现情况早已不同。

图 | RoboBeats 主动感知实拍:条件一成立,机器人就行动。大图为第三视角,小窗为机器人第一视角,绿框亮起表示条件成立。©【深蓝AI】编译
在 StreamingBench 主动输出任务(PO)上,RoboBeats-4B 在参考时刻前后两秒内首次触发的准确率,从基座模型的 21.2% 提升到 64.0%;在 SPOT-Bench 上,动作边界检测 T-F1@5 从 26.4 提升到 45.8。
没任务时,它也在看:有人经过了,物品换了位置,画面里出现了新事件。RoboBeats 选出这些观察,交给后续模块理解和记录,再由智能体决定要不要回应。
记忆有限,就得记在点上。团队构建了 SSS-Bench:171 段视频,618 个问题,考验系统在不知道未来问题时,能否留下有用的观察。
写入同样数量的画面,使用相同的写入与问答模型,仅凭文本记忆作答(论文表 15),RoboBeats-2B 将准确率从 Qwen3.8-27B 筛选基线的 40.9% 提升到 60.5%,提高 19.6 个百分点。
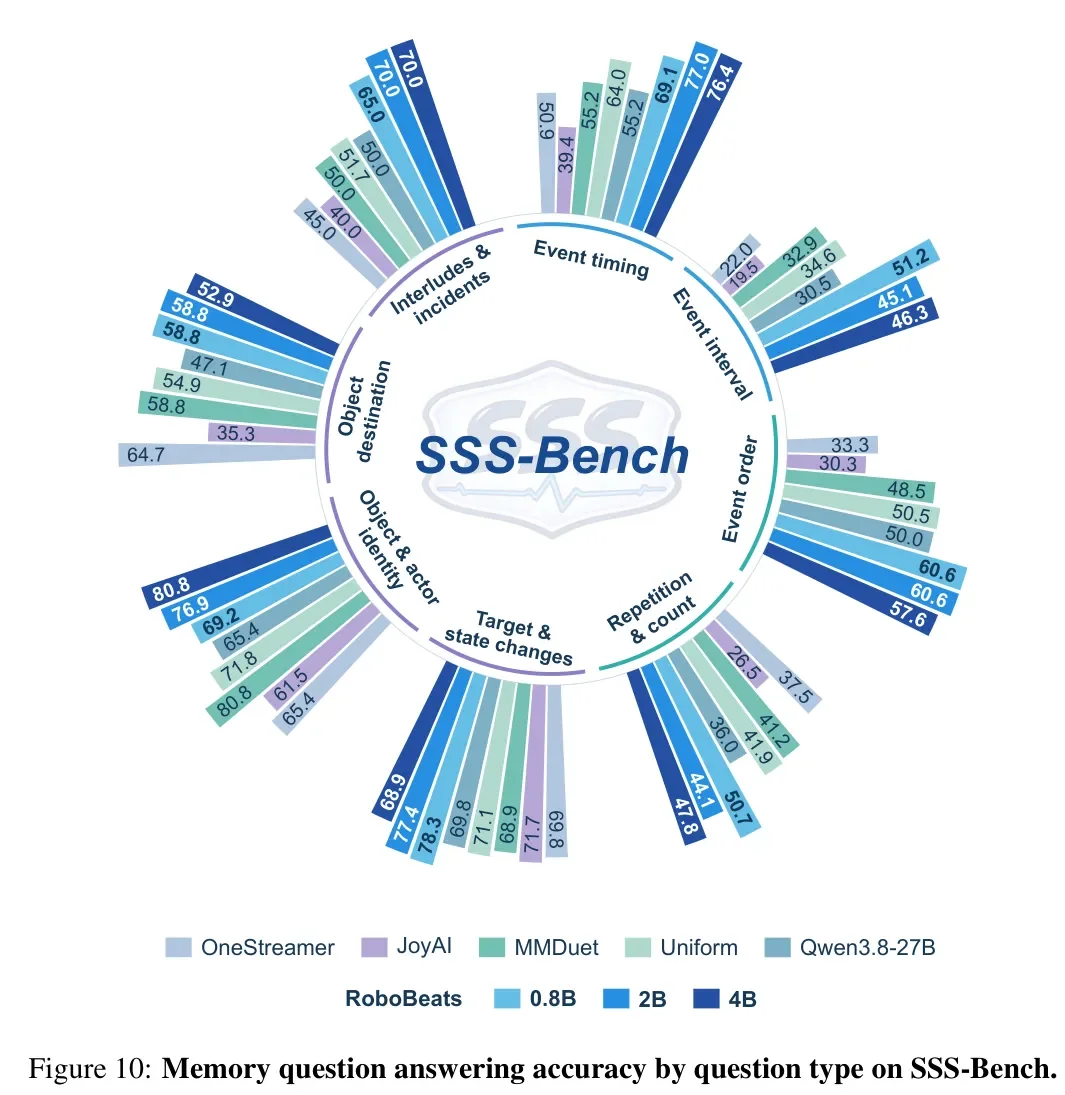
图 | 论文图 10:SSS-Bench 各类问题的问答准确率,涵盖事件时间、事件顺序、重复计数、物品去向等。©【深蓝AI】编译
在 OVO-Bench 回溯问答子集上,仅用文本记忆,相比 OneStreamer PHCM 构建的记忆,RoboBeats 门控方案让两种问答模型在情景记忆与动作序列识别两项任务上的平均成绩,分别提高 6.2 和 6.1 个百分点。
写入也能更省。在 OVO-Bench 的另一组对比中,同用 Qwen3.8-27B 写入模型,相比写入全部采样候选帧,RoboBeats 将写入端输入 token 减少约 45%。
你把外套搭上椅背时,大概不会特意叮嘱机器人记住。几个小时后找不到,才会问:“我的外套呢?”
难就难在,记录时谁也不知道,哪一个细节以后会派上用场。可塑性记忆会把当时的画面和当时的理解分开保存:原图留下现场,JSON 记录时间、位置、人物和物品等线索。
它采用扁平化设计,同一份记忆有两种用法。执行智能体通过工具检索,快速找到已有线索;会读文件、写程序的编程智能体(coding agent),则能回看原图,提取新信息,补上字段和索引。
比如,当初经过一扇门,只记下了位置。后来要找某个房间,就可以重看那张照片,读出门牌。当时没记进文字的细节,还留在画面里。
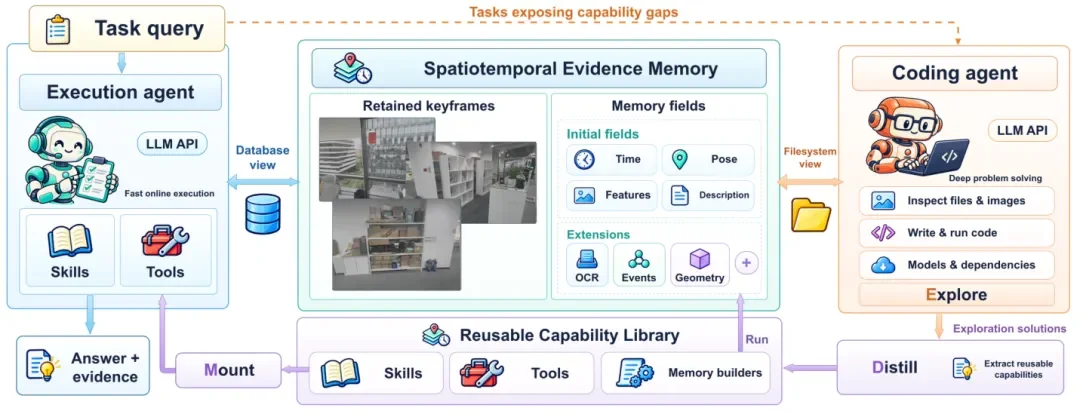
图 | Plastic Memory:保留当时的画面、时间与位置,让机器人在遇到新问题时,能够回看经历,提取新的线索。©【深蓝AI】编译
在 LIFE 的 24 小时真机记忆实验中,智元 A3 Ultra 连续采集了一天的第一视角视频,再基于构建的记忆回答问题。
记忆让回答有迹可循:中午十二点半,用户问起外套最后在哪里。机器人从当天的记忆中找到了十二点十八分的画面:外套搭在茶水间的椅背上,并返回了当时的拍摄位置。要判断会议室里的两只杯子属于谁,则需要把不同时间的观察串起来。它沿着人物到场和使用杯子的记录追查,找到了绿色杯子的归属依据;黑色杯子在参会者到来前就已出现,因而没有被贸然归给其中某个人。
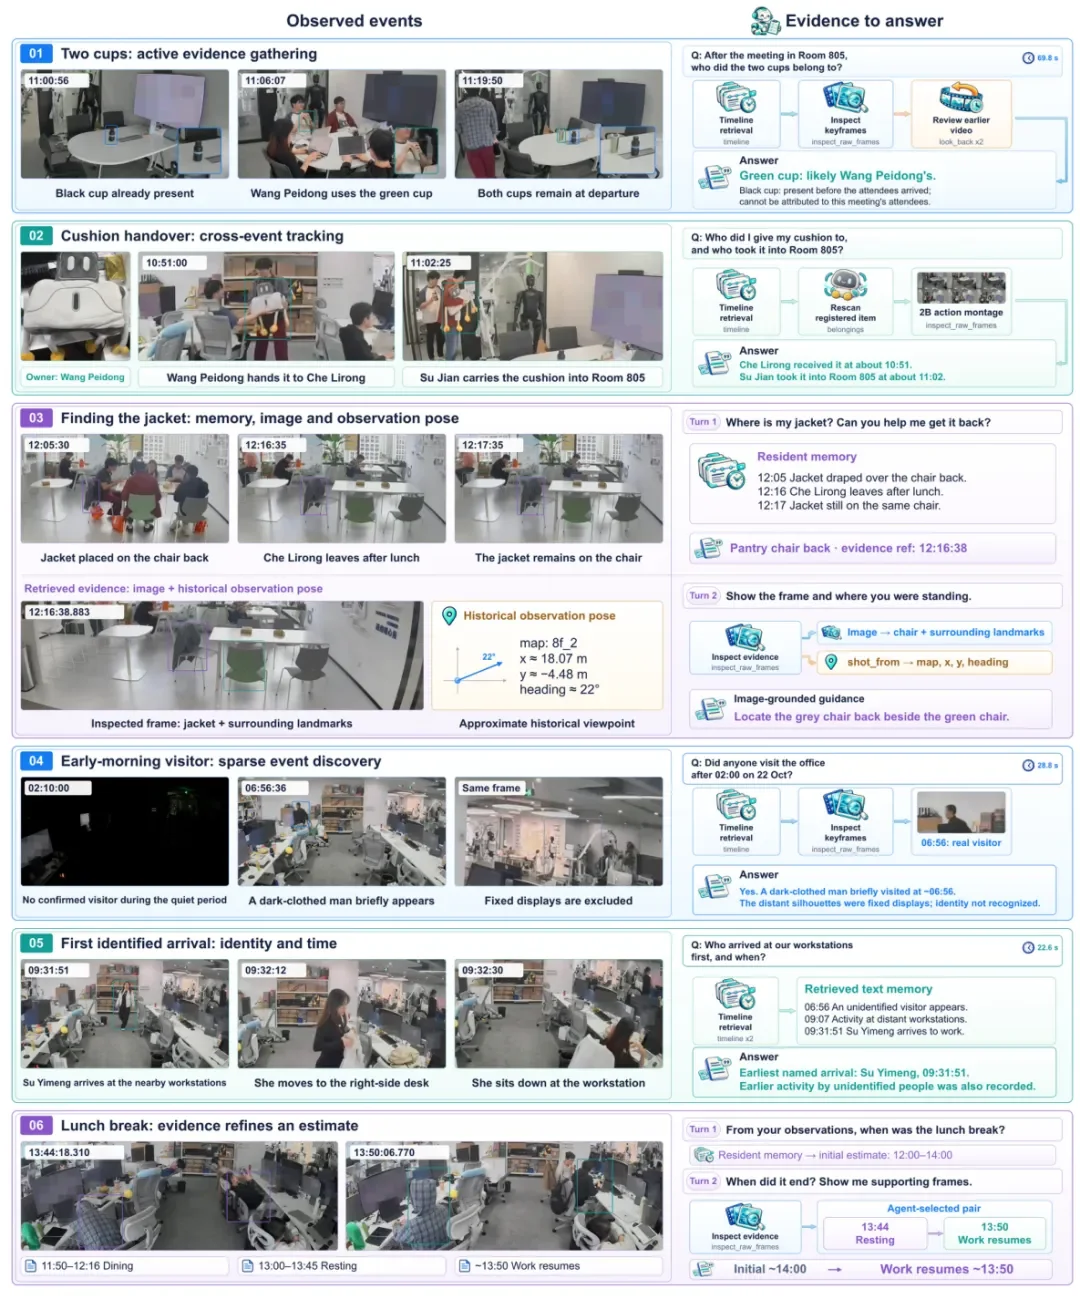
图 | 一天的机器人录像被构建为记忆,支持后来关于人物、物品和活动的不同问题©【深蓝AI】编译
围绕当天经历,团队选了六个问题。使用相同 GPT-6.1-sol 问答模型,LIFE 得到 29.5/30 分,平均用时 80.6 秒;同样拿到已构建记忆的 Codex 得到 28.5/30 分,平均用时 554.7 秒。
知道外套最后出现在哪里,下一次寻找就有了起点。到了茶水间,还要看看它是否仍在椅背上。记忆带机器人找到地方,眼前的新变化又被记下来。
“这样的电话亭,我以前见过几个?”
面对一张照片,机器人要翻查过去的画面,还得认出哪些照片拍的是同一个电话亭。现有工具做不到,就需要先想办法。
LIFE 沿用前作 ReSight 提出的探索—提炼—挂载(Explore–Distill–Mount,EDM)机制。编程智能体查看历史证据,编写程序,摸索检索和去重的方法。找到有效办法后,再提炼、验证,装进系统的工具箱。
这次摸索出的办法,下次不用从头再来。记忆里的画面没有变,机器人却多了一种查找和使用它们的方式。
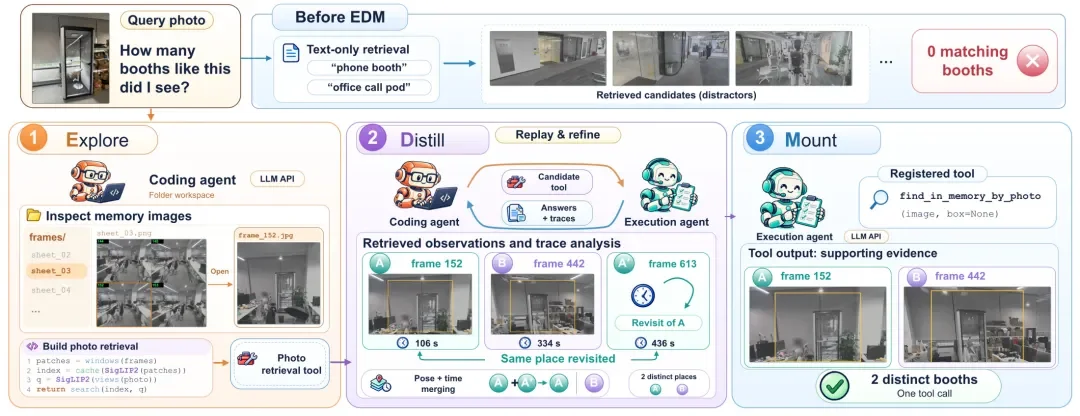
图 | 论文图 12:Explore–Distill–Mount。从“这样的电话亭我见过几个?”出发,编程智能体探索按照片检索的方法,合并同一电话亭的重复观测,最终挂载为可复用的工具。©【深蓝AI】编译
在 FindingDory 实验中,挂载 EDM 构建的能力后,系统在未参与能力构建的 597 个查询上,成功率从 37.5% 提升到 65.8%。测试期间,这些能力保持冻结,用先前探索出的办法解决新问题。
从记住一段经历,到学会怎样用它,记忆也有了继续成长的空间。
“帮我拿一下我的杯子。”
熟悉的人之间,这句话往往就够了。你曾告诉机器人哪只杯子是你的,或者它见过你端起那只杯子喝水。再想起最后在哪儿见过,它就知道该找哪一只、去哪里找。那些你没说出口的细节,过去的相处已经补上了。
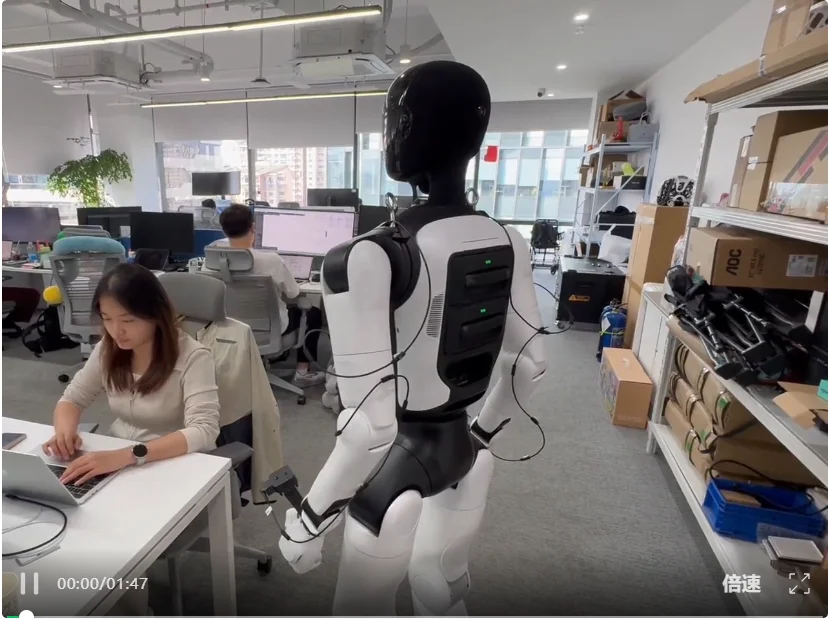
有时,甚至是机器人先开口。前两天来取零食的那个人,它还记得。再次遇见时,它先问要不要帮忙,得到同意后,便把零食取来送到对方手里。
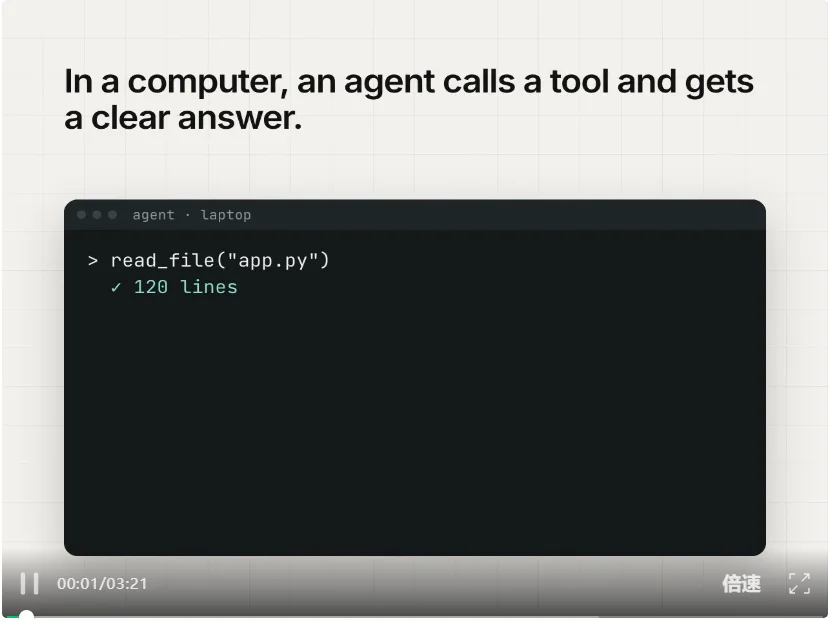
人与人相处久了会形成默契。
LIFE对终身具身智能的探索,希望让机器人也能慢慢积累起这样的熟悉,下次它回答时,终于可能带着与你共同经过的过去
心跳让它跟上世界,记忆让世界在它身上留下痕迹。
从此,每一个明天,都带着昨天的自己。
Learning to Live。
论文:Learning to Live: A Step Toward Lifelong Embodied Intelligence(https://arxiv.org/abs/2611.00180)
项目主页:LIFE 项目主页(https://agibotgeneral.github.io/life-site/)
项目与代码:GitHub · AgibotTech/LIFE(https://github.com/AgibotTech/LIFE)
模型下载:RoboBeats-0.8B(https://huggingface.co/superbigsaw/RoboBeats-0.8B) | 2B (https://huggingface.co/superbigsaw/RoboBeats-2B)| 4B (https://huggingface.co/superbigsaw/RoboBeats-4B)
文章来自于“深蓝AI”,作者“深蓝学院”。

【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
