# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
让机械臂把网球稳稳放到易拉罐上,既要识别物体,也要判断网球是否对准罐顶,以及何时松开夹爪。这些看似简单的操作,往往依赖细微的视觉信息。问题在于,动作模型能否充分利用这些信息?
近日,来自南洋理工大学 S-Lab、商汤研究院与 Ropedia 的研究团队提出 NEO-VLA,将原生视觉语言模型引入机器人动作学习。图像经过轻量卷积层转换后,与语言指令共同进入主干网络;负责生成动作的模块则直接读取主干不同深度的表征。整个视觉通路无需独立的预训练视觉编码器。
围绕这一设计,团队依次考察了四个问题:原生主干是否更适合动作学习?动作专家最依赖哪些层的信息?保留多模态理解能力对动作训练有何影响?模型在常规任务和场景变化下表现如何?研究者通过一系列对照实验,并结合仿真与真机测试,给出了回答。论文现已在 arXiv 公开。
目前,多数视觉语言动作(VLA)模型采用相似的处理流程:先由 CLIP、SigLIP、DINOv2 等预训练视觉编码器提取图像特征,再将这些特征交给语言主干和动作模块。动作决策通常从编码器的输出开始。
但抓取、对齐、插入等操作,需要利用物体边缘、局部几何、深度,以及夹爪与物体之间细微的状态变化。在视觉信息逐层抽象的过程中,部分与精细操作有关的线索可能变得不易利用。
已有研究发现,视觉模块对 VLA 的性能有显著影响,也对模型剪枝较为敏感;动作微调还可能损伤预训练的视觉表征。这些现象提示,视觉与动作之间的接口本身值得重新审视。
NEO-VLA 由此提出一个问题:如果动作模块能够直接访问视觉计算过程中形成的不同层次的表征,能否更好地利用其中与操作有关的信息?
从视觉处理方式与动作输出形式看,可以将相关设计分为三类。下图展示了它们的区别。
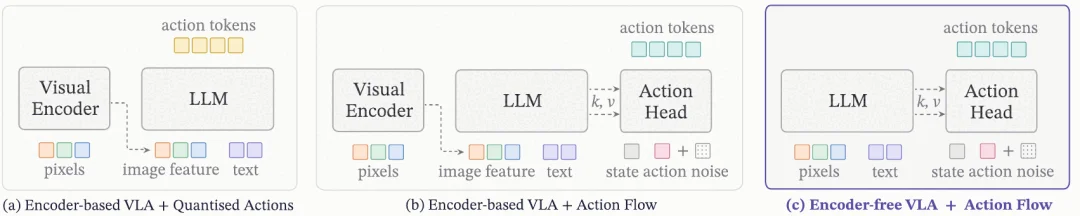
图 1 三类 VLA 设计的视觉接口与动作输出方式
区别在于,编码器式 VLA 即使读取语言主干的不同层,所用视觉信息也已经过独立编码器的处理。在 NEO-VLA 中,视觉与语言从主干的第一层起共同建模,因此,动作模块可以接触到视觉表征逐层形成的过程。「读取哪一层」也由此成为一个可以单独研究的设计问题。
NEO-VLA 以 NEO-2B 为基础。该原生多模态主干包含 40 层,参数量约为 20 亿,视觉通路中没有独立的视觉 Transformer、自编码器或离散视觉码本。主干之外,模型接入一个网络宽度较小、从随机初始化开始训练的动作专家。
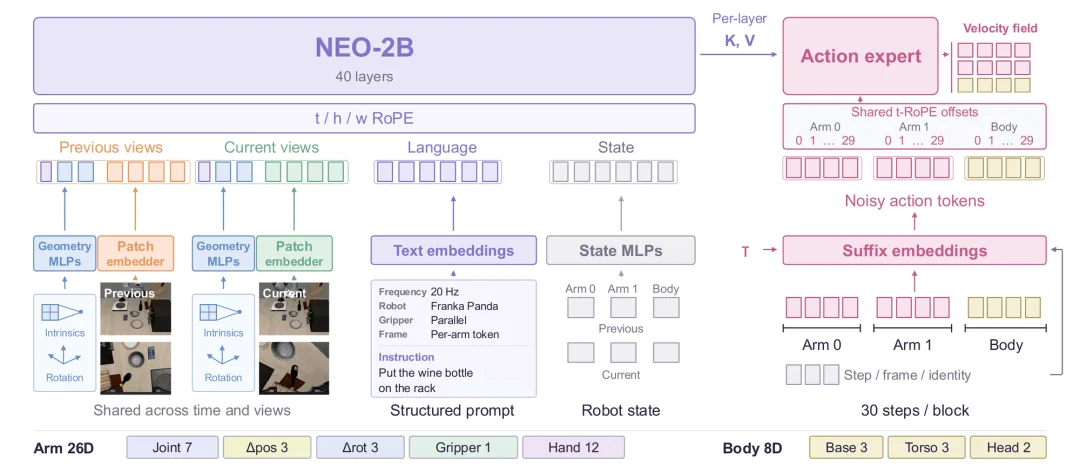
图 2 NEO-VLA 的多模态输入、主干网络与动作专家
将多视角图像与指令及机器人状态组织为统一输入
模型同时接收前一时刻与当前时刻的观测,每个时刻最多包含三个相机视角。每个视角的输入由相机标识、相机内参与旋转信息,以及图像分块后的视觉词元组成。所有视角和时刻共用同一个图像嵌入层;图像保留原始宽高比,每个视角最多使用 88 个视觉 Token。
视觉输入之后是一段结构化提示词,用于说明控制频率、机器人类型、夹爪配置、动作参考坐标系和任务指令。模型另用 6 个状态词元表示两只手臂与身体在前一时刻和当前时刻的状态。对于机器人不具备的部件,相应输入会被屏蔽,使同一套接口能够适配单臂、双臂及带移动底盘等不同配置。
通过层映射配置动作专家的读取位置
动作专家的每一层对应主干中的一个指定层,并读取该层缓存的 KV 表示。论文比较了四种层映射方案:
前三种方案使用相同规模的 28 层动作专家。其中,skip-28 与 end-28 保留的主干深度也一致,仅改变读取位置,是分析浅层信息作用时最直接的对照。first-28 同时缩短了主干,因此也改变了模型的计算量;full-40 则作为动作专家容量更大的配置单独讨论。
通过流匹配一次生成 30 步连续动作
动作专家采用流匹配,一次预测包含 30 个时间步的动作块,统一表示双臂与身体的动作。推理时,模型默认通过 10 步欧拉法求解生成动作。主干只需计算一次,随后每一步采样都复用同一份 KV 缓存。
分三个阶段完成动作训练
训练从适配动作专家开始,再逐步更新整个模型,并引入内部采集的机器人数据。
第一阶段冻结预训练主干,只训练动作专家与条件编码模块,共训练 113,400 步,全局批量大小为 8,192。
第二阶段解冻全模型,在同一机器人数据集上继续训练 75,000 步。为保留视觉语言理解能力,每隔一个优化步骤加入一批多模态理解样本。
第三阶段在第二阶段的模型基础上,使用内部数据继续进行 75,000 步全参数训练,其余训练配置沿用第二阶段。
汇集九类公开数据集的 223 万条轨迹
机器人预训练语料来自九类公开数据集:AgiBot-World、Bimanual YAM、RoboCOIN、Open X-Embodiment、Galaxea Open-World、RoboMIND、RH20T、DROID,以及仿真数据 InternData-A1。论文报告的完整语料共包含 2,231,583 条轨迹、约 9.28 亿条数据记录,覆盖 2,704 个场景和 7,444 个相机视角,已统计时长接近 1 万小时,涵盖单臂与双臂等多种机器人配置。
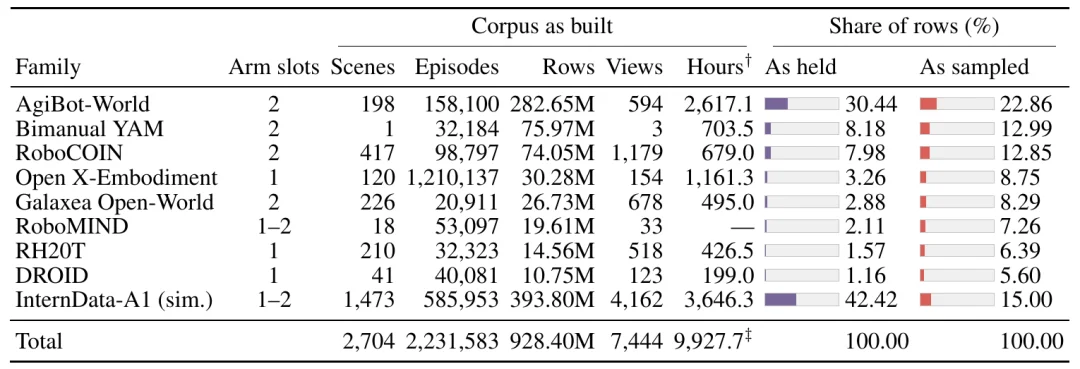
表 1 预训练语料构成及训练采样占比
将不同本体的动作映射到统一格式
不同机器人记录动作的方式并不一致。为进行联合训练,NEO-VLA 将它们转换为统一的动作格式,并通过有效性掩码区分各机器人实际具备的通道。
每只手臂使用 26 个维度,包括 7 个关节目标、3 维末端平移增量、3 维旋转向量增量、1 维夹爪状态,以及 12 个手部关节目标。
身体部分使用 8 个维度,分别对应 3 维底盘运动、3 维躯干动作和 2 维头部动作。
末端平移与旋转增量分别以厘米和弧度为单位,在相机坐标系或机器人基座坐标系下表达;关节与手部目标使用绝对值,身体动作采用基座坐标系。
动作按机器人本体分别归一化。对于不存在的部件、缺失的时间步或无效通道,模型通过掩码将其排除在训练损失之外。
分层处理数据异常并保留有效信息
公开机器人数据的采集方式和标注质量并不统一。团队设计了五类质量检查,并根据异常所在的层级分别处理读数、通道、动作目标、轨迹和标定信息,避免因局部问题丢弃仍有价值的整条轨迹。
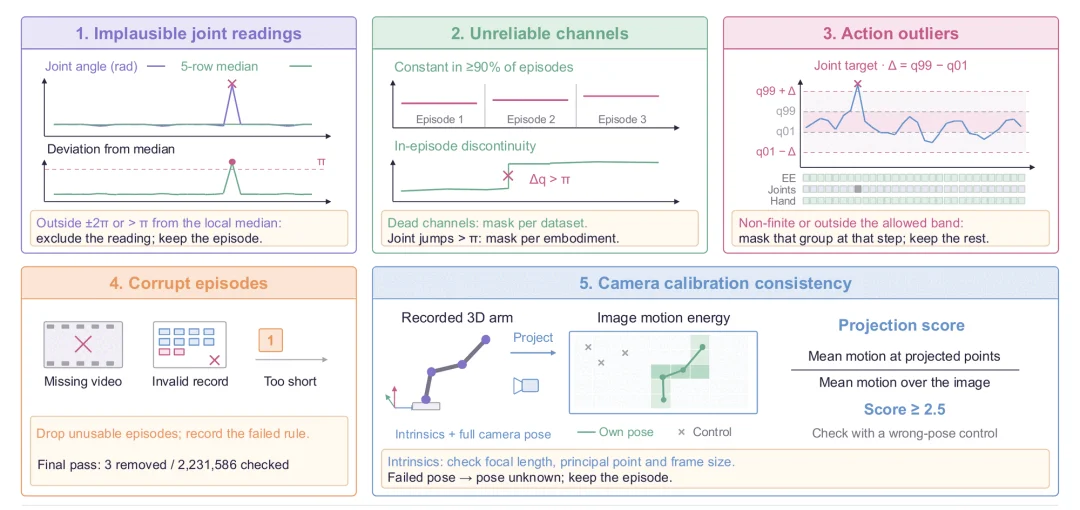
图 3 五类数据质量检查及对应的处理范围三个实验发现
原生主干在冻结状态下已能有效支持动作学习
原生主干提供的表征,是否更适合动作学习?为回答这一问题,团队为 NEO-2B、Qwen3-VL-2B 和 Gemma-3-4B 配置相同设计的动作专家,在 Open X-Embodiment 上使用相同设置预训练 75,000 步,再比较它们在 LIBERO 上的表现。
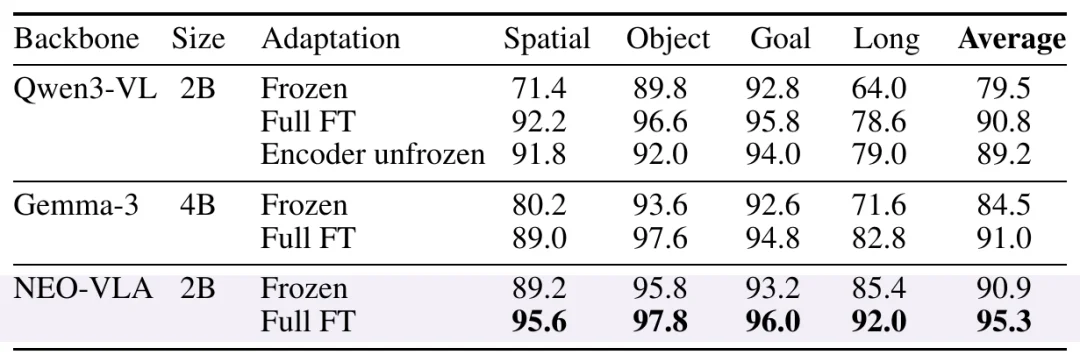
表 2 不同主干在 LIBERO 上的受控对比
冻结主干、仅训练动作专家时,NEO-VLA 的平均成功率达到 90.9%,高于 Qwen3-VL 的 79.5% 和 Gemma-3 的 84.5%。这一成绩已接近后两者全量微调后的 90.8% 和 91.0%;在 LIBERO-Long 上,冻结主干的 NEO-VLA 达到 85.4%,也超过了两者全量微调后的成绩。
这说明,NEO 的预训练表征已经能够较好地迁移到动作任务。
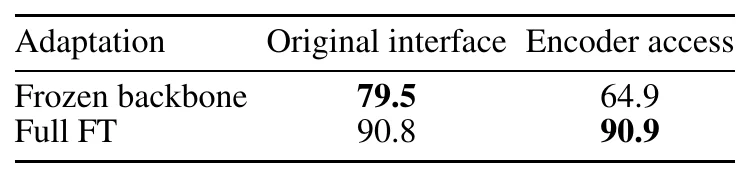
表 3 让 Qwen3-VL 动作专家直接访问视觉中间特征的对照结果
这种优势是否仅仅来自对视觉中间特征的访问?研究者在 Qwen3-VL 上进行了额外对照,将动作专家中的 13 层直接连接到视觉编码器的中间特征,且不增加参数。冻结主干时,这种接法使成功率从 79.5%降至64.9%;全量微调后,新旧接口的结果则十分接近,分别为 90.9% 和 90.8%。
因此,让动作模块接触到中间特征,本身并不足以获得同样的提升。这些结果提示,原生视觉语言预训练形成的表征更有利于动作学习,表征的学习方式与读取方式需要一起考虑。
不同主干的预训练数据和模型容量仍有差异,因此不能把全部收益归因于移除视觉编码器这一结构变化。但在这组对照中,原生主干无论冻结还是全量微调,都表现出了较好的动作迁移能力。
动作预测对浅层信息尤其敏感
动作专家究竟在使用哪些层的信息?团队首先比较了各种选层策略,以及冻结 backbone 的影响,发现浅层连接非常重要。
为了进一步确定哪些信息影响动作,研究者在动作专家的各个读取位置分别进行干预。
首先,将某个读取位置的 KV 表示替换为另一条观测的表示。替换发生在第 0 至 10 层时,动作平移预测误差增加最明显。作为对照,研究者加入幅度匹配的噪声扰动,误差与未干预时相差不足 0.004 厘米。这说明,模型对这些层的敏感性主要与表征内容有关。
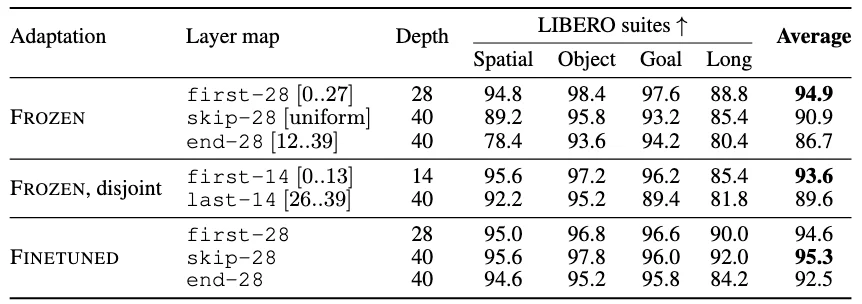
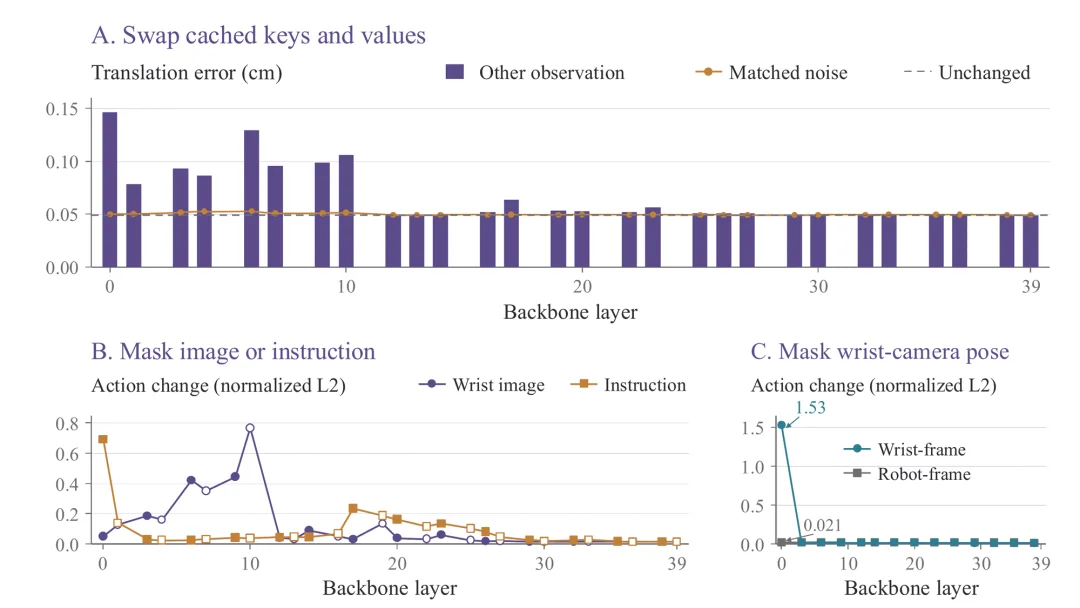
图 4 不同读取位置对表征替换及输入信息屏蔽的响应
这些结果表明,与动作有关的信息分布在主干的不同深度。冻结主干时,浅层表征尤为关键;全量微调后,结合多个深度的信息效果更好。语言、外观和几何信息对动作预测的影响,也呈现出不同的深度分布。
在动作后训练中保留理解数据仍然重要
模型学习动作后,原有的多模态理解能力会发生什么变化?团队比较了两种后训练方式:只使用动作数据,以及将动作数据与通用多模态理解语料联合训练,并以后训练开始前的模型作为参照。
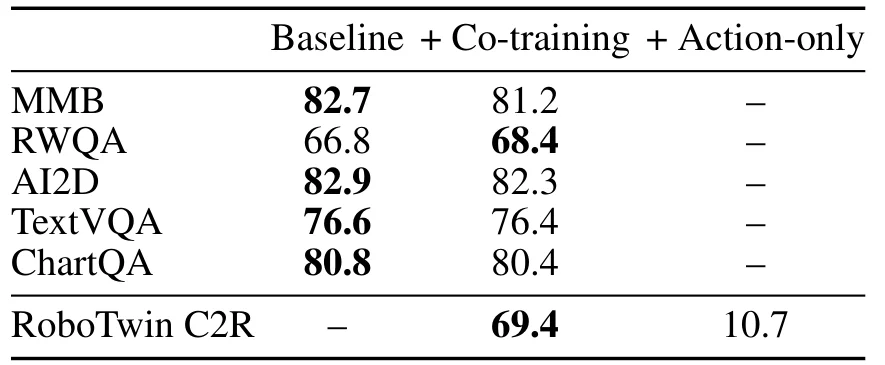
表 4 理解与动作联合训练和仅用动作数据训练的比较。仅用动作数据训练的模型无法生成有效文本,五项理解基准的结果以「—」标示。
联合训练后,模型在 MMBench-EN、RealWorldQA、AI2D、TextVQA 和 ChartQA 五项理解基准上的表现整体保持稳定。其中四项的下降均不超过 1.5 个百分点,RealWorldQA 则提升了 1.6 个百分点;同时,RoboTwin 2.0 Clean2Rand 的动作成功率达到 69.4%。
相比之下,仅使用动作数据后训练的模型已无法生成有效文本,五项理解基准的结果在论文中以「—」标示;其 Clean2Rand 动作成功率也降至 10.7%。
这组结果表明,多模态理解与稳健的动作能力密切相关。在动作后训练中继续加入理解数据,既能保留主干已有的理解能力,也有助于策略适应随机化场景。
前面的受控实验用于分析模型设计,下面则考察完整模型在不同任务中的表现。由于各项工作的模拟器版本、相机配置、训练数据和评测协议并不完全一致,跨论文成绩主要用于提供参考,不应视为完全相同条件下的严格对照。
LIBERO
在完整模型的 LIBERO 评测中,平均成功率达到 97.4%。目前,多种方法在这一基准上的成绩已较接近,因而这一结果主要说明 NEO-VLA 保持了较强的分布内操作能力。该结果与前文主干对照实验的训练和评测设置不同。
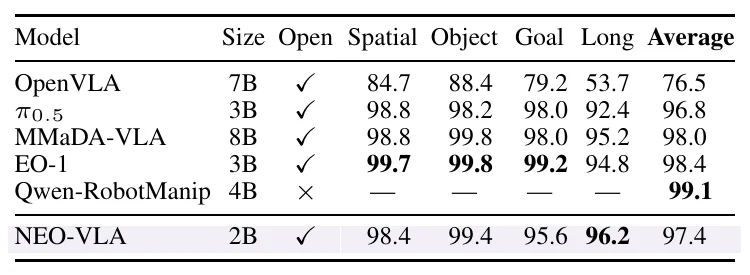
表 5 完整模型的 LIBERO 基准成绩
LIBERO-Plus 检验七类扰动下的鲁棒性
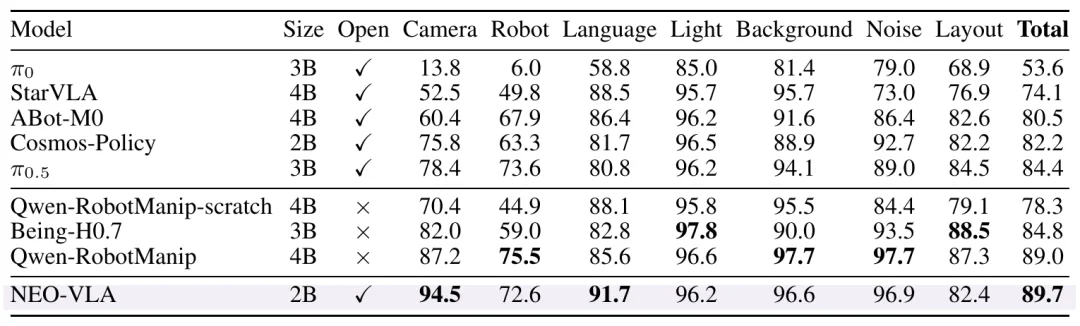
表 6 LIBERO-Plus 七类扰动下的成绩
结果显示,NEO-VLA 对观测方式和图像条件的变化适应得更好,这与前文浅层视觉表征的分析相呼应;本体或空间配置的变化仍然是更困难的问题。
LIBERO-Pro 揭示空间与任务泛化的难点
在 LIBERO-Pro 上,NEO-VLA 在指令语义变化下获得 98.0;物体外观变化下的成绩为 84.3。但当物体位置或任务目标改变时,表现不佳,其他方法在这两类测试中也普遍面临困难。这个差距表明,较好的感知与语义鲁棒性,还不能直接转化为灵活的空间和任务适应能力。
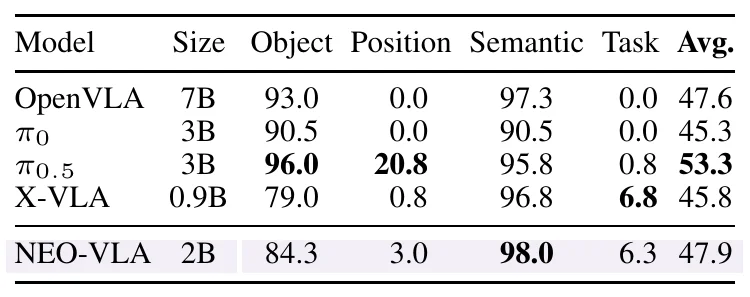
表 7 LIBERO-Pro 上的外观、位置、语义与任务泛化成绩
RoboTwin 2.0 检验随机化环境中的表现
在官方的 2,500 条示范轨迹设置下,NEO-VLA 在 Clean 测试中的成绩为 75.78,在随机化场景的 Clean2Rand 测试中仍达到 69.40,下降 6.38 个百分点。
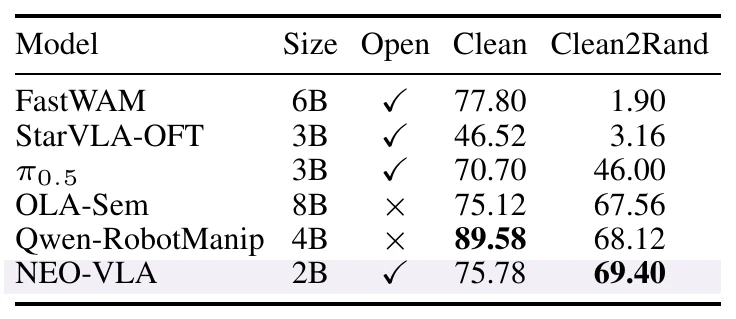
表 8 RoboTwin 2.0 干净场景与随机化场景的成绩
每个任务用 50 条示范完成真机微调
团队设置了三个真机任务,分别考察精确放置、多步操作与物体姿态调整:将网球放到易拉罐上;先将胶带卷放入碗中,再将网球放入胶带卷;将横放的易拉罐立起并插入胶带卷。每个任务使用 50 条示范进行微调,随后测试 20 次,其中分布内与分布外初始配置各 10 次。
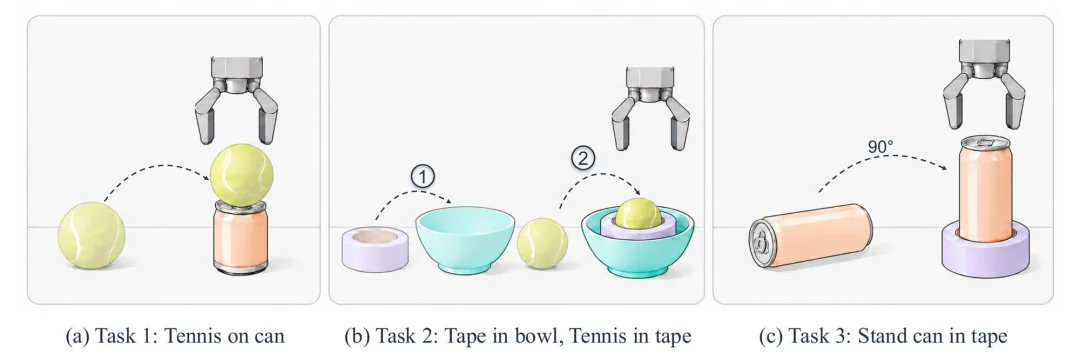
图 5 三个真机定量评测任务
在使用相同真机数据、各自采用推荐后训练配置的条件下,NEO-VLA 在三个任务中分别成功 12、17 和 13 次;StarVLA 分别成功 1、2 和 0 次,π0.5 分别成功 10、14 和 13 次。NEO-VLA 在三个任务上的成功次数均不低于 π0.5。
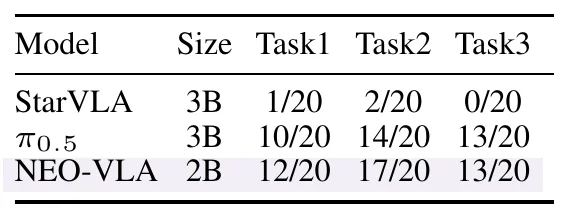
表 9 三个真机任务的成功次数,每项共测试 20 次
除了上述三项定量任务,团队还展示了倒水,以及从混合寿司中逐一挑出四个军舰寿司并摆入盘子的操作。这些补充演示用于呈现模型能够完成的操作类型,未计入前三项任务的成功率统计。
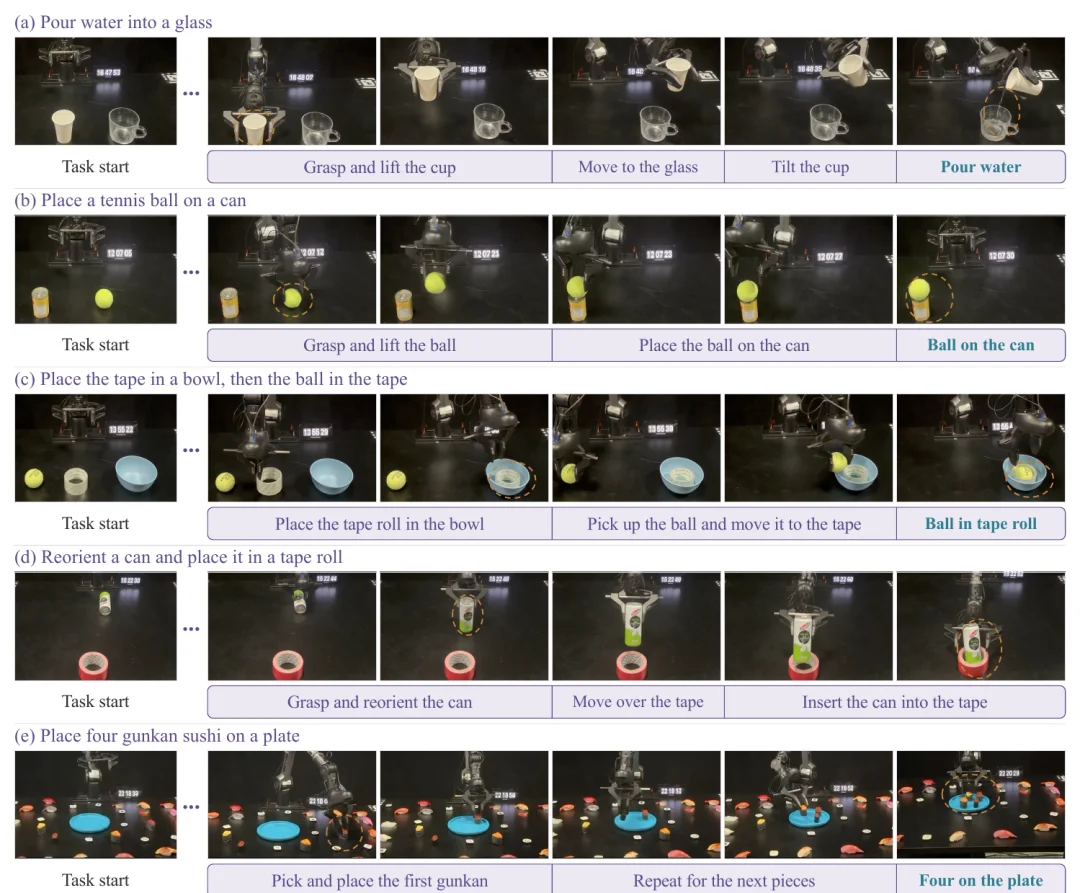
图 6 真机操作演示与关键动作过程
单张 RTX 3090 上约 0.26 秒返回一个动作块
团队还在 Pika 真机系统上测量了推理延迟。策略运行于单张 24 GB 显存的 RTX 3090,采用 BF16 精度,每次请求返回一个包含 30 步的动作块。实验直接执行预测动作,未使用 RTC。
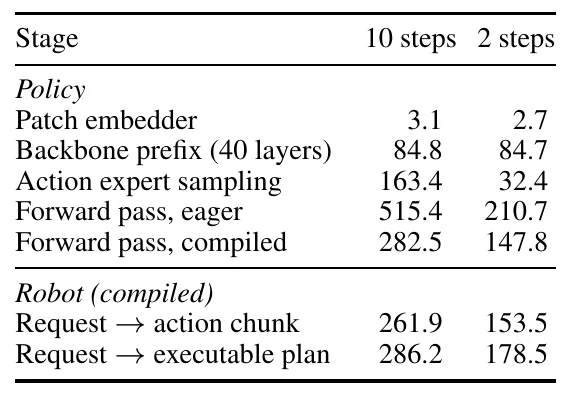
表 10 模型前向与真机请求链路的延迟,单位为毫秒
NEO-VLA 的实验表明,动作学习既受视觉表征形成方式的影响,也取决于动作模块能否读取视觉计算不同阶段的信息。原生主干在冻结状态下就能有效支持动作学习,对浅层表征的访问也尤为重要。与此同时,直接读取传统视觉编码器的中间特征,并未带来同样的收益。这些结果提示,表征如何学习、又如何供动作模块使用,需要放在一起考虑。
模型对外观和观测条件变化的适应能力已经有所体现,但新的空间布局与任务目标仍然带来明显挑战。下一步的问题,是如何将已有的感知与理解能力转化为更灵活的动作,让机器人在几何关系或任务意图改变后,仍能调整操作策略。
文章来自于机器之心",作者 "机器之心"。