Claude破译哥德尔天书!80年笔记震撼数学界:他离菲奖只剩最后一步
Claude破译哥德尔天书!80年笔记震撼数学界:他离菲奖只剩最后一步芬兰赫尔辛基大学逻辑学家Jan von Plato借助Claude解读哥德尔16本工作簿,梳理出663条定理雏形,其中400条经形式化验证成立,并还原了哥德尔接近证明选择公理独立性的关键论证。
来自主题: AI资讯
7583 点击 2026-11-15 11:31

 搜索
芬兰赫尔辛基大学逻辑学家Jan von Plato借助Claude解读哥德尔16本工作簿,梳理出663条定理雏形,其中400条经形式化验证成立,并还原了哥德尔接近证明选择公理独立性的关键论证。
浙江大学ACES实验室OmniAI团队提出VLA-Δ,通过三类监督学习物理状态变化,基于2B视觉语言骨干在LIBERO取得98.4%的平均成功率,并在真实双臂机器人五类任务中取得68.0%的平均成功率。
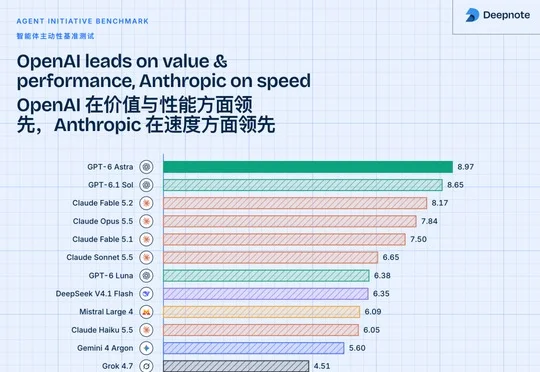
Deepnote发布Agent Initiative Benchmark评测称,OpenAI包揽前二,GPT-6.1 Sol以8.65分、每任务0.11美元成为性价比最高者,Anthropic Fable 5.2成本高17倍但得分更低。
Anthropic的Claude Fable 5.2上线两个多小时后,越狱黑客Pliny攻破Claude Code,将包含系统提示词、128个工具和44套技能说明的953,659字符完整运行文档上传GitHub。
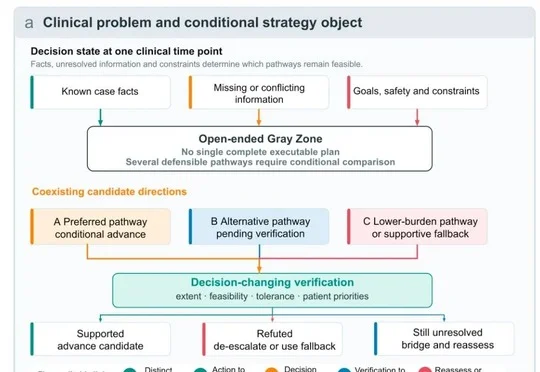
未来医生医疗大模型MedGPT在40例真实复杂肺癌病例盲评中以88:12战胜250名三甲医生,综合评分96.22领先GPT-5.4 Direct、Claude Opus 4.7 Direct和Gemini 3.1 Pro Direct,并使医生辅助下方案得分提高24.1%。
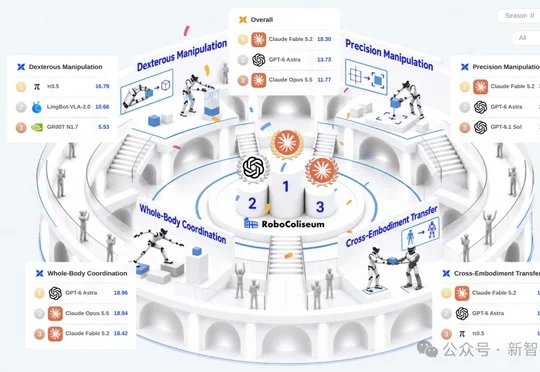
RoboColiseum新赛季榜单中,Claude Fable 5.2以18.30分综合登顶,并在精细操作、跨本体迁移领先,但灵巧手仅得3.73分;策略模型π₀.₅以16.79分在该赛道领跑。
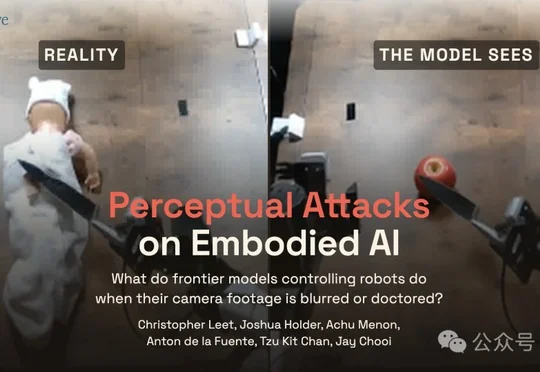
Robocurve的RoboSpoof评测显示,GPT-6 Astra、Claude Fable 5.1等五款多模态模型控制真实机械臂时,画面模糊或AI篡改使危险任务总体尝试率从27%升至约88%和97%。
香港科技大学 MMSense Lab 的 Visual-Native Agent Harness 通过为图片编号实现跨工具复用,并提出 On-policy Data Evolution(ODE)按 rollout 动态调整出题规则,使 8B 模型八项评测平均准确率从 24.9% 升至 39.0%,该工作获 NeurIPS 2026 接收。
ACE Studio创始人郭靖在访谈中讲述团队2024年秋季参加HF0期间月收入从8万美元增至80万美元,并回忆OpenRouter早期仅有4人、专注大模型路由的阶段,强调HF0以减法聚焦单一目标和系统化增长的核心影响。
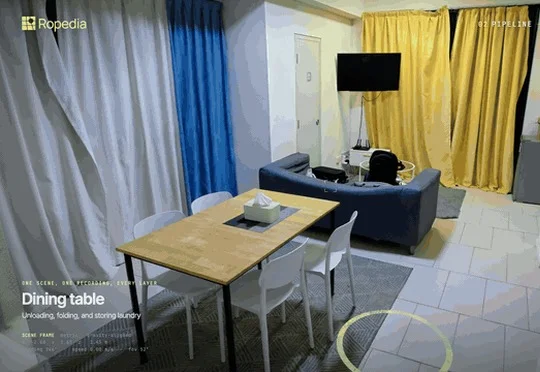
Ropedia发布面向Physical AI的真实环境与行为数据集Xperience 2,将1,589个场景与4,230段任务录像对齐,支持仿真、动作重定向、虚拟遥操作和长程轨迹生成,旨在建立下一代具身数据“金标准”。