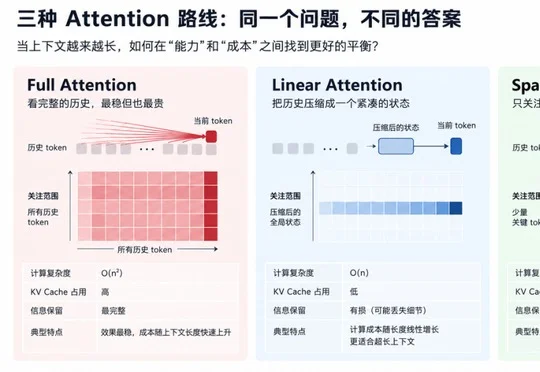
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
来自主题: AI技术研报
6320 点击 2026-09-25 10:11

 搜索
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。