面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP'26
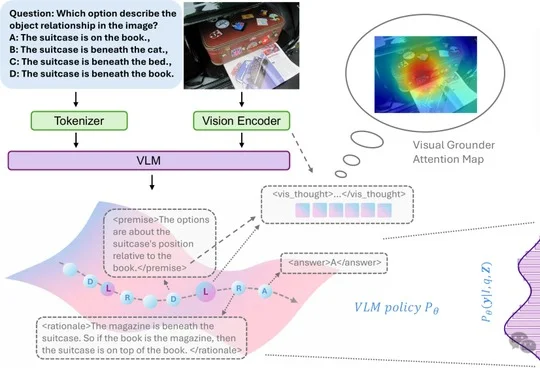
面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP'26埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
来自主题: AI技术研报
7884 点击 2026-09-28 16:22

 搜索
埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。