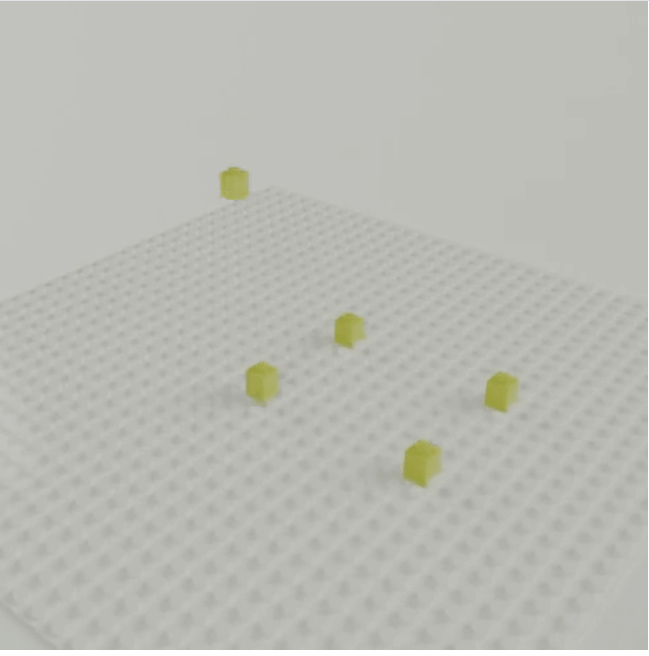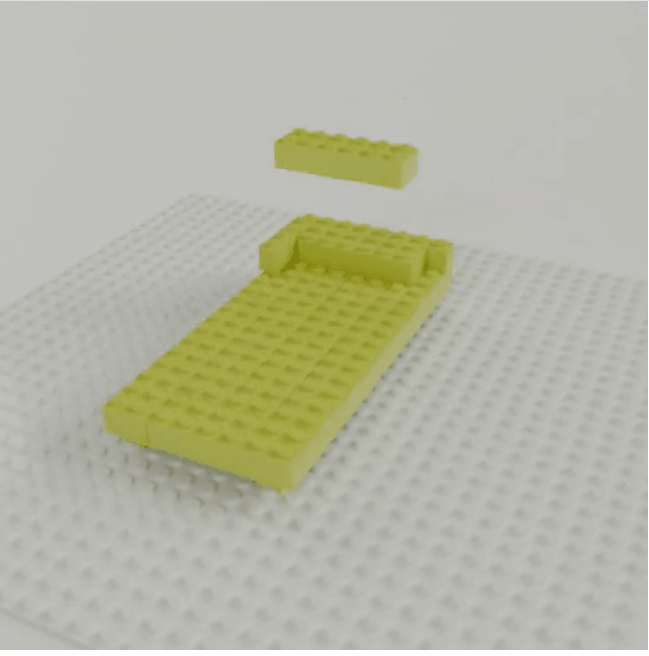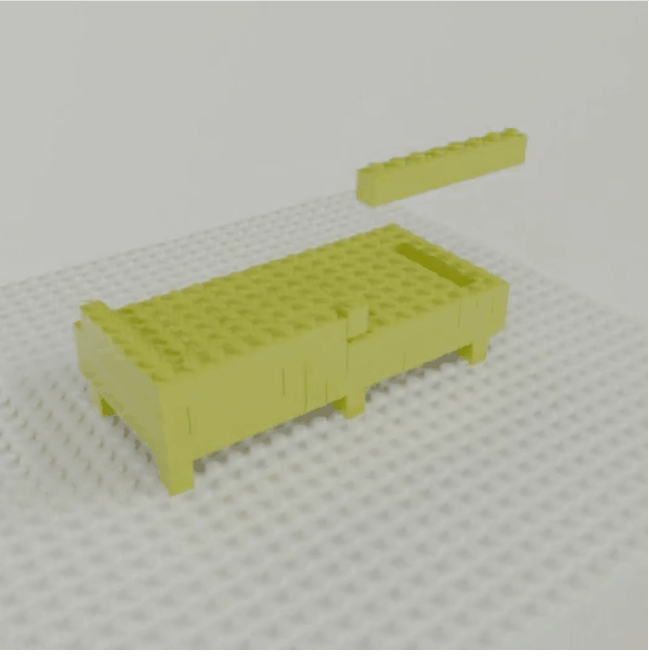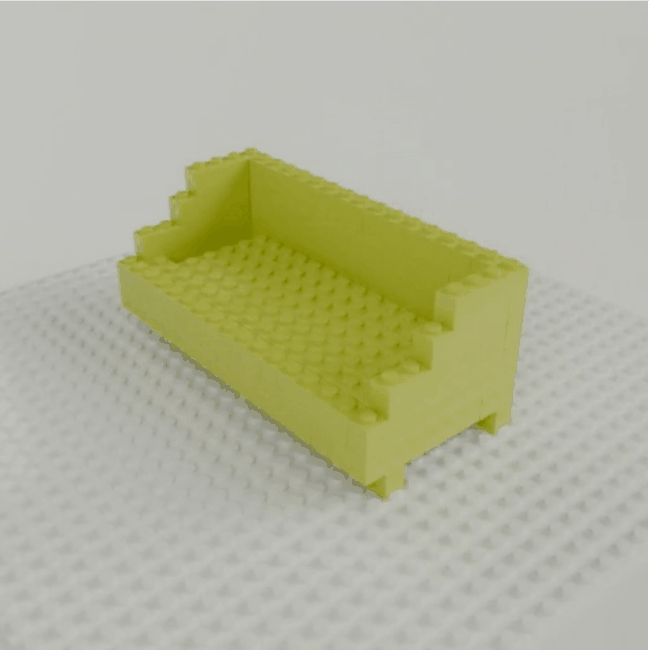
CMU朱俊彦等上新LEGOGPT,一句话就能搭乐高,网友:复杂零件行不行?
CMU朱俊彦等上新LEGOGPT,一句话就能搭乐高,网友:复杂零件行不行?AI 不允许有人不会搭乐高。
来自主题: AI技术研报
10903 点击 2025-05-12 16:14

 搜索
AI 不允许有人不会搭乐高。
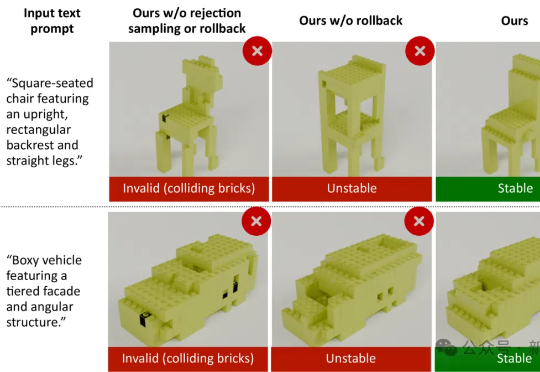
如何将一句简单的文字描述变成物理稳定的乐高模型?LegoGPT通过物理感知技术,确保98.8%的设计稳如磐石。
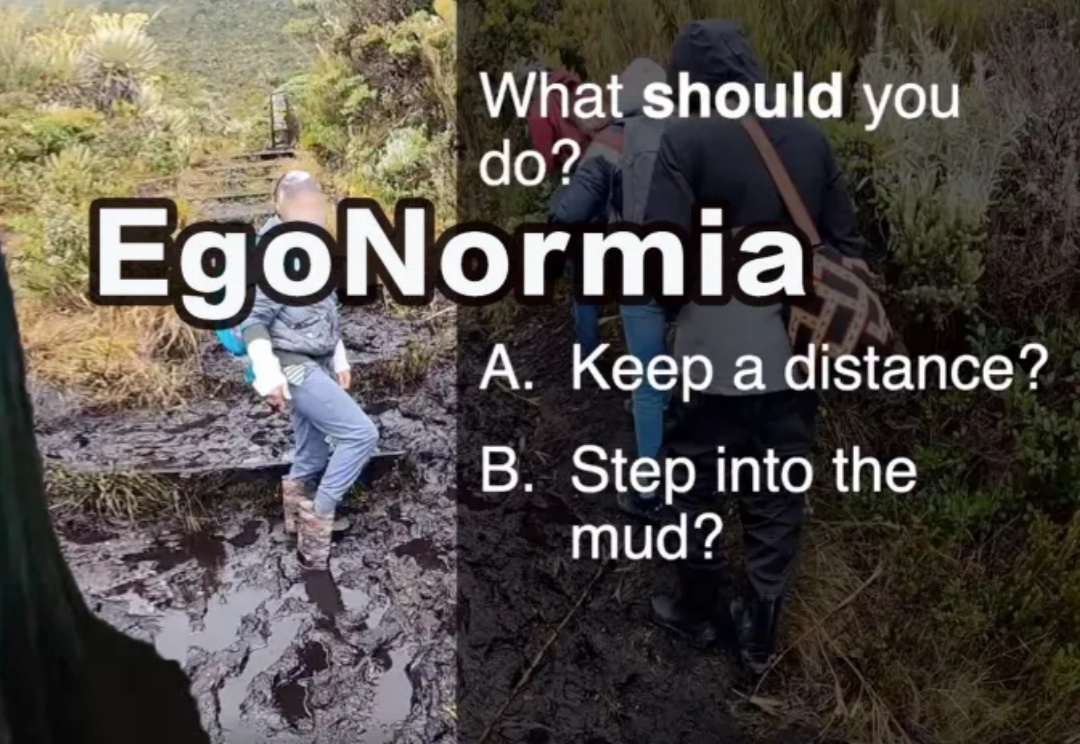
EgoNormia基准可以评估视觉语言模型在物理社会规范理解方面能力,从结果上看,当前最先进的模型在规范推理方面仍远不如人类,主要问题在于规范合理性和优先级判断上的不足。
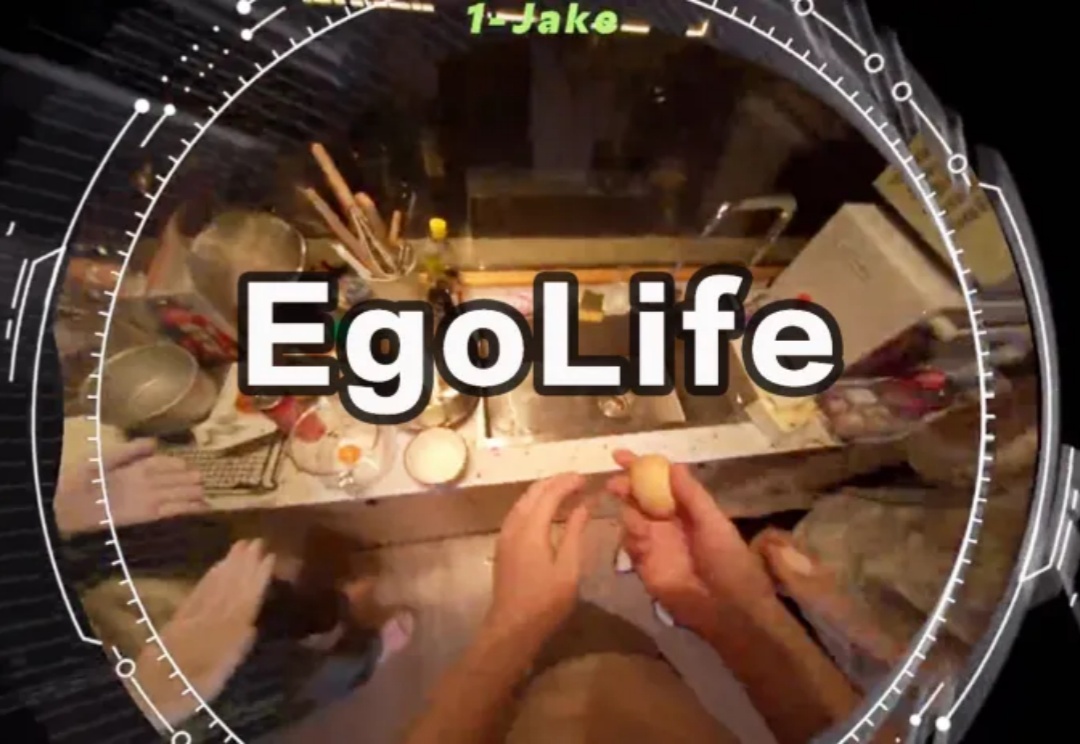
通过收集六名志愿者一周的多模态生活数据,研究人员构建了300小时的第一视角数据集EgoLife,旨在开发一款基于智能眼镜的AI生活助手。项目提出了EgoButler系统,包含EgoGPT和EgoRAG两个模块,分别用于视频理解与长时记忆问答,助力AI深入理解日常生活并提供个性化帮助。
Maitrix.org 是由 UC San Diego, John Hopkins University, CMU, MBZUAI 等学术机构学者组成的开源组织,致力于发展大语言模型 (LLM)、世界模型 (World Model)、智能体模型 (Agent Model) 的技术以构建 AI 驱动的现实。
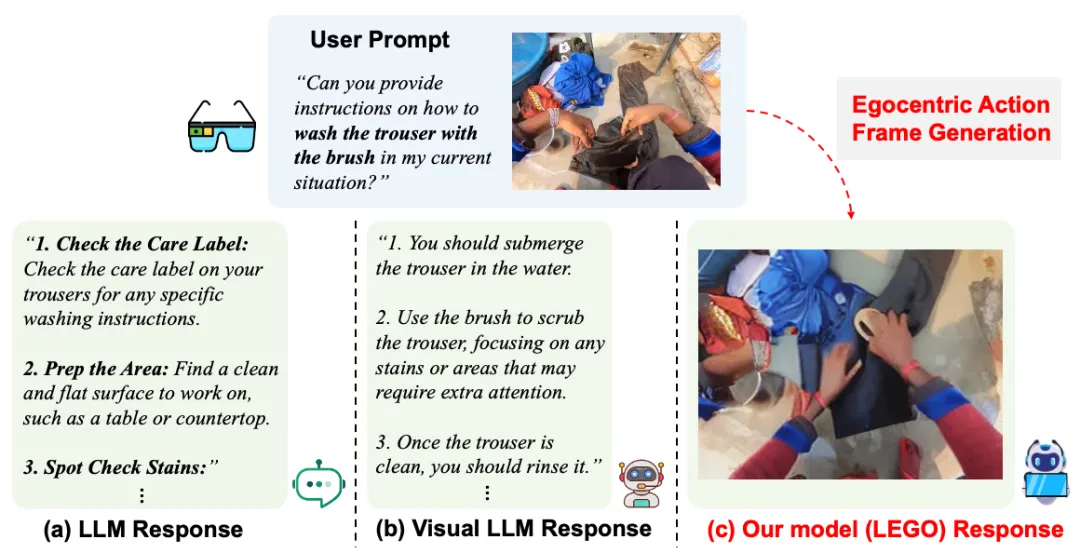
如何基于用户的问题和当前场景的照片,生成同一场景下的第一视角的动作图像,从而更准确地指导用户执行下一步行动?
在探索人工智能边界时,我们时常惊叹于人类孩童的学习能力 —— 可以轻易地将他人的动作映射到自己的视角,进而模仿并创新。当我们追求更高阶的人工智能的时候,无非是希望赋予机器这种与生俱来的天赋。
多模态大模型GPT-4V也会「有眼无珠」。UC San Diego纽约大学研究人员提出全新V*视觉搜索算法逆转LLM弱视觉宿命。

字节&复旦大学多模态理解大模型来了:可以精确定位到视频中特定事件的发生时间。