马斯克挖走Claude最强“产品大脑”Jenny Wen
马斯克挖走Claude最强“产品大脑”Jenny Wen马斯克将Anthropic的Claude Cowork核心设计者Jenny Wen招入SpaceXAI,她已加入Cursor担任设计负责人,并将把产品与交互设计经验用于Grok Bot。
来自主题: AI资讯
8290 点击 2026-11-01 09:23

 搜索
马斯克将Anthropic的Claude Cowork核心设计者Jenny Wen招入SpaceXAI,她已加入Cursor担任设计负责人,并将把产品与交互设计经验用于Grok Bot。
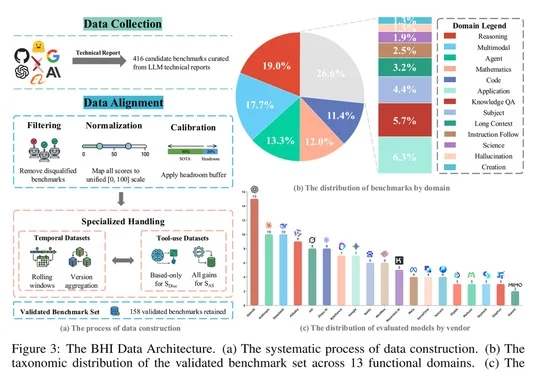
阿里数据团队基于117个模型技术报告筛选158个评测基准,提出基准健康指数(BHI),按能力区分度、抗饱和度和影响力诊断基准,论文获NeurIPS 2026 Evaluations and Datasets Track(Oral)录用,Humanity's Last Exam(HLE)综合第一。
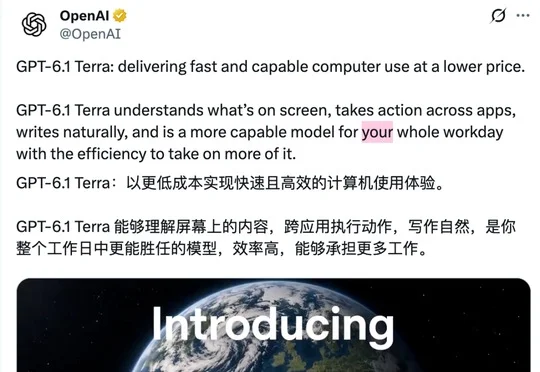
OpenAI发布GPT-6.1 Terra,每百万token输入1美元、输出5美元,较上代大幅降价,并强化视觉理解、写作和电脑操作;Agents’ Last Exam中追平GPT-6 Astra且速度快3倍以上,第三方评测幻觉率由88%降至38%,现已全面开放。
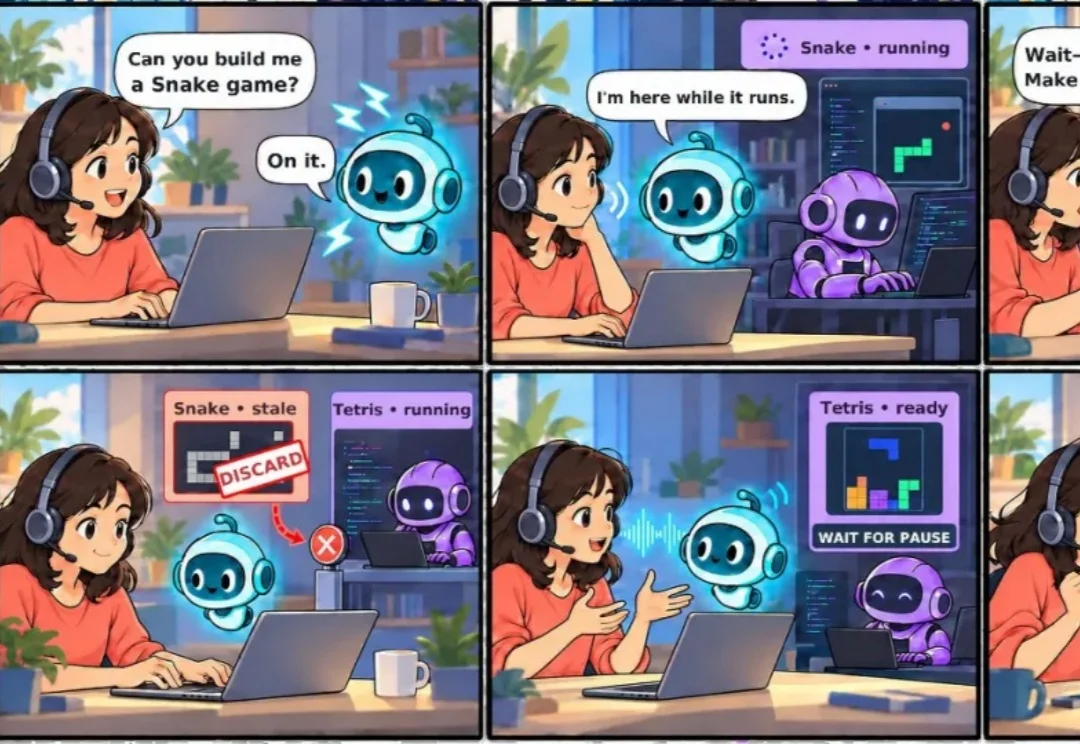
语音是人类最自然、最习惯的交互方式。随着代码智能体、办公智能体逐渐普及,人们对智能体的期待也不再只是 “问一个问题、得到一个答案”,而是希望像和同事一样持续沟通,共同完成一项工作:任务进行到一半,可以随时询问进展;想到新要求,可以直接补充;方向变了,也可以马上取消或修改。
近期,六角未来沿着 Physical Coding 的思路,进一步构建了 HexaShell-Preview。根据官方评测结果,在 RoboDojo 全部 42 项任务上,HexaShell-Preview 取得了 46.9% 的成功率、53.2 的进度得分,成功率高出第二名 7.5 个百分点,领跑 RoboDojo-Agent 榜单。
Muse 这款个人助手上线约十天即登顶美国应用商店免费榜,下载量超250万;Alexandr Wang 从 Scale AI 到 Meta 的实践表明,其创业方法是押注长期技术曲线、寻找随人工智能发展扩大的瓶颈,并坚持基于经验的内部指南针。
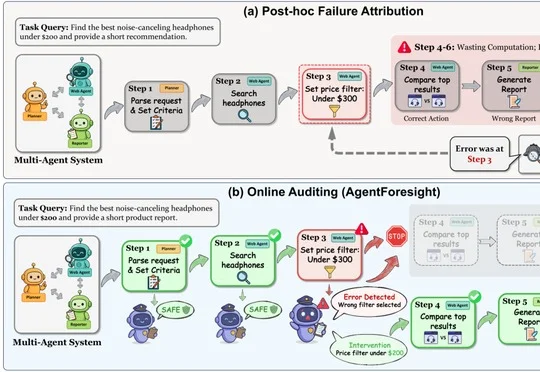
研究团队提出7B审计员AgentForesight,可在多智能体任务运行中在线识别并归因关键错误,其AFTraj-2K Exact-F1达66.44,成功轨迹误报率仅2.37%。
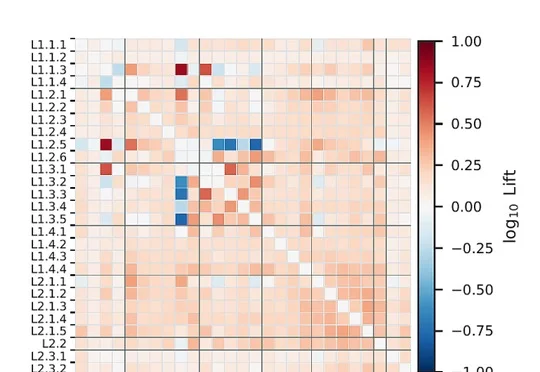
香港科技大学提出LexAgentHallu法律智能体幻觉评测基准,沿执行轨迹定位错误步骤,发现即使最终答案正确,仍有68%的轨迹存在法律内容幻觉,表现最好的配置也有89%的轨迹出现幻觉。
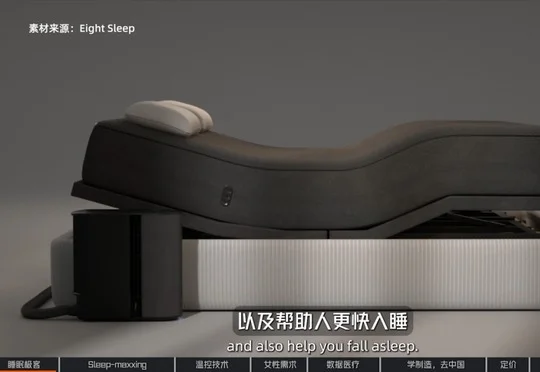
Eight Sleep联合创始人Matteo Franceschetti与Alexandra Zatarain在对话中介绍其AI智能床套Pod的动态液冷温控、健康异常预警和FDA申请进展,并分享进入中国市场后成为增长最快市场及产品定价策略方面的思考。
就在刚刚,马斯克SpaceXAI正式发布,全新主力模型Grok 4.7!