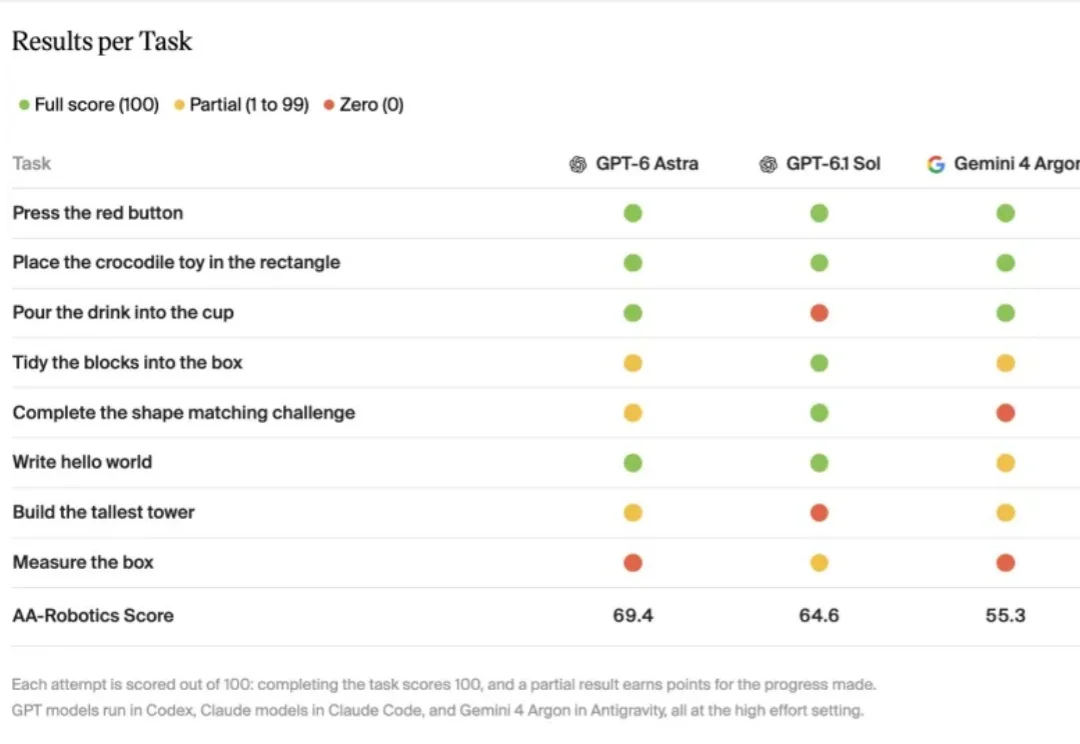
通用大模型要「降维打击」具身智能?首个AA-Robotics榜单来了
通用大模型要「降维打击」具身智能?首个AA-Robotics榜单来了具身智能公司辛苦训练的「机器人大脑」,要被 GPT、Claude、Gemini 抢饭碗了?
来自主题: AI技术研报
9679 点击 2026-10-15 13:57

 搜索
具身智能公司辛苦训练的「机器人大脑」,要被 GPT、Claude、Gemini 抢饭碗了?
GPT-6.1 Sol,默认上下文直接冲到500k!
AI现在真是开启数学证明扫荡模式了。
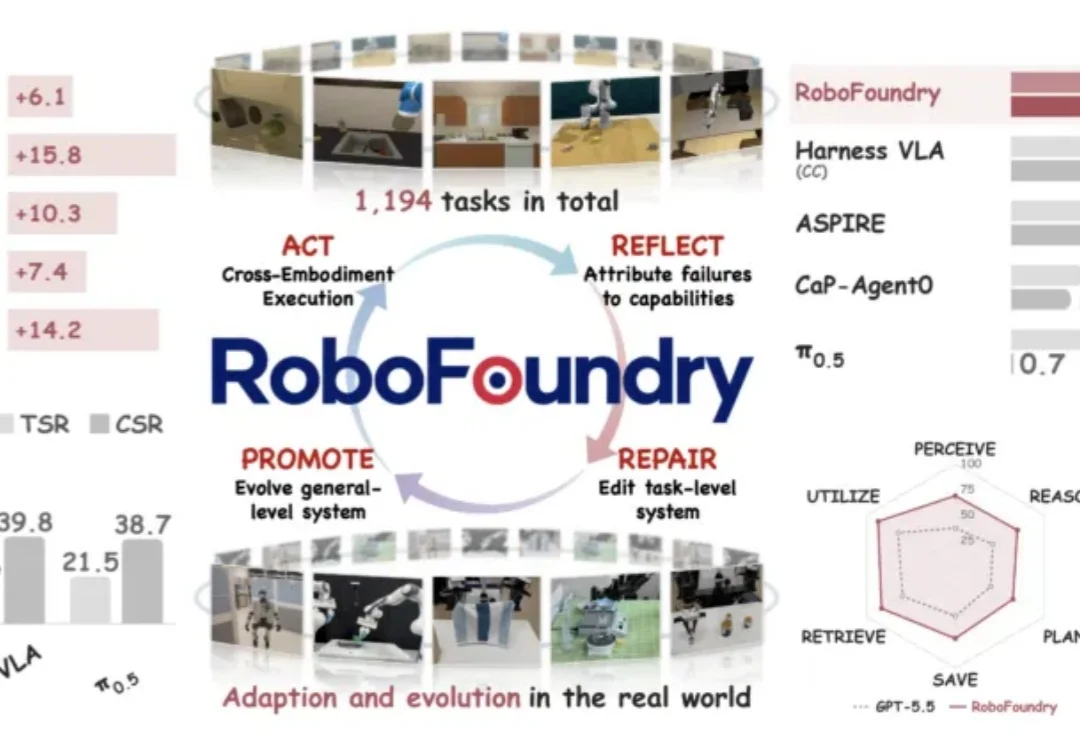
同一个 GPT-5.5,放进不同的系统里,做具身任务的表现可以相差悬殊。在 EmbodiedBench 上,直接使用 GPT-5.5 的平均成功率是 56.9%;模型参数一个不改,只让它周围的系统持续进化,这个数字变成了 72.7%。
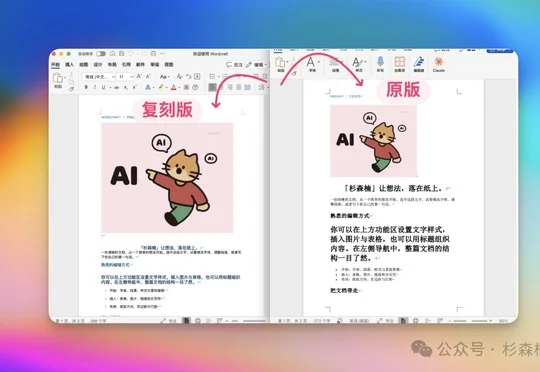
作者借助 GitHub 项目 REA 和 Codex GPT-6 Astra,在没有源代码的情况下迭代复刻 Microsoft Word,核心功能与界面高度还原,显示 AI 正显著降低成熟软件复刻门槛。
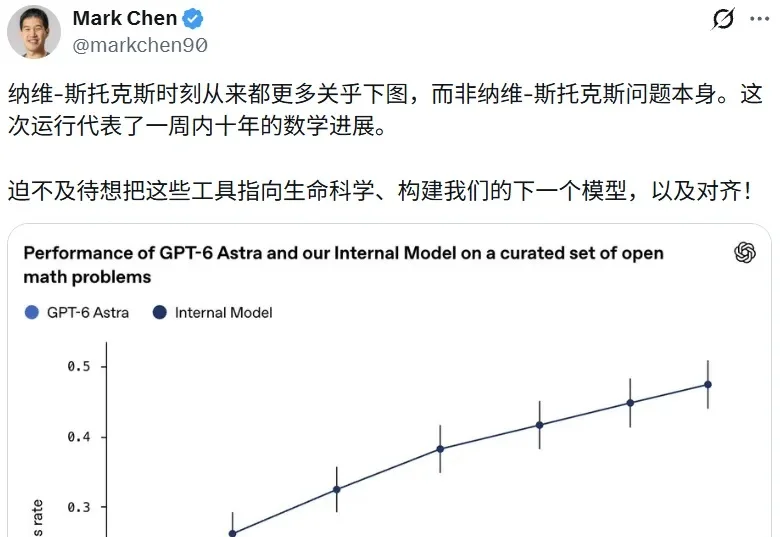
前些时日,OpenAI 在 GitHub 上一口气放出了 722 篇数学论文手稿。这些手稿被归为 372 个结果「家族」,横跨 17 个数学领域,全部出自一个尚未发布、也没有公开名字的内部模型——其性能远胜 GPT-6 Astra。
每一天都在。14个月,8个月,我们还在这里。
ChatGPT共同创造者Liam Fedus表示,数学可由Lean验证,但材料等物质科学必须依靠真实实验,因此其创立的Periodic Labs在门洛帕克建设实验室,结合语言模型推理、物理模拟与高通量实验探索AI科学家。
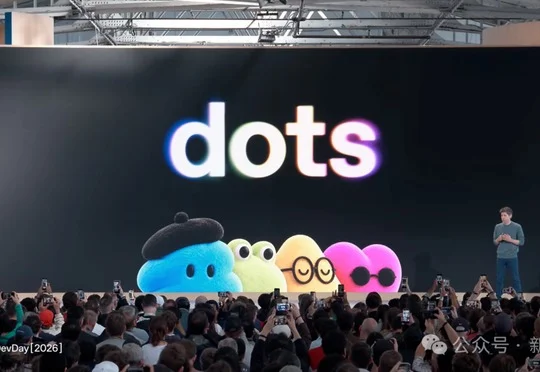
OpenAI更新dots,用户可在iOS或Android版ChatGPT创建并配置dot,指挥Codex推进编程任务;Codex还推出Beta功能Composer Predictions,可按Tab采纳下一条消息建议。
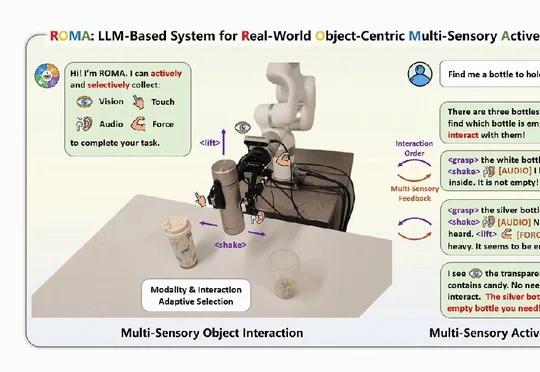
人大高瓴 GeWu-Lab、智源研究院与燧行 AresoX 等机构提出 ROMA,构建 ROMI-2K、ROMA Bench 及 ROMA-7B,使机器人融合视听触力主动探索物体,并在 ROMA Bench 上以 72.9% 总体任务成功率基本追平 GPT-6 Astra。