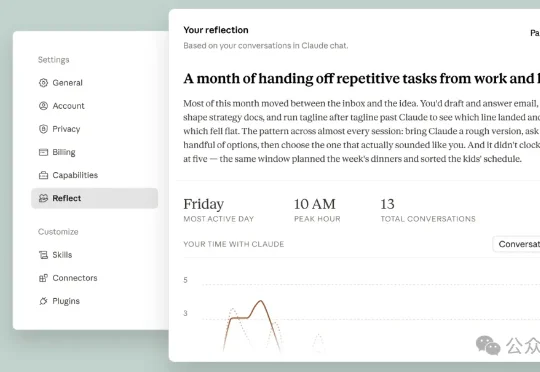
Claude出了个「防沉迷」,却可能让你更离不开它
Claude出了个「防沉迷」,却可能让你更离不开它这回,Anthropic要劝你,别太沉迷Claude了。它上线了Reflect功能的Beta测试版,面向Free、Pro、Max用户开放。这个藏在设置里的面板,想帮你搞清楚一件事:什么时候该用Claude,什么时候该关掉它。
来自主题: AI资讯
9590 点击 2026-07-11 19:34

 搜索
这回,Anthropic要劝你,别太沉迷Claude了。它上线了Reflect功能的Beta测试版,面向Free、Pro、Max用户开放。这个藏在设置里的面板,想帮你搞清楚一件事:什么时候该用Claude,什么时候该关掉它。
今天上午,上海AI大模型企业MiniMax发布公告,拟通过配售新股及发行可转换债券募集资金约160亿港元(约合人民币138.34亿元)。与此同时,MiniMax创始人兼CEO闫俊杰发布内部信称,在实现AGI之前将不再从该公司领取薪酬,并将个人持有相当于MiniMax总股本5%的股份用于员工激励以及支持开源社区发展。
葬AI身边的朋友常常有个疑问:为什么MiniMax M3做的不够好(问了很多在做模型测评的朋友,也是类似看法),但市场仍然觉得他们是第一梯队?我朋友@朱亦辉的解释是,MiniMax M3的核心科技是叙事能力,让外界觉得他们和Kimi是一个级别,达到一个强行双骄的效果。
今年四月,吴明泽因为"装龙虾"认识了一位货代公司老板。说来也巧。那位朋友在物流行业干了整整十年,四月正好是龙虾进口旺季,就顺手给吴明泽介绍了这位年营收过亿的老板。吴明泽是谁?哈佛设计工程硕士、斯坦福HAI(人工智能实验室)科研助理。他还在阿里、腾讯、MiniMax做过工程师
据 The Information 报道,MiniMax 正在研发一款参数规模达 2.7 万亿的大语言模型,内部代号暂定为 M3 Pro,最快有望于今年第三季度发布,并计划同步开源。相较于现有旗舰模型 M3 的 4280 亿参数,M3 Pro 的规模实现了数量级跃升,预计将在复杂推理、多步骤任务处理及长上下文理解等能力上进一步增强。
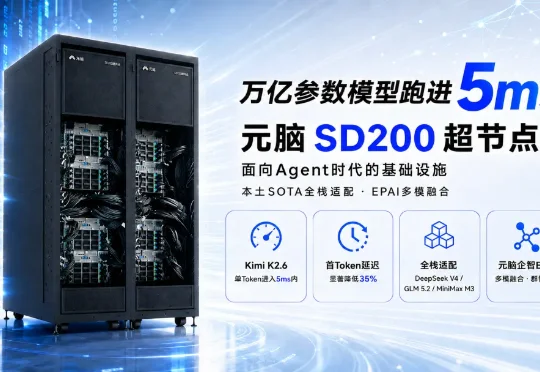
浪潮信息宣布,元脑SD200超节点AI服务器率先完成主流领先开源大模型Kimi K2.6、DeepSeek V4、GLM 5.2、MiniMax M3等的高性能优化,并在Kimi K2.6万亿参数大模型上实现Token生成时间快达4.77ms,为Agent场景应用的高效运行提供强大算力支撑。
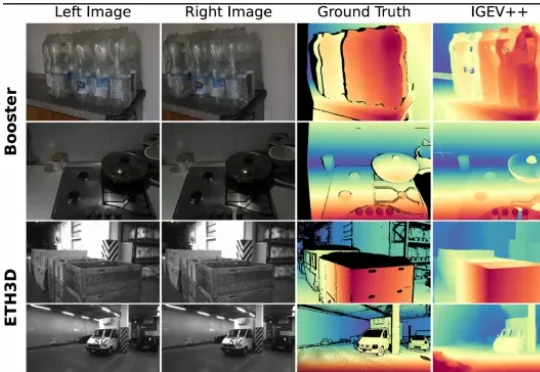
LinStereo 对应地做了三件事:PALA 换掉 ConvGRU 解决传播问题,HSCV 保留多尺度特征,DPI 用单目深度给一个靠谱的起点。PALA 做的事情说起来很直观,就是把 ConvGRU 的局部更新换成全局注意力,让每个像素每次迭代都能看到整张图。难点在于 softmax attention 是 O (N²) 的,直接用在高分辨率视差图上跑不动。
最近这段时间,国内外模型更新得很快。
Kimi、智谱和 MiniMax 幕后的 “财务管家”Airwallex 空中云汇,正尝试回答 “AI 时代钱如何在全球丝滑流动” 这一难题。近期,Airwallex 完成 3.2 亿美元 H 轮融资,成为估值 110 亿美元超级独角兽。本轮融资由 Addition 领投,Baillie Gifford、 Amex Ventures 等几家欧美资本跟投
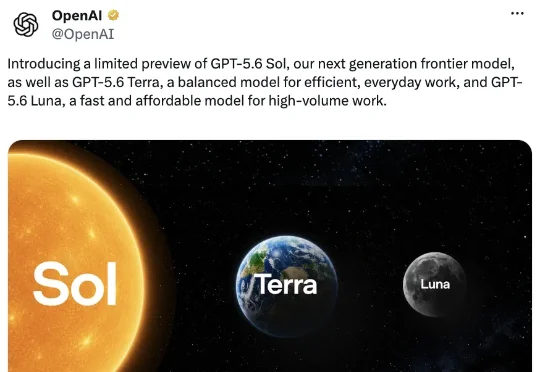
就在刚刚,OpenAI一口气端出三款GPT 5.6系列模型。主打一个全家桶「多款齐发」——旗舰模型Sol(太阳)、平衡模型Terra(大地)、低成本高速款Luna(月亮)。GPT-5.6 Sol:最夯模型,编程测试左踢自家模型GPT5.5,右打隔壁Fable 5,还新增max/ultra两个模式。