我MiniMax,用实习生处理数据,照样屠榜开源大模型
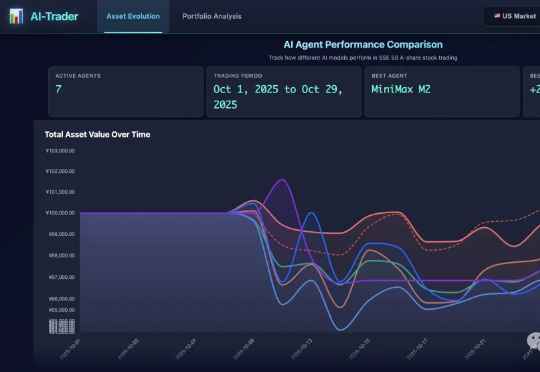
我MiniMax,用实习生处理数据,照样屠榜开源大模型屠榜开源大模型的MiniMax M2是怎样炼成的?为啥M1用了Linear Attention,到了M2又换成更传统的Full Attention了? 面对现实任务,M2表现得非常扛打,在香港大学的AI-Trader模拟A股大赛中拿下了第一名,20天用10万本金赚了将近三千元。
来自主题: AI资讯
9821 点击 2025-11-04 20:23

 搜索
屠榜开源大模型的MiniMax M2是怎样炼成的?为啥M1用了Linear Attention,到了M2又换成更传统的Full Attention了? 面对现实任务,M2表现得非常扛打,在香港大学的AI-Trader模拟A股大赛中拿下了第一名,20天用10万本金赚了将近三千元。
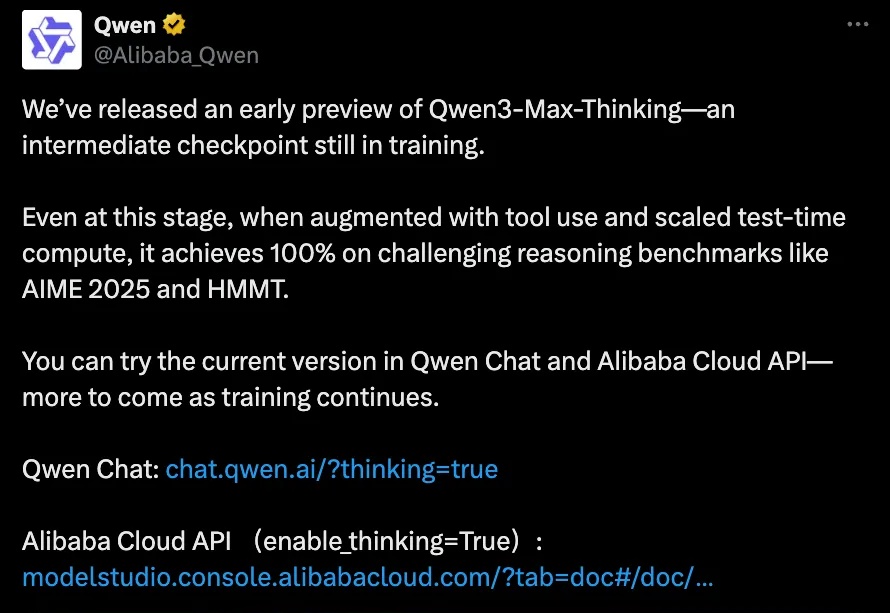
半成品模型,已经刷下高难度数学推理测试AIME 25满分战绩。
Qwen 团队终于在周日的晚上, 兑现了本周会更新Qwen3-Max thinking 的承诺。 而这个更新, 基本也是上周所有更新中为数不多非常期待的了。 毕竟Qwen3-Max也是Qwen整个家族里最大、最强的模型,
Voice Agent 赛道正在爆发,但它迫切需要一个能让对话真正「流动起来」的底层引擎,一个能撑起下一代交互体验的 TTS 模型。竞争的焦点,已经从 LLM 的「大脑」,延伸到了 TTS 的「嗓音」。谁掌握嗓音,谁就掌握着下一代 AI 商业化的钥匙。而 10 月 30 日 MiniMax 发布的 Speech 2.6 模型,似乎正是一个专为解决这些痛点而来的答案。
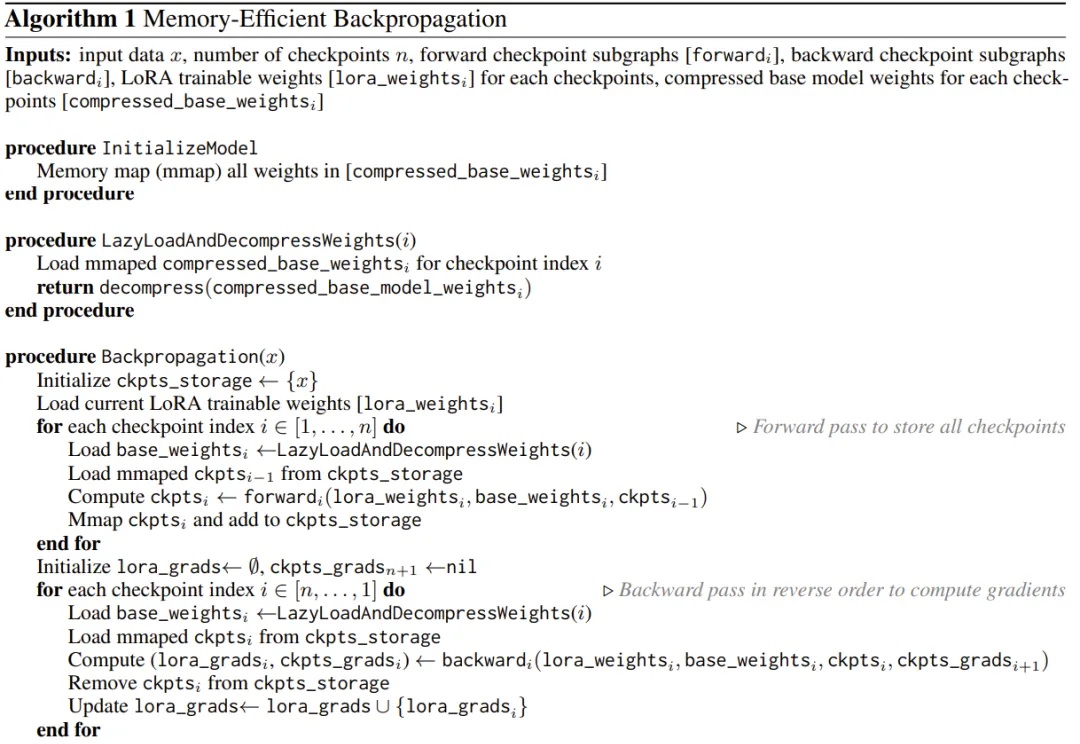
用 iPhone 本地跑大模型已经不是新鲜事了,但能不能在 iPhone 上微调模型呢?
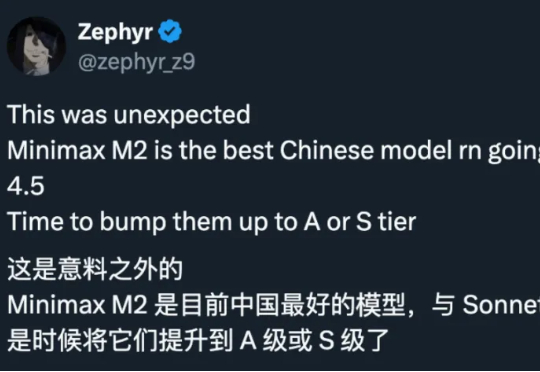
周日晚上,都准备去睡觉了。结果在 X 上刷到一条消息,有个国外的博主说,MiniMax 的 M2 模型将会成为中国最好的模型,与 Sonnet 4.5 旗鼓相当。 我当时心里咯噔一下。MiniMax?
月之暗面融资传闻升级,估值或逼近MiniMax。Kimi产品因MAU下滑、DeepSeek冲击失速,战略转向Coding和Agent方向,推出分层会员订阅商业化。杨植麟在开源上妥协,但坚持基座模型和toC路线,面临分发弱势和高昂成本,未来半年需明确定位应对激烈竞争。
10 月 27 日,国产「好模型」阵营又迎来一位新成员,MiniMax 发布了全新大版本模型 M2,延续了 M1 时代的开源策略。它不仅在 Coding 与 Agent 能力等方面继承了 M1 的优势,更在成本效率、智能水平、响应延迟这 3项关键指标上,同时迈出了一大步。
10 月 23 日,一向不爱出风头的夸克上线了对话助手,可以让用户在一个 App 内即可完成信息查找、问题解答与任务处理,实现了 AI 搜索与对话的深度融合。其中一大亮点就是,该对话助手采用了 Qwen 最新闭源模型。至于是哪个型号、性能有多强,夸克卖了个关子,只透露比 Qwen3-Max 更进一步,在业界有绝对领先性。
全球六大LLM实盘厮杀,新王登基!今天,Qwen3 Max凭借一波「快狠准」操作,逆袭DeepSeek夺下第一。Qwen3 Max,一骑绝尘! 而GPT-5则接替Gemini 2.5 Pro,成为「最会赔钱」的AI。照目前这个趋势,估计很快就要跌没了……