写入记忆,何必读完整个网络?英伟达SEED每GPU吞吐最高提升42%
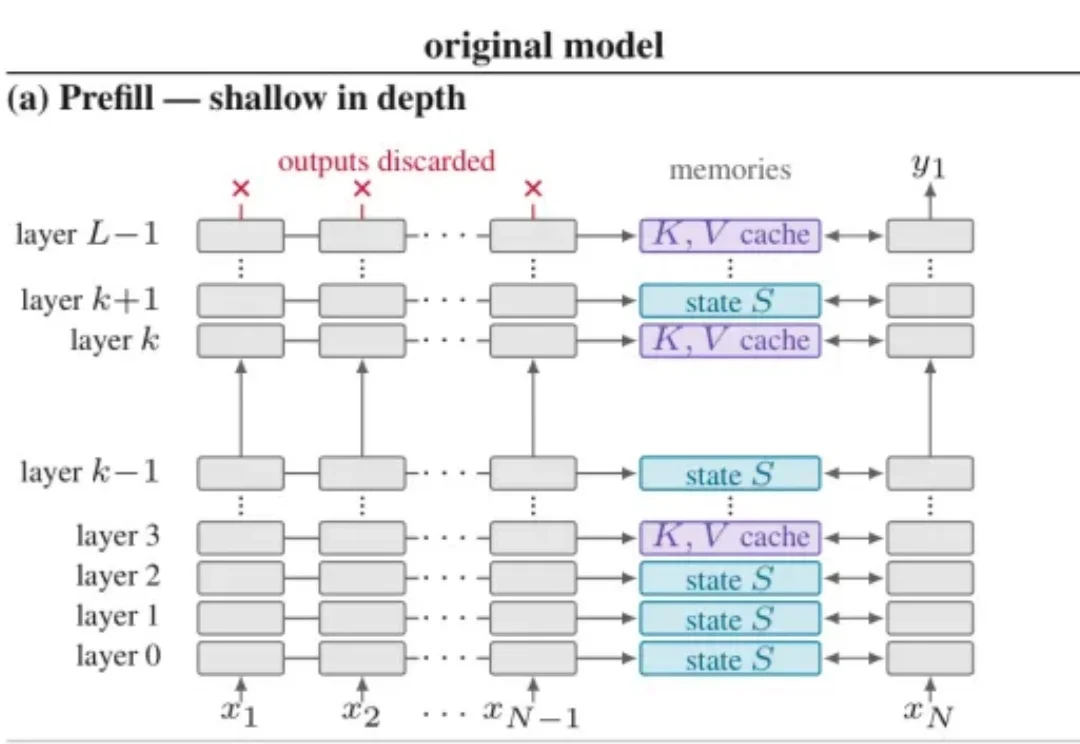
写入记忆,何必读完整个网络?英伟达SEED每GPU吞吐最高提升42%Qwen3.8-Flash-Next 有 48 层。处理一段输入时,SEED 让除最后一个以外的 token 只运行前 31 层,再由轻量的记忆写入组件,为后续 17 层生成 KV Cache 和循环状态。到了生成阶段,每个 token 仍然运行完整的 48 层。
来自主题: AI技术研报
5748 点击 2026-11-19 14:50

 搜索
Qwen3.8-Flash-Next 有 48 层。处理一段输入时,SEED 让除最后一个以外的 token 只运行前 31 层,再由轻量的记忆写入组件,为后续 17 层生成 KV Cache 和循环状态。到了生成阶段,每个 token 仍然运行完整的 48 层。
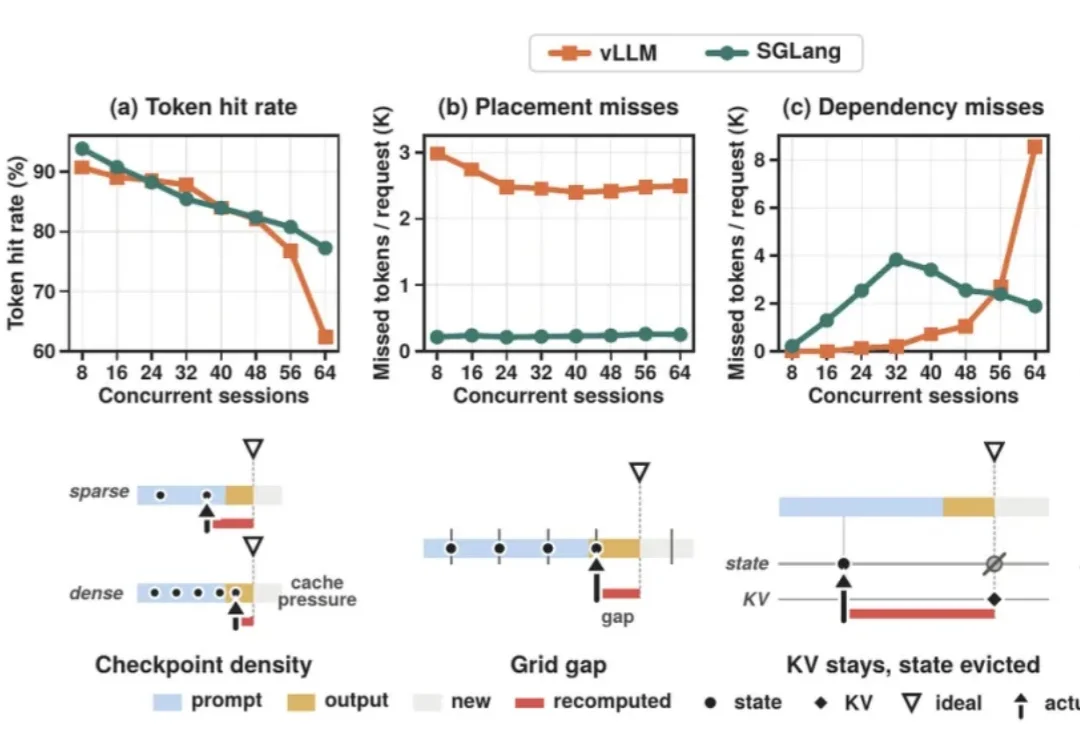
Kimi Delta Attention(KDA)、Gated DeltaNet(GDN)、Mamba-2 等线性注意力与状态空间层,正在成为开源大模型的常见组件。Kimi K3.1 Pro、GLM-5.3-Flash、Qwen3.8-Flash-Next、Nemotron 3 Super 都采用了「全注意力 + 线性层」的混合架构,以换取更快的解码和更小的 KV Cache。
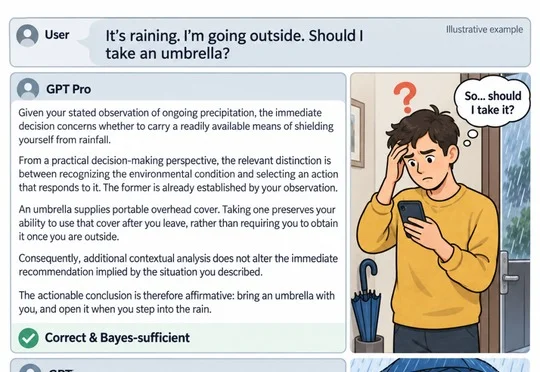
Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。
如今的大模型再聪明,输出内容也是一个字一个字往外蹦。有没有一种可能:真正的 AGI 不是这样?
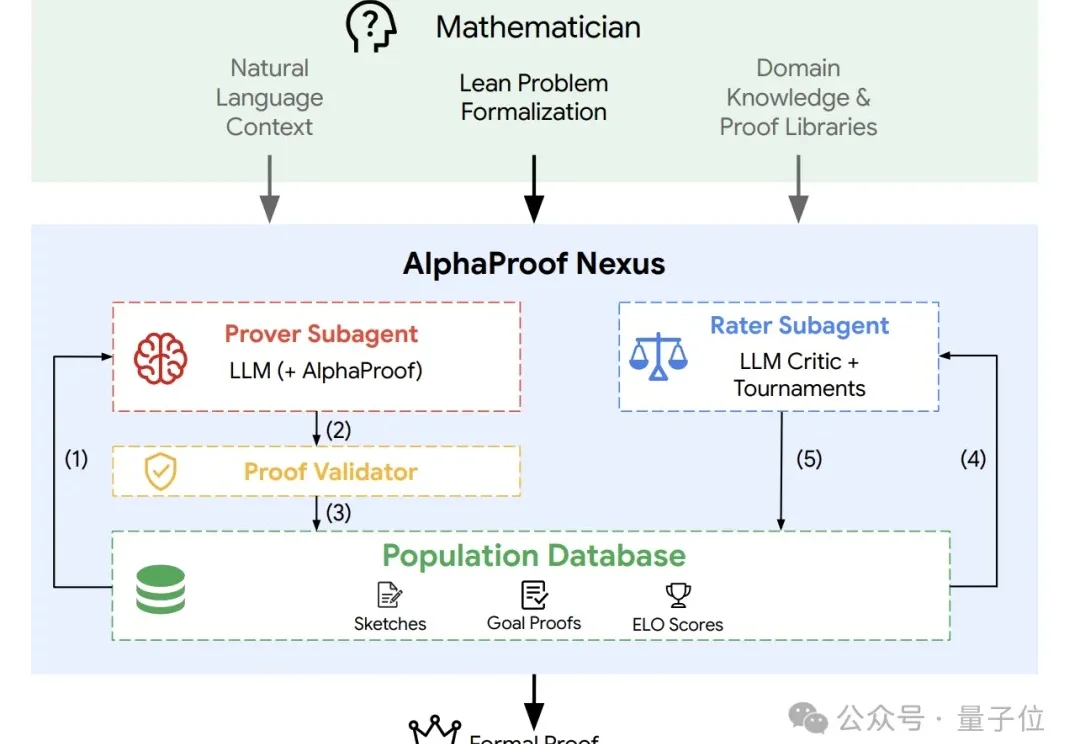
AI数学圈最近是真热闹。
Anthropic,怕是又憋了个大的!
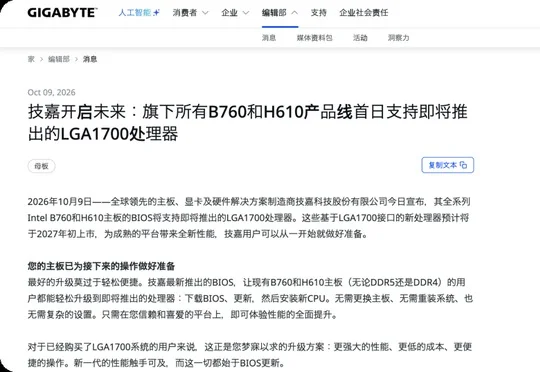
AI需求挤压消费级内存产能并推高PC成本,技嘉通过BIOS更新让B760、H610及DDR4平台继续支持英特尔LGA1700新处理器,开源项目Strata则让消费级电脑本地运行1250亿参数的Qwen3.8-Flash-Next成为可能。
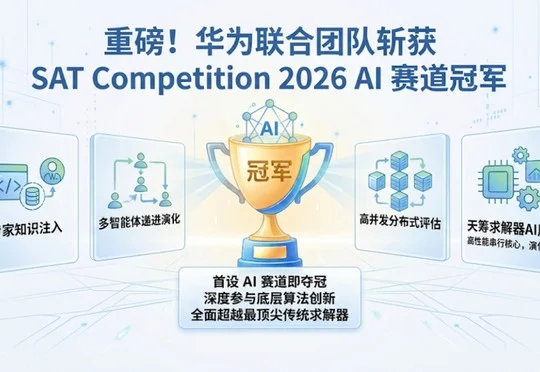
华为诺亚方舟实验室、华为云天筹AI求解器团队与华中科技大学John Hopcroft计算中心组成的联合团队,依托华为云天筹决策智能引擎和LLM4AD_Next算法设计平台,斩获SAT Competition 2026并行AI赛道SAT组冠军。
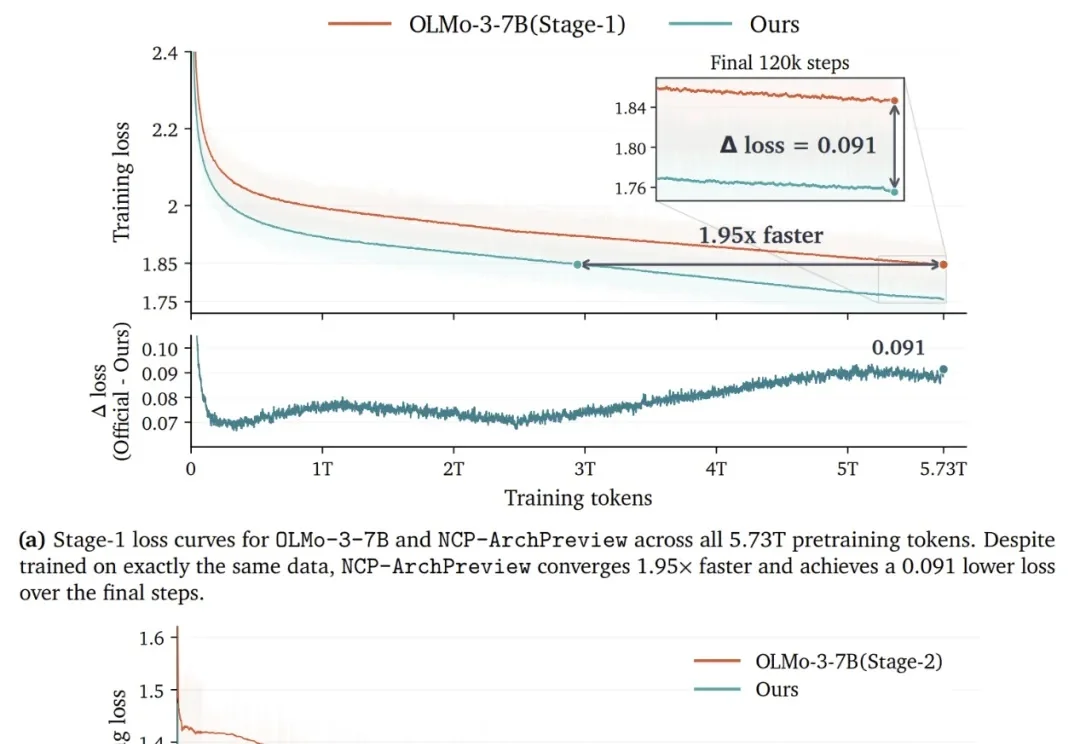
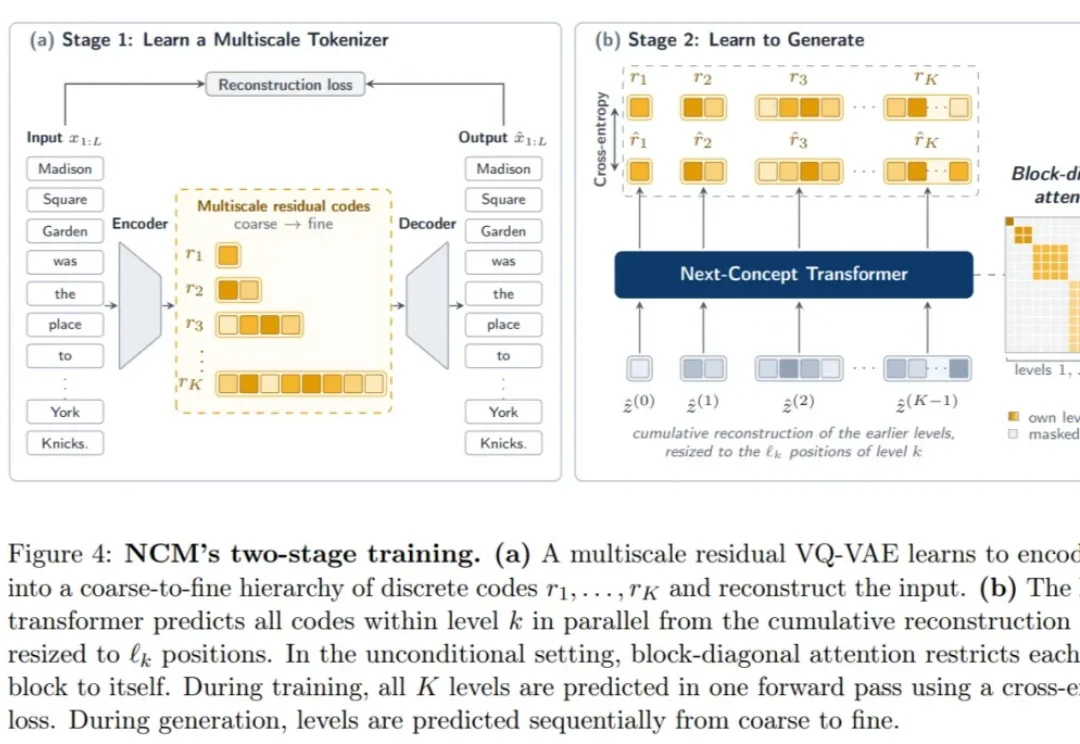
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
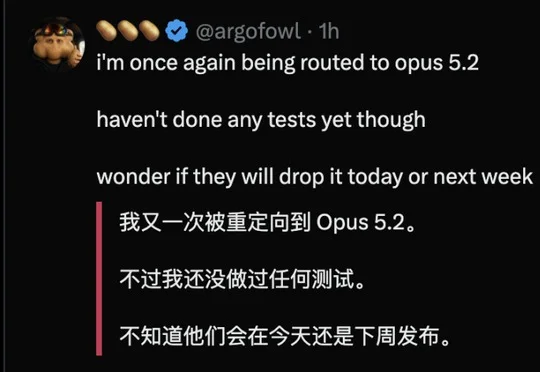
Anthropic连夜拔掉内部代号Opus-Next的灰度测试后又在一天内恢复,且灰度范围从Claude Code扩大至Claude Chat/Cowork/Code,预示Claude Opus 5.2可能即将发布。