写入记忆,何必读完整个网络?英伟达SEED每GPU吞吐最高提升42%
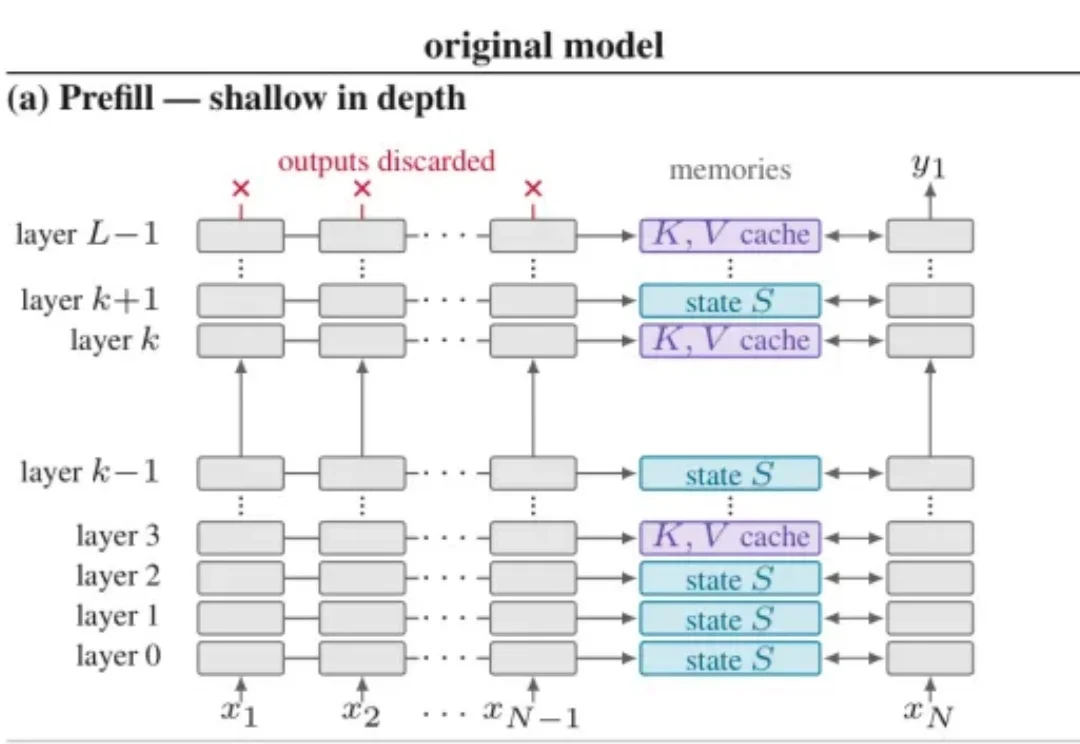
写入记忆,何必读完整个网络?英伟达SEED每GPU吞吐最高提升42%Qwen3.8-Flash-Next 有 48 层。处理一段输入时,SEED 让除最后一个以外的 token 只运行前 31 层,再由轻量的记忆写入组件,为后续 17 层生成 KV Cache 和循环状态。到了生成阶段,每个 token 仍然运行完整的 48 层。
来自主题: AI技术研报
5581 点击 2026-11-19 14:50

 搜索
Qwen3.8-Flash-Next 有 48 层。处理一段输入时,SEED 让除最后一个以外的 token 只运行前 31 层,再由轻量的记忆写入组件,为后续 17 层生成 KV Cache 和循环状态。到了生成阶段,每个 token 仍然运行完整的 48 层。
花了约 200 亿的 Opus 5.5 token,价值约五千美金,打造了一个 vibe coding 的(可能的)必备神器!
“科学家发现已有的世界,工程师创造尚不存在的世界。”——西奥多·冯·卡门
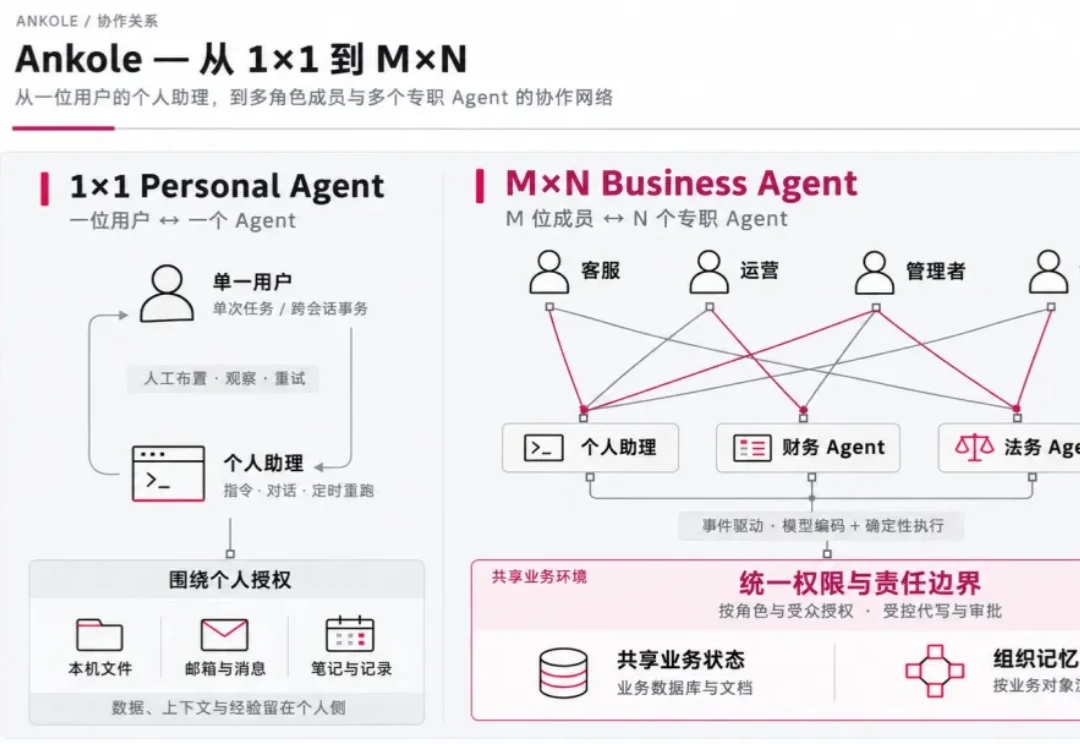
继 Coding Agent 之后,Muse、Grok Bot 等 Personal Agent 产品也快速成熟。不少团队尝试把它们引入组织:要么给每位成员部署一套,要么把同一个 Agent 接进部门群聊。但单人使用表现稳定的 Agent,一旦放到多人协同场景总是表现得非常不及预期。
最近,在Neo4j的NODES 2026中,联合创始人兼CEO Emil Eifrem作为主持人问吴恩达:过去一年Coding Agent变化这么大,AI工程师到底还需要学什么?
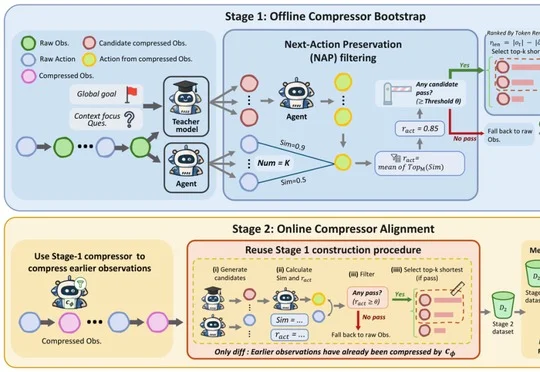
清华大学人工智能学院提出面向 Coding Agent 的 observation 压缩方法 CoACT,在 SWE-bench Verified 的三个 Agent 模型上平均减少 33.0% 总 token 消耗且 PASS@1 与未压缩时相近,该工作获 ICSE 2027 直接接收(Top 5%)。
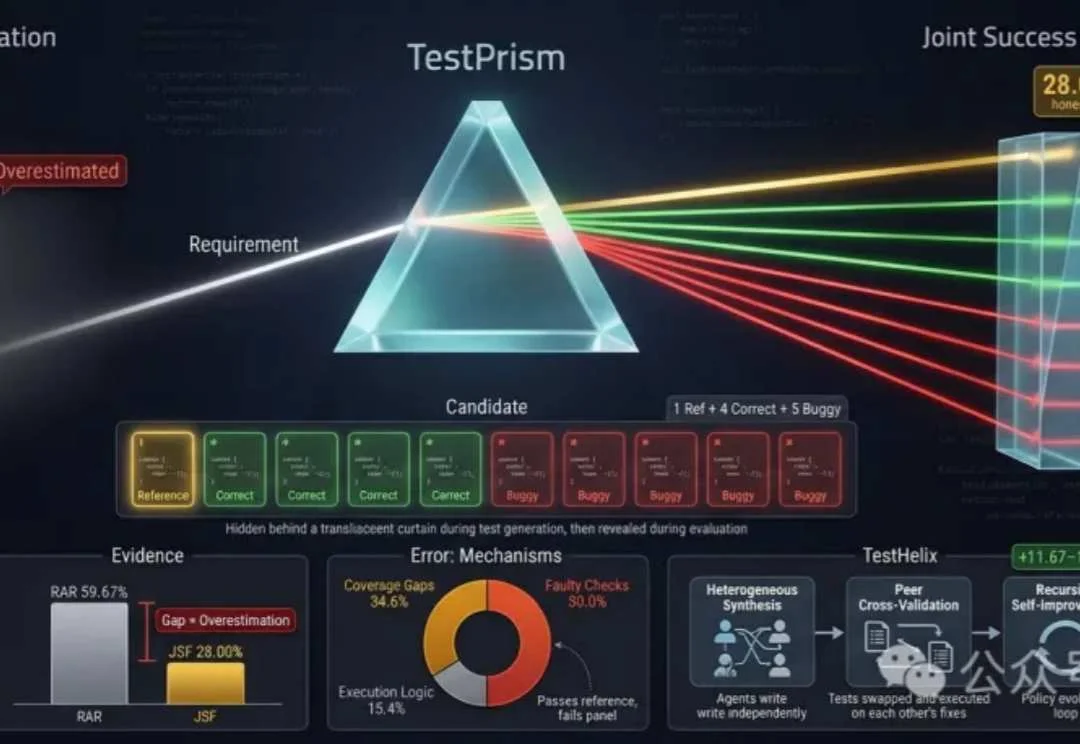
Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。
Ben:Agent碰到障碍,会继续尝试,直到把任务做完。它不会告诉你中途哪里失败过,最后只会说:已经完成了。
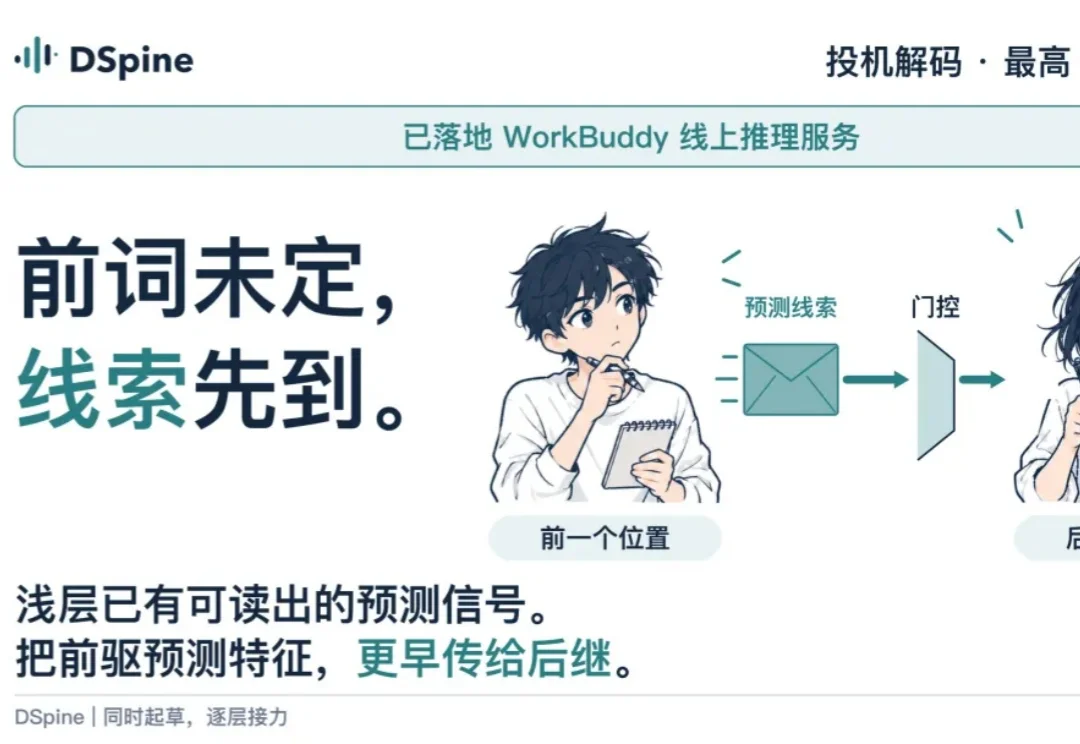
在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 token,大幅压缩了起草耗时。
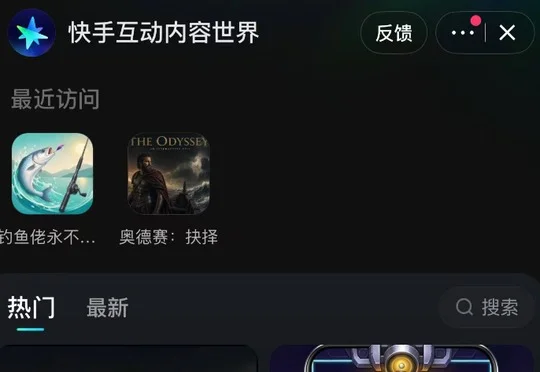
快手App正式上线“快手互动内容世界”独立平台和入口,主要承载通过Vibe Coding制作的互动叙事与模拟小游戏,主流内容平台已围绕轻互动赛道展开竞争。