AI资讯新闻榜单内容搜索-PoS

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: PoS
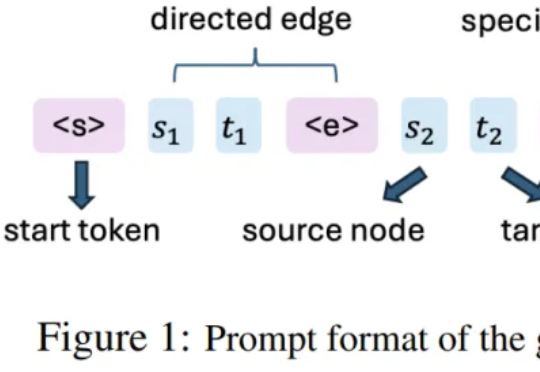
田渊栋与Russell团队联手,证明Transformer能在训练中自然学会叠加推理

田渊栋与Russell团队联手,证明Transformer能在训练中自然学会叠加推理

田渊栋与Russell团队联手,证明Transformer能在训练中自然学会叠加推理

该团队 2025 年的研究《Reasoning by superposition: A theoretical perspective on chain of continuous thought》已从理论上指出,连续思维链的一个关键优势在于它能使模型在叠加(superposition)状态下进行推理:当模型面对多个可能的推理路径而无法确定哪一个是正确时,它可以在连续空间中并行地保留所有可能的路

来自主题: AI技术研报
10805 点击    2025-10-08 11:41
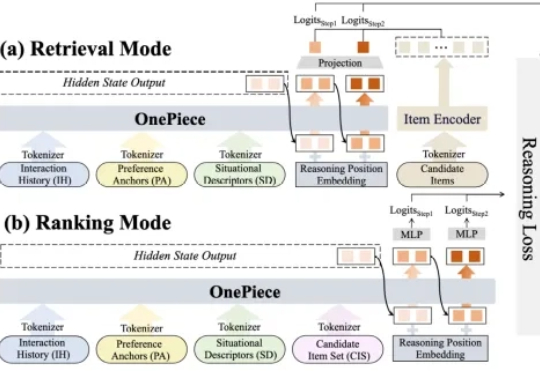
Shopee OnePiece:业内首个融合上下文工程、隐式推理和多目标训练策略的生成式搜推建模框架

Shopee OnePiece:业内首个融合上下文工程、隐式推理和多目标训练策略的生成式搜推建模框架

Shopee OnePiece:业内首个融合上下文工程、隐式推理和多目标训练策略的生成式搜推建模框架

2025 年,生成式推荐(Generative Recommender,GR)的发展如火如荼,其背后主要的驱动力源自大语言模型(LLM)那诱人的 scaling law 和通用建模能力(general-purpose modeling),将这种能力迁移至搜推广工业级系统大概是这两年每一个从业者孜孜不倦的追求。

来自主题: AI资讯
9054 点击    2025-09-28 18:14
来自MIT的最新研究-RL's Razor|展望LLMs Post-Training下的前沿探索与思考

来自MIT的最新研究-RL's Razor|展望LLMs Post-Training下的前沿探索与思考

来自MIT的最新研究-RL's Razor|展望LLMs Post-Training下的前沿探索与思考

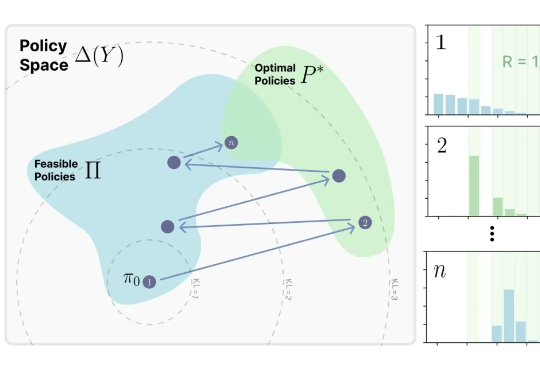
来自MIT Improbable AI Lab的研究者们最近发表了一篇题为《RL's Razor: Why Online Reinforcement Learning Forgets Less》的论文,系统性地回答了这个问题,他们不仅通过大量实验证实了这一现象,更进一步提出了一个简洁而深刻的解释,并将其命名为 “RL's Razor”(RL的剃刀)。

来自主题: AI技术研报
8685 点击    2025-09-18 14:26
OpenAI重组GPT-5「灵魂」团队!亚裔女负责人遭调离,罕见自曝AI幻觉祸首

OpenAI重组GPT-5「灵魂」团队!亚裔女负责人遭调离,罕见自曝AI幻觉祸首

OpenAI重组GPT-5「灵魂」团队!亚裔女负责人遭调离,罕见自曝AI幻觉祸首

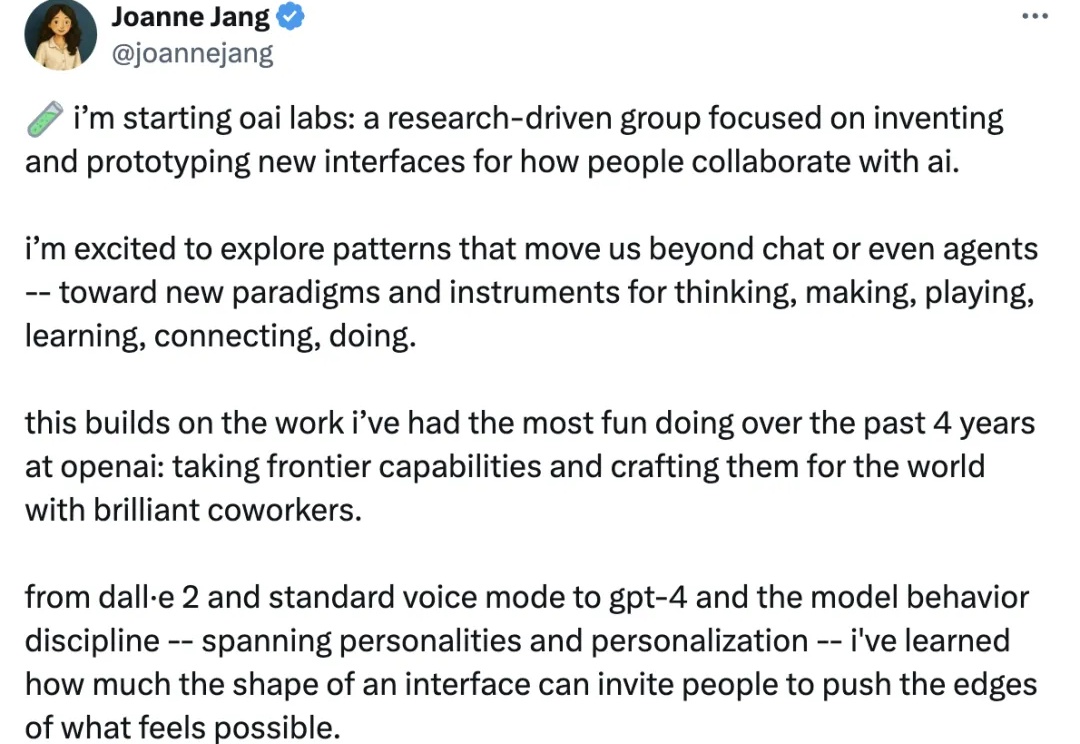
OpenAI重磅结构调整:ChatGPT「模型行为」团队并入Post-Training,前负责人Joanne Jang负责新成立的OAI Labs。而背后原因,可能是他们最近的新发现:评测在奖励模型「幻觉」,模型被逼成「应试选手」。一次组织重组+评测范式重构,也许正在改写AI的能力边界与产品形态。

来自主题: AI技术研报
10942 点击    2025-09-07 12:20
PosterGen:告别学术海报制作烦恼,从PDF一键生成「演示级」可编辑PPTX学术海报

PosterGen:告别学术海报制作烦恼,从PDF一键生成「演示级」可编辑PPTX学术海报

PosterGen:告别学术海报制作烦恼,从PDF一键生成「演示级」可编辑PPTX学术海报

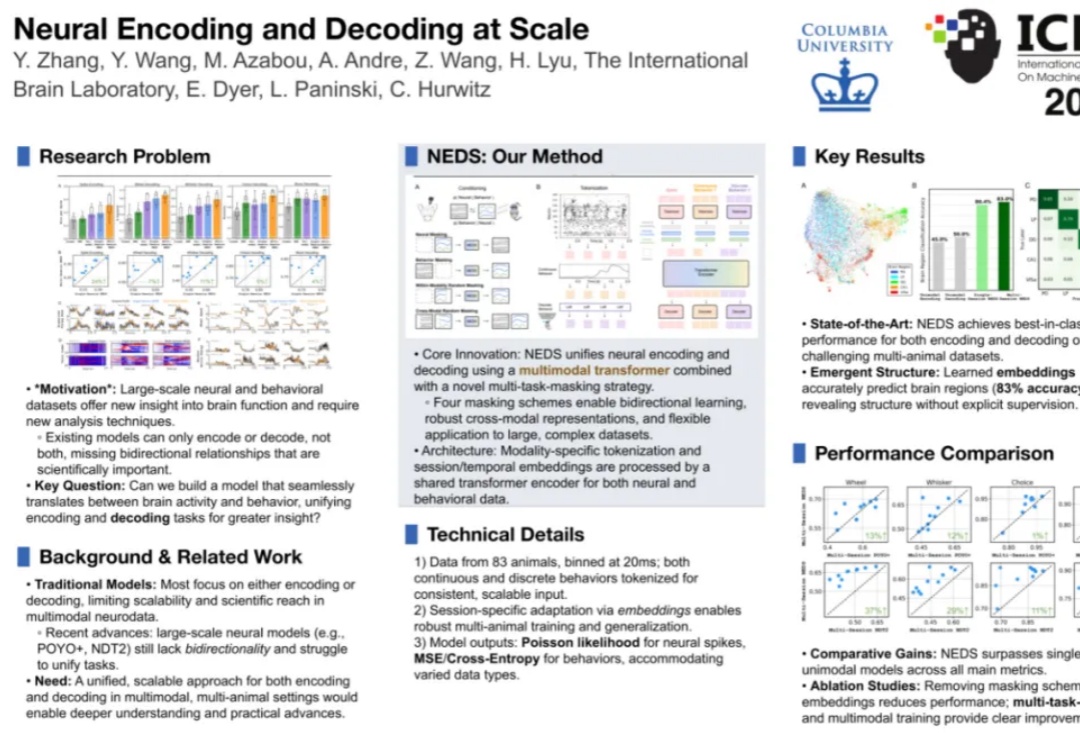
许多研究者在参加学术会议前,常常会因为制作海报所耗费的大量时间和精力而感到困扰。一张精心设计的海报是高效的学术交流媒介,但现有自动化方法普遍忽略了核心设计原则,导致生成的海报仍旧需要大量人工调整。

来自主题: AI技术研报
8200 点击    2025-09-05 10:05
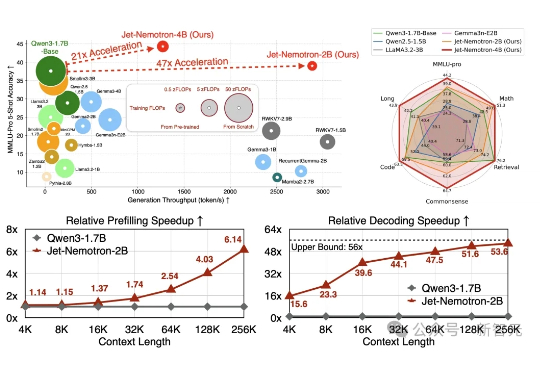
刚刚,英伟达新模型上线!4B推理狂飙53倍,全新注意力架构超越Mamba 2

刚刚,英伟达新模型上线!4B推理狂飙53倍,全新注意力架构超越Mamba 2

刚刚,英伟达新模型上线!4B推理狂飙53倍,全新注意力架构超越Mamba 2

Jet-Nemotron是英伟达最新推出的小模型系列(2B/4B),由全华人团队打造。其核心创新在于提出后神经架构搜索(PostNAS)与新型线性注意力模块JetBlock,实现了从预训练Transformer出发的高效架构优化。

来自主题: AI技术研报
9720 点击    2025-08-26 19:34
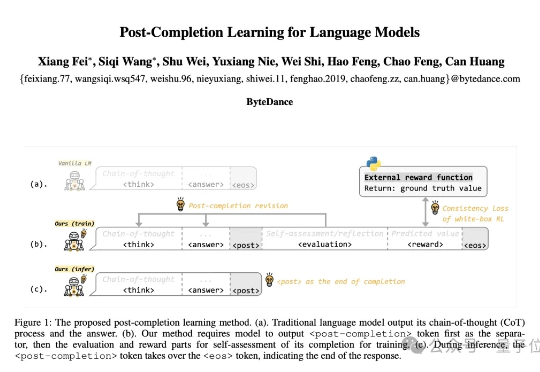
大模型训练新突破!“不对称”训练让AI学会自我反思,推理零开销

大模型训练新突破!“不对称”训练让AI学会自我反思,推理零开销

大模型训练新突破!“不对称”训练让AI学会自我反思,推理零开销

首次实现“训练-推理不对称”,字节团队提出全新的语言模型训练方法:Post-Completion Learning (PCL)。 在训练时让模型对自己的输出结果进行反思和评估,推理时却仅输出答案,将反思能力完全内化。

来自主题: AI资讯
8413 点击    2025-08-13 16:10
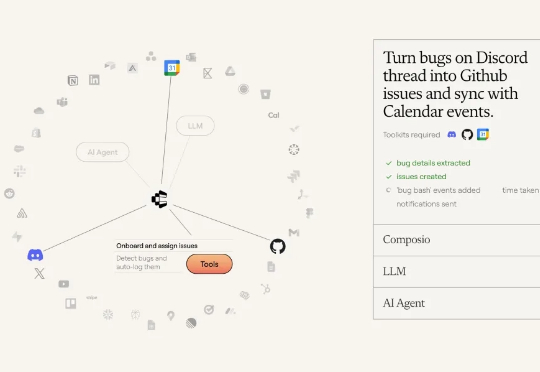
光速美国领投2500万美金,这家公司要让AI Agent具备学习和进化能力

光速美国领投2500万美金,这家公司要让AI Agent具备学习和进化能力

光速美国领投2500万美金,这家公司要让AI Agent具备学习和进化能力

你有没有想过,为什么那些看起来无所不能的 AI agent,在真实工作环境中却总是显得如此笨拙?我们花费数百小时调试提示词、完善指令,但这些智能系统依然无法像人类员工那样从经验中学习和成长。它们不会从错误中汲取教训,也不会在重复性任务中变得更加熟练。这个根本性问题,正是 Composio 刚刚完成 2500 万美元 A 轮融资要解决的核心挑战。

来自主题: AI资讯
7780 点击    2025-07-25 12:34
大模型竞赛转向:决胜关键为何是“后训练”?

大模型竞赛转向:决胜关键为何是“后训练”?

大模型竞赛转向:决胜关键为何是“后训练”?

随着基础大模型在通用能力上的边际效益逐渐递减、大模型技术红利向产业端渗透,AI的技术范式也开始从原来的注重“预训练”向注重“后训练”转移。后训练(Post-training),正从过去锦上添花的“调优”环节,演变为决定模型最终价值的“主战场”。

来自主题: AI技术研报
9653 点击    2025-07-20 12:30