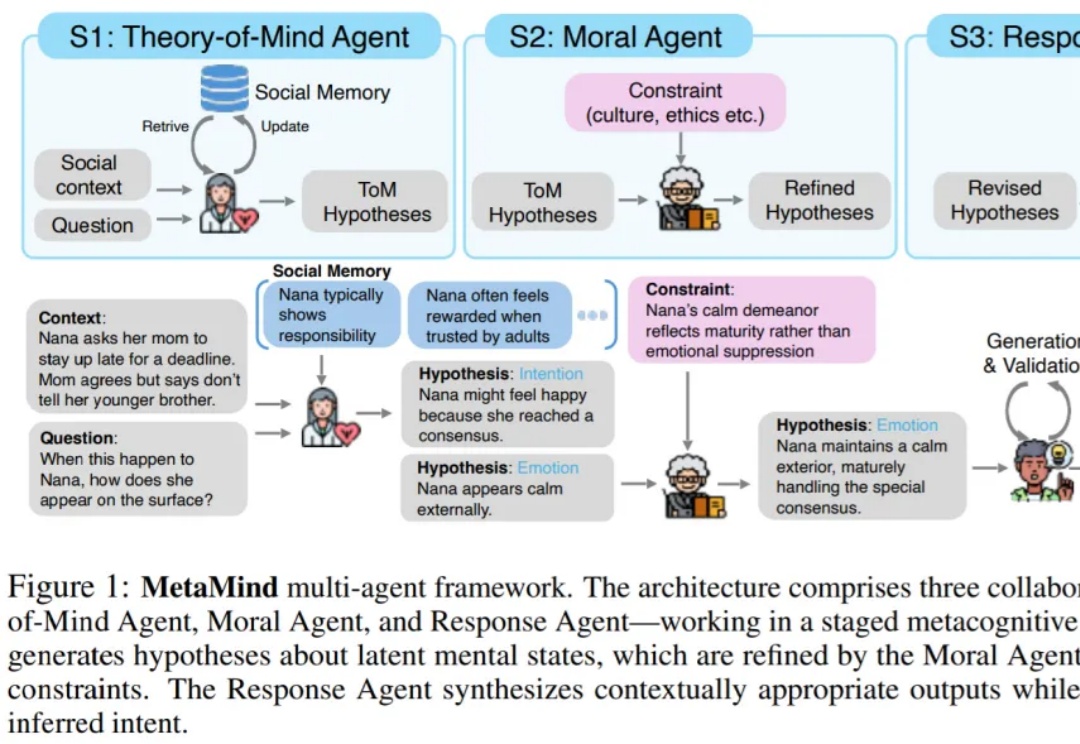
AI终于学会「读懂人心」,带飞DeepSeek R1,OpenAI o3等模型
AI终于学会「读懂人心」,带飞DeepSeek R1,OpenAI o3等模型“What is meant often goes far beyond what is said, and that is what makes conversation possible.” ——H. P. Grice
来自主题: AI技术研报
9940 点击 2025-11-21 09:16

 搜索
“What is meant often goes far beyond what is said, and that is what makes conversation possible.” ——H. P. Grice
继轻量级强化学习(RL)框架 slime 在社区中悄然流行并支持了包括 GLM-4.6 在内的大量 Post-training 流水线与 MoE 训练任务之后,LMSYS 团队正式推出 Miles——一个专为企业级大规模 MoE 训练及生产环境工作负载设计的强化学习框架。
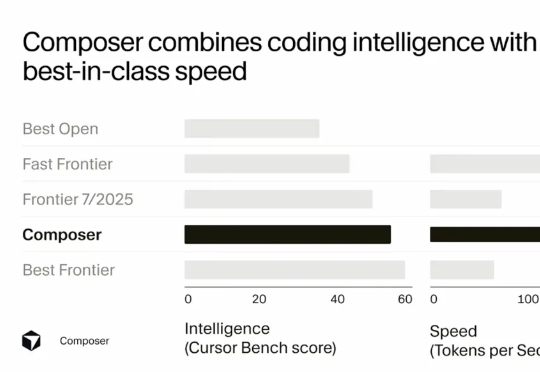
Sasha Rush 在分享开头就提到,Cursor Composer 在他们的内部 benchmark 上的表现几乎与最好的 Frontier 模型(前沿模型)持平,并且优于去年夏天发布的所有模型。它的表现明显好于最好的开源模型,以及那些被标榜为"快速"的模型。
LayerComposer革新了个性化图像生成,让用户像在Photoshop里一样自由操控元素位置、大小,解决传统方法交互性与多主体扩展难题,实现更自然、高效的创作,推动个性化生成迈向主动交互新阶段。
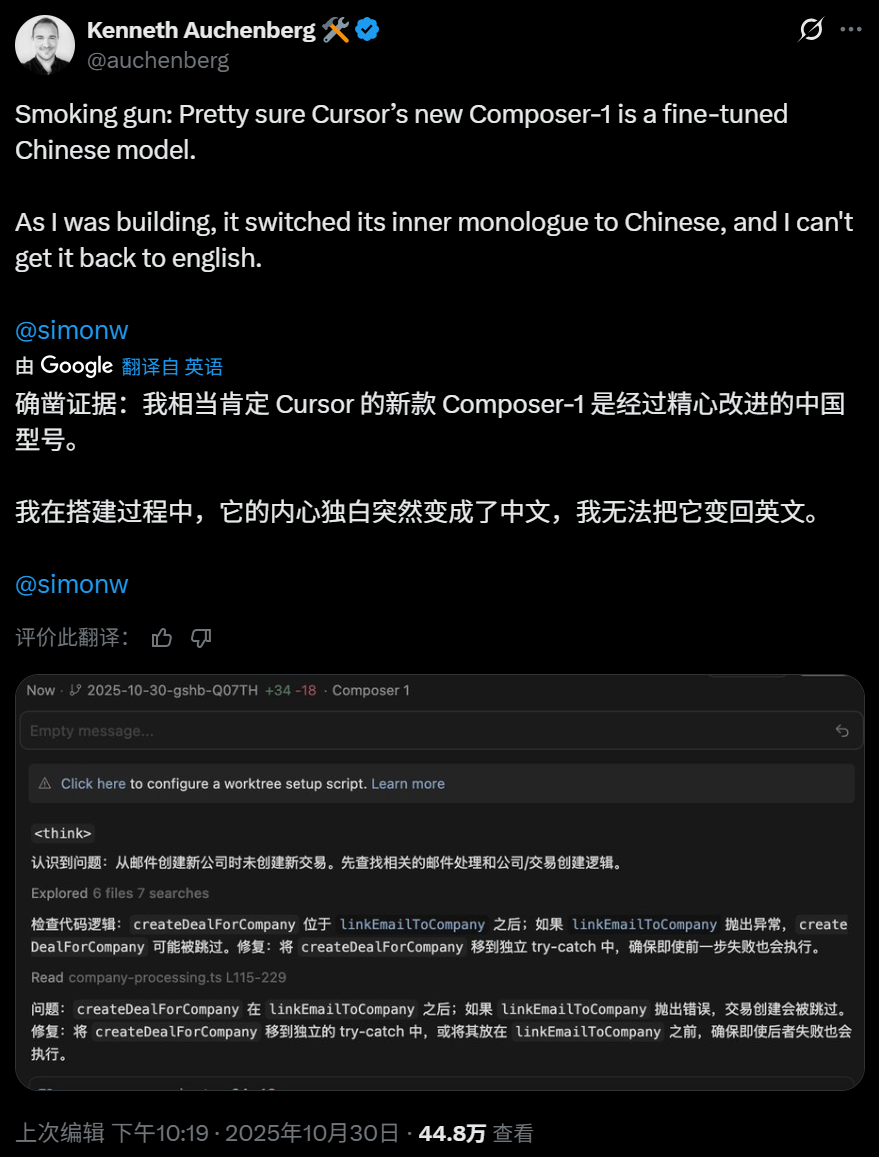
绷不住了,美国科技公司最新发布的大模型,思考时怎么一直在说中文?据官方博客介绍,在研发过程中,他们试验了一个代号为 Cheetah 的原型智能体模型,以更好地理解更高速智能体模型的影响。Composer 是该模型的更智能升级版,凭借足够的速度支撑交互式体验,让编码始终丝滑。
这次不仅发布自研编码模型Composer,还重构了IDE交互逻辑,可以最多8个智能体同时跑,早期测试和开发者都说Cursor 2.0真的太快了。Composer的速度是同等模型的4倍。Cursor说这是一款专门为低延迟智能编码打造的模型,大部分任务都可以在30秒以内完成。
最新进展,Cursor 2.0正式发布,并且首次搭载了「内部」大模型。 没错,不是GPT、不是Claude,如今模型栏多了个新名字——Composer。实力相当炸裂:据官方说法,Composer仅需30秒就能完成复杂任务,比同行快400%
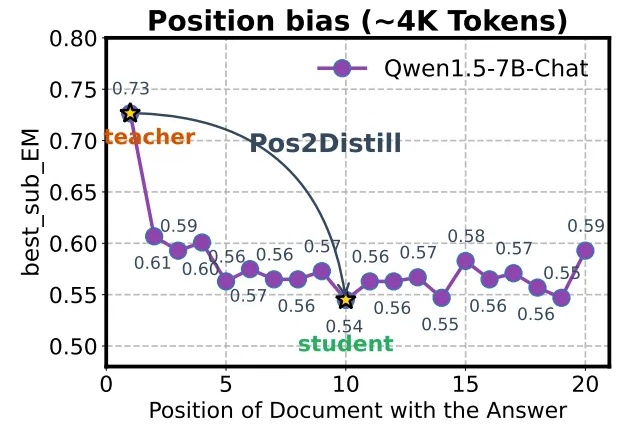
语言模型遭遇严重的位置偏见,即模型对不同上下⽂位置的敏感度不⼀致。模型倾向于过度关注输⼊序列中的特定位置,严重制约了它们在复杂推理、⻓⽂本理解以及模型评估等关键任务上的表现。
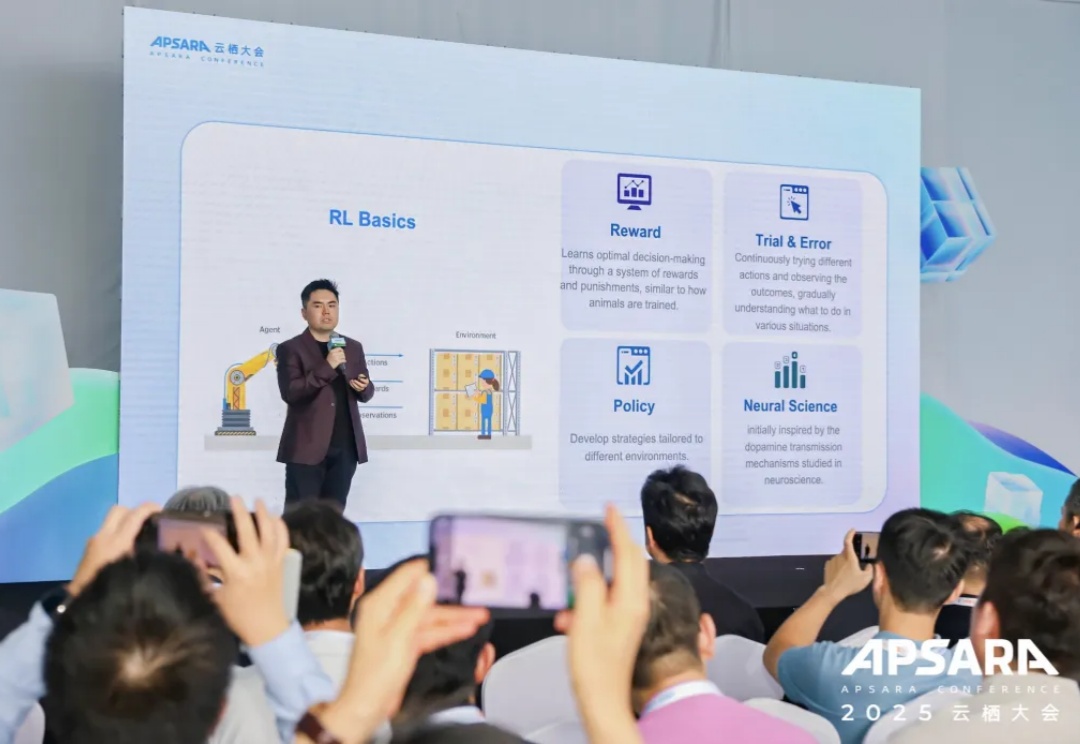
当全球的目光还在聚焦基座模型的参数竞赛时,一场更为深刻的变革正在悄然发生——后训练(Post-Training)。
既然后训练这么重要,那么作为初学者,应该掌握哪些知识?大家不妨看看这篇博客《Post-training 101》,可以很好的入门 LLM 后训练相关知识。从对下一个 token 预测过渡到指令跟随; 监督微调(SFT) 基本原理,包括数据集构建与损失函数设计;