统一transformer与diffusion!Meta融合新方法剑指下一代多模态王者
统一transformer与diffusion!Meta融合新方法剑指下一代多模态王者本文引入了 Transfusion,这是一种可以在离散和连续数据上训练多模态模型的方法。
来自主题: AI技术研报
13885 点击 2024-08-25 12:39

 搜索
本文引入了 Transfusion,这是一种可以在离散和连续数据上训练多模态模型的方法。

在人工智能领域,图像生成技术一直是一个备受关注的话题。近年来,扩散模型(Diffusion Model)在生成逼真且复杂的图像方面取得了令人瞩目的进展。然而,技术的发展也引发了潜在的安全隐患,比如生成有害内容和侵犯数据版权。这不仅可能对用户造成困扰,还可能涉及法律和伦理问题。
MICRO 全称 IEEE/ACM International Symposium on Microarchitecture,与 ISCA、HPCA、ASPLOS 并称为体系结构「四大顶会」,囊括了当年最先进的体系结构成果,被视作国际前沿体系结构研究的风向标,见证了诸多突破性成果的首次亮相,包括谷歌、英特尔、英伟达等企业在半导体领域的多项技术创新。
就在刚刚,Meta最新发布的Transfusion,能够训练生成文本和图像的统一模型了!完美融合Transformer和扩散领域之后,语言模型和图像大一统,又近了一步。也就是说,真正的多模态AI模型,可能很快就要来了!
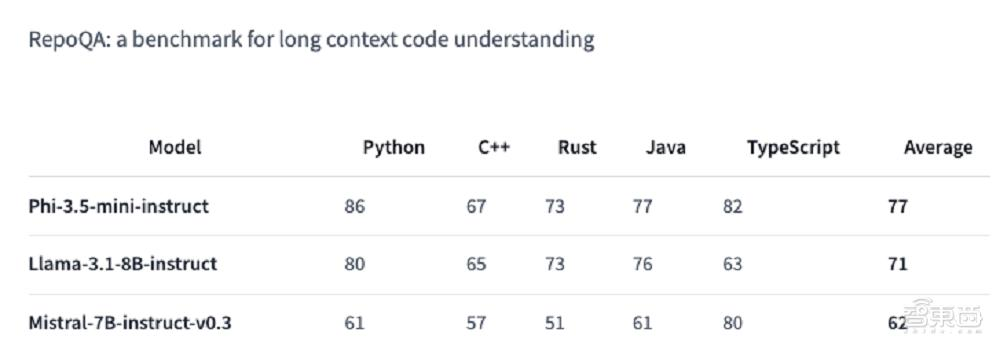
轻量级模型的春天要来了吗?
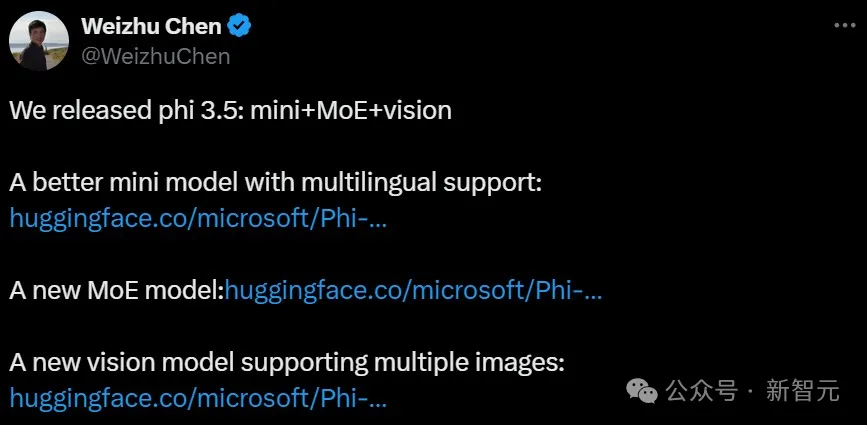
微软Phi 3.5系列上新了!mini模型小而更美,MoE模型首次亮相,vision模型专注多模态。
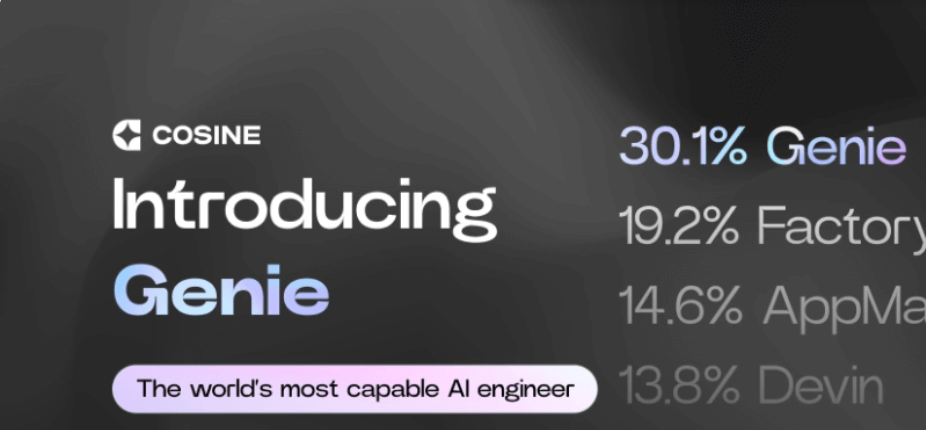
在科技日新月异的今天,人工智能(AI)正以前所未有的速度渗透到各个行业,其中软件开发领域也不例外。Cosine AI推出的Genie,作为一款革命性的AI编程助手,正以其卓越的能力和高效的工作方式,重新定义着软件编程的边界。Genie不仅能够在极短的时间内解决复杂的编程问题,还模仿了人类程序员的思考方式,为软件开发带来了前所未有的便利与效率。
本期我们邀请到了 纽约大学计算机科学院博士 童晟邦 带来【多模态大模型:视觉为中心的探索】的主题分享。

作为基础的视觉语言任务,指代表达理解(referring expression comprehension, REC)根据自然语言描述来定位图中被指代的目标。REC 模型通常由三部分组成:视觉编码器、文本编码器和跨模态交互,分别用于提取视觉特征、文本特征和跨模态特征特征交互与增强。
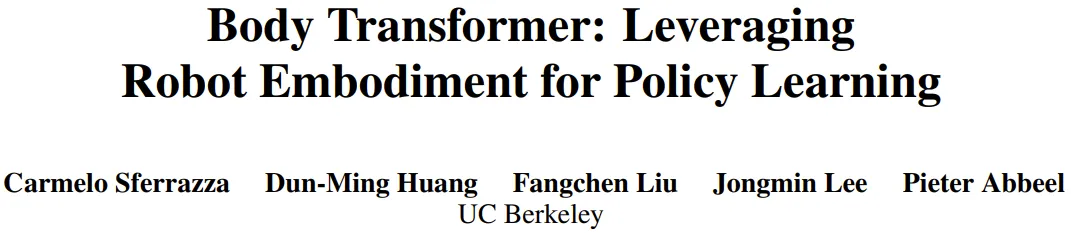
过去几年间,Transformer 架构已经取得了巨大的成功,同时其也衍生出了大量变体,比如擅长处理视觉任务的 Vision Transformer(ViT)。本文要介绍的 Body Transformer(BoT) 则是非常适合机器人策略学习的 Transformer 变体。