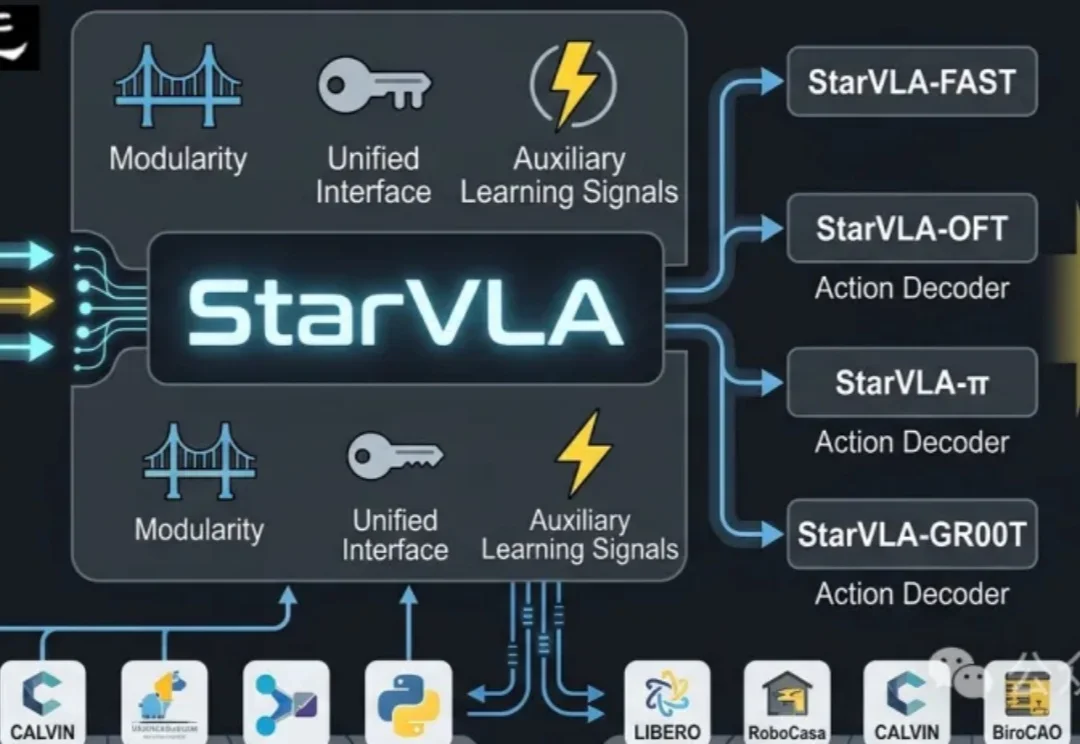
统一VLA范式!港科大开源StarVLA乐高式架构,复现成本大幅降低
统一VLA范式!港科大开源StarVLA乐高式架构,复现成本大幅降低当前具身智能的VLA(Vision-Language-Action)赛道正陷入典型的「碎片化」泥潭:不同团队采用异构的动作解码范式、强耦合的数据管线、互不兼容的评测协议,导致方法难以横向对比,复现成本极高。
来自主题: AI技术研报
12125 点击 2026-04-14 08:42

 搜索
当前具身智能的VLA(Vision-Language-Action)赛道正陷入典型的「碎片化」泥潭:不同团队采用异构的动作解码范式、强耦合的数据管线、互不兼容的评测协议,导致方法难以横向对比,复现成本极高。
让一个模型概括“这是一段什么视频”,并不难。
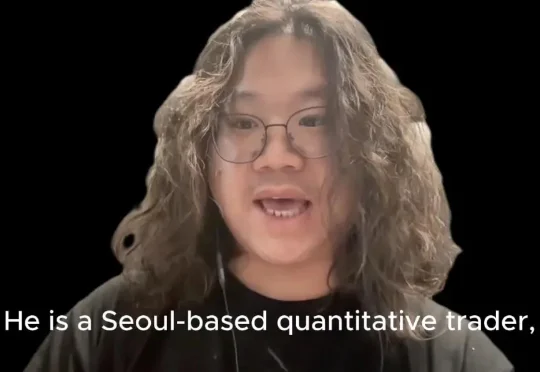
2025年之前,想要证明自己混得好,大概得腕上戴块百达翡丽,车库里停辆库里南。但到了AI时代,硬通货变了:看你一年到底烧了多少Token。一年烧掉250亿个Token,有位25岁的韩国小伙子,成了全世界最能烧的人。
过去一年,大模型的能力曲线几乎是指数上升的——推理更强、工具调用更稳、上下文窗口越撑越大。但一个越来越尖锐的问题也随之浮出水面:模型变强了,可承接它的那层东西在哪?
SiFive 是一家由加州大学伯克利分校工程师创办的公司,这些工程师创造了开源芯片设计,该公司已获得一轮超额认购的 4 亿美元融资,公司估值达 36.5 亿美元。
有人把这些规范都整理成了 MD 文件,都在这个网站上 getdesign.md。62 个全球顶级品牌的设计语言,提炼成结构化的DESIGN.md文件,让 AI 编码 Agent 能直接读懂并执行。
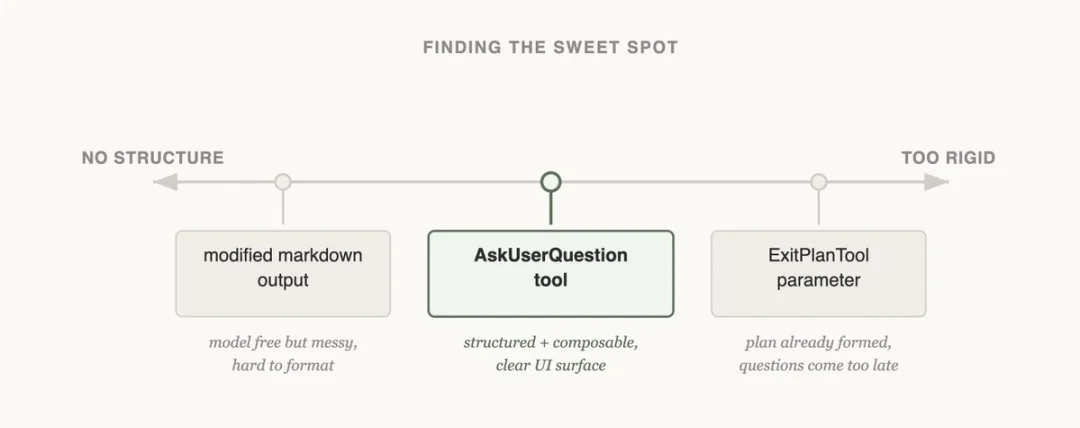
本文翻译自 Anthropic 官方博客「Seeing like an agent: how we design tools in Claude Code」,作者 Thariq Shihipar,Claude Code 团队工程师,今天发布。以下为逐段中英对照翻译
4 月 10 日晚,灵初智能发布了大模型、数据集与合作计划:包括策略模型 Psi-R2、世界模型 Psi-W0,以及总规模近 10 万小时的人类操作数据。它想回答的问题也很直接 —— 当真机数据不再是唯一解,机器人还能靠什么继续 scaling?
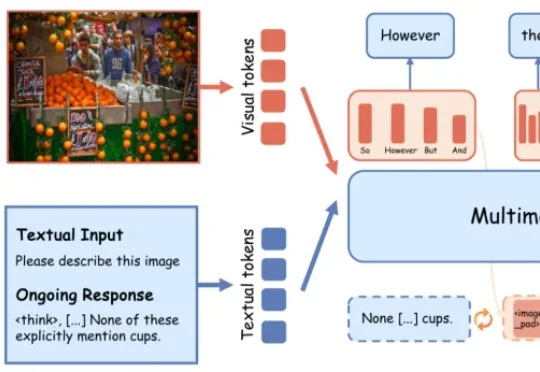
多模态大推理模型的幻觉,很多时候并非「没看见」,而是在最不确定的推理阶段想偏了。最新研究发现,模型在生成because、however、wait等transition words时,往往处于高熵关键节点,更容易脱离图像证据、转向语言脑补。LEAD在高熵阶段不急于输出单一离散token,而是先在潜在语义空间保留多种候选推理方向,并通过视觉锚点持续拉回图像证据,显著缓解幻觉。
2023 年,AI 生成的成人内容数量暴涨了 500%。同年,所有新增的成人素材里,有 25% 是 AI 造的。根据经济学人数据,AI 成人行业的规模在 2025 年大概 25 亿美元,这个数字往回倒 1 年是 1.5 亿美元,一年暴增 20 倍以上。AI 成人妥妥的「高速暴增品类」。