打破长视频理解瓶颈:HoPE混合位置编码提升VLM长度泛化能力
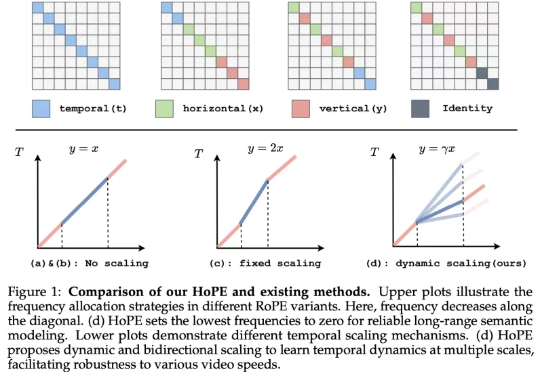
打破长视频理解瓶颈:HoPE混合位置编码提升VLM长度泛化能力如今的视觉语言模型 (VLM, Vision Language Models) 已经在视觉问答、图像描述等多模态任务上取得了卓越的表现。然而,它们在长视频理解和检索等长上下文任务中仍表现不佳。
来自主题: AI技术研报
8583 点击 2025-06-30 10:24

 搜索
如今的视觉语言模型 (VLM, Vision Language Models) 已经在视觉问答、图像描述等多模态任务上取得了卓越的表现。然而,它们在长视频理解和检索等长上下文任务中仍表现不佳。
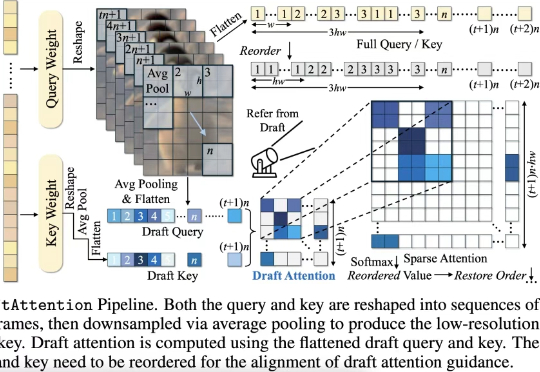
在高质量视频生成任务中,扩散模型(Diffusion Models)已经成为主流。然而,随着视频长度和分辨率的提升,Diffusion Transformer(DiT)模型中的注意力机制计算量急剧增加,成为推理效率的最大瓶颈。
杜塞尔多夫讯,AI初创企业Synthflow近日完成2000万美元(约合人民币1.45亿元)融资。此次A轮融资由美国投资机构安克创投(Accel)领投,该机构曾投资支付平台Klarna、流媒体Spotify及流程优化软件Celonis。现有投资方Atlantic Labs和Singular也参与本轮注资。《商报》独家获悉此消息。
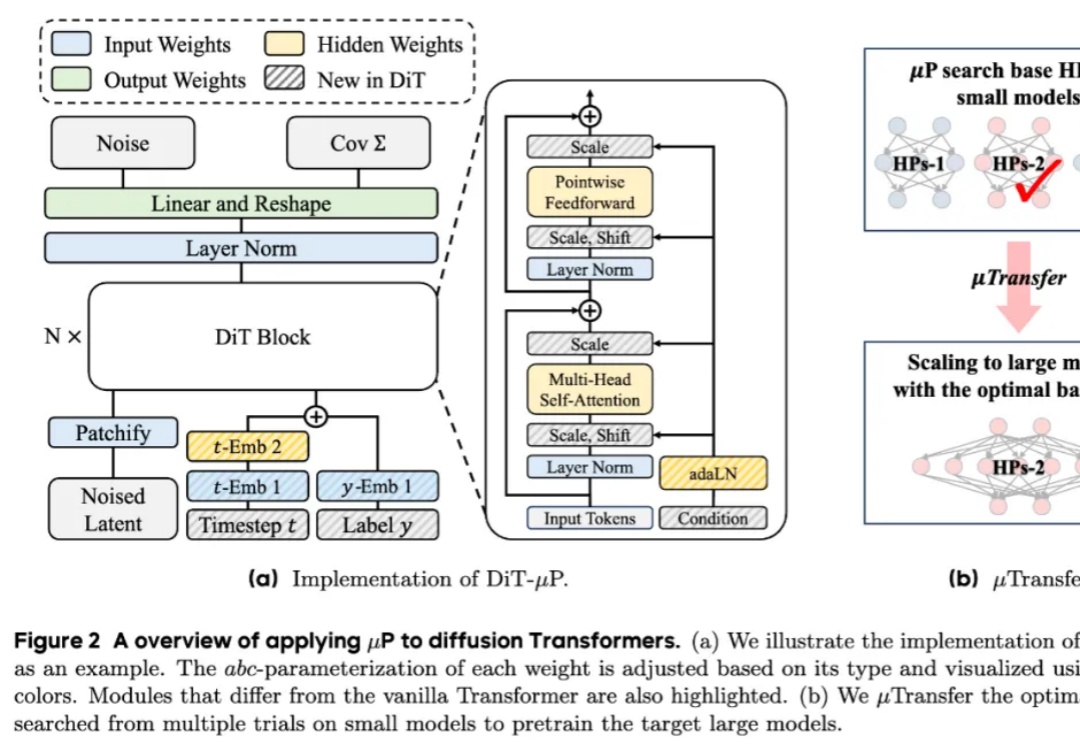
近年来,diffusion Transformers已经成为了现代视觉生成模型的主干网络。随着数据量和任务复杂度的进一步增加,diffusion Transformers的规模也在快速增长。然而在模型进一步扩大的过程中,如何调得较好的超参(如学习率)已经成为了一个巨大的问题,阻碍了大规模diffusion Transformers释放其全部的潜能。
你能想象吗?一个在立陶宛车库里诞生的创业项目,仅仅一年时间就做到了 1200 万美元的年收入,服务超过 4 万家付费客户,遍布全球 100 多个国家。更令人震惊的是,它的创始人 Chris Sidlauskas 在创立 Sintra 时才 22 岁,而他的联合创始人 Rokas Judickas 甚至更年轻。
AI落后、Siri乏力、与谷歌搜索合作紧张,苹果要放大招了?网友支招:不如买下OpenAI前CTO的Thinking Machines Lab!
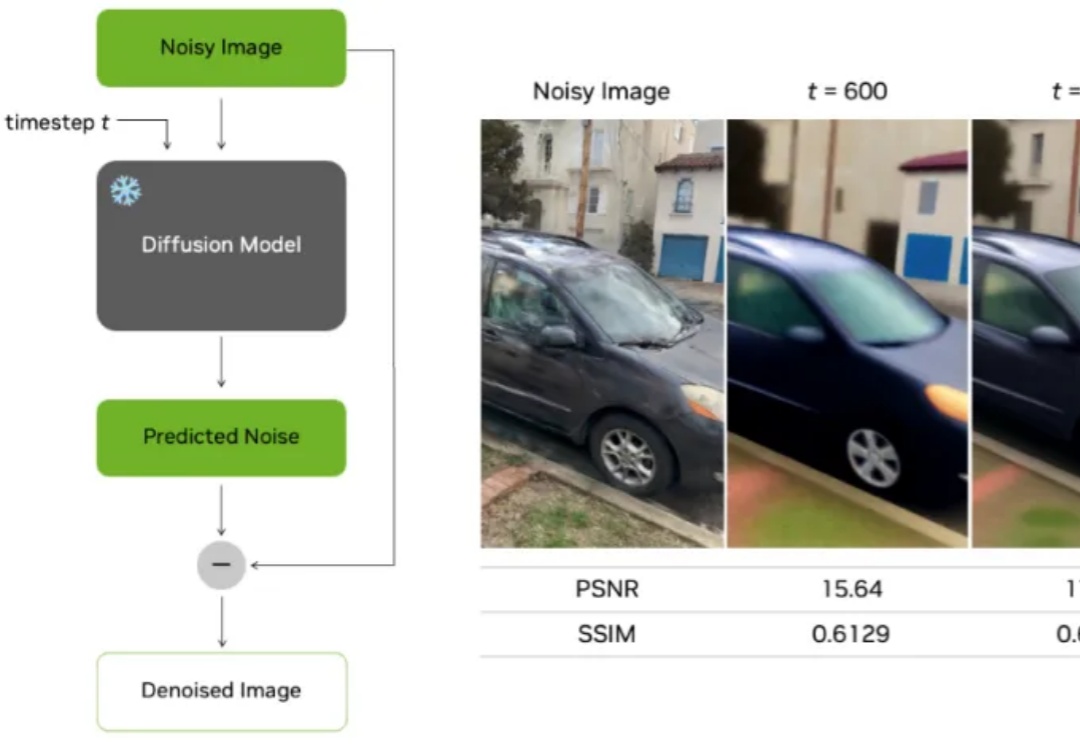
在 3D 重建领域,无论是 NeRF 还是最新的 3D Gaussian Splatting(3DGS),在生成逼真新视角时仍面临一个核心难题:视角一旦偏离训练相机位置,图像就容易出现模糊、鬼影、几何错乱等伪影,严重影响实际应用。
AI战火越烧越旺,苹果也坐不住了!据爆料,库克正密谋史上最大手笔收购——他盯上了估值高达140亿美元的AI搜索新星Perplexity!这场豪赌不仅会改写Siri和Safari的命运,更是苹果对抗OpenAI和谷歌的一记重拳。谁说苹果不焦虑?这次要动真格了。
根据Xsignal AI Holo(AI全息)数据库数据,上图呈现出2025年5月中国Web端AI应用类型的发展全景。
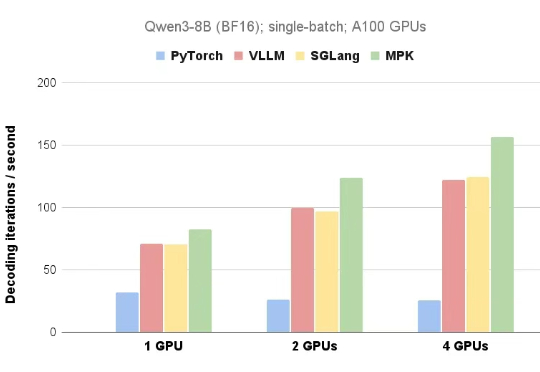
在 AI 领域,英伟达开发的 CUDA 是驱动大语言模型(LLM)训练和推理的核心计算引擎。