AI资讯新闻榜单内容搜索-Xpert

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: Xpert
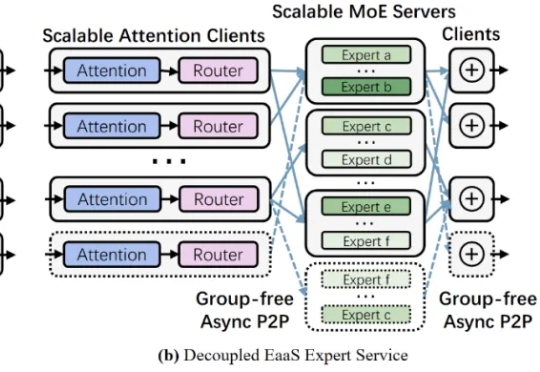
为MoE解绑:全新「专家即服务」推理架构发布,超细粒度扩展锐减37.5%成本

为MoE解绑:全新「专家即服务」推理架构发布,超细粒度扩展锐减37.5%成本

为MoE解绑:全新「专家即服务」推理架构发布,超细粒度扩展锐减37.5%成本

近年来,大型语言模型的参数规模屡创新高,随之而来的推理开销也呈指数级增长。如何降低超大模型的推理成本,成为业界关注的焦点之一。Mixture-of-Experts (MoE,混合专家) 架构通过引入大量 “专家” 子模型,让每个输入仅激活少数专家,从而在参数规模激增的同时避免推理计算量同比增长。

来自主题: AI技术研报
9863 点击    2025-10-13 15:49
突发!Grok 4 永久免费使用

突发!Grok 4 永久免费使用

突发!Grok 4 永久免费使用

刚刚,xAI 宣布,Grok 4 从现在起对全球所有用户免费开放!不是试用,不是限时,而是真正的免费。不再是鸽rok,而是Grok!使用 Auto 模式,系统会自动判断你的问题复杂度,把需要高级推理的查询路由到 Grok 4。如果你想要更多控制权,随时可以切换到 Expert 模式,让每个查询都走 Grok 4。

来自主题: AI资讯
11649 点击    2025-08-11 09:47
华为:让DeepSeek的“专家们”动起来,推理延迟降10%!

华为:让DeepSeek的“专家们”动起来,推理延迟降10%!

华为:让DeepSeek的“专家们”动起来,推理延迟降10%!

要问最近哪个模型最火,混合专家模型(MoE,Mixture of Experts)绝对是榜上提名的那一个。

来自主题: AI技术研报
10391 点击    2025-05-20 15:16
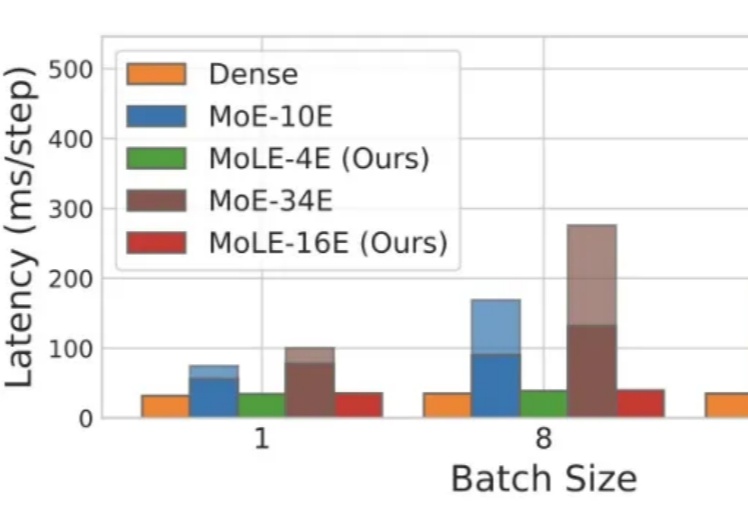
ICML 2025 Spotlight|华为诺亚提出端侧大模型新架构MoLE,内存搬运代价降低1000倍

ICML 2025 Spotlight|华为诺亚提出端侧大模型新架构MoLE,内存搬运代价降低1000倍

ICML 2025 Spotlight|华为诺亚提出端侧大模型新架构MoLE,内存搬运代价降低1000倍

Mixture-of-Experts(MoE)在推理时仅激活每个 token 所需的一小部分专家,凭借其稀疏激活的特点,已成为当前 LLM 中的主流架构。然而,MoE 虽然显著降低了推理时的计算量,但整体参数规模依然大于同等性能的 Dense 模型,因此在显存资源极为受限的端侧部署场景中,仍然面临较大挑战。

来自主题: AI技术研报
9225 点击    2025-05-07 09:30
AMD GPU性能暴涨7倍,优化算法首次开源!高效MoE支持任意专家数量

AMD GPU性能暴涨7倍,优化算法首次开源!高效MoE支持任意专家数量

AMD GPU性能暴涨7倍,优化算法首次开源!高效MoE支持任意专家数量

通过完全启用并发多块执行,支持任意专家数量(MAX_EXPERT_NUMBER==256),并积极利用共享内存(5kB LDS)和寄存器(52 VGPRs,48 SGPRs),MoE Align & Sort逻辑被精心设计,实现了显著的性能提升:A100提升3倍,H200提升3倍,MI100提升10倍,MI300X/MI300A提升7倍...

来自主题: AI技术研报
5758 点击    2025-04-03 16:14
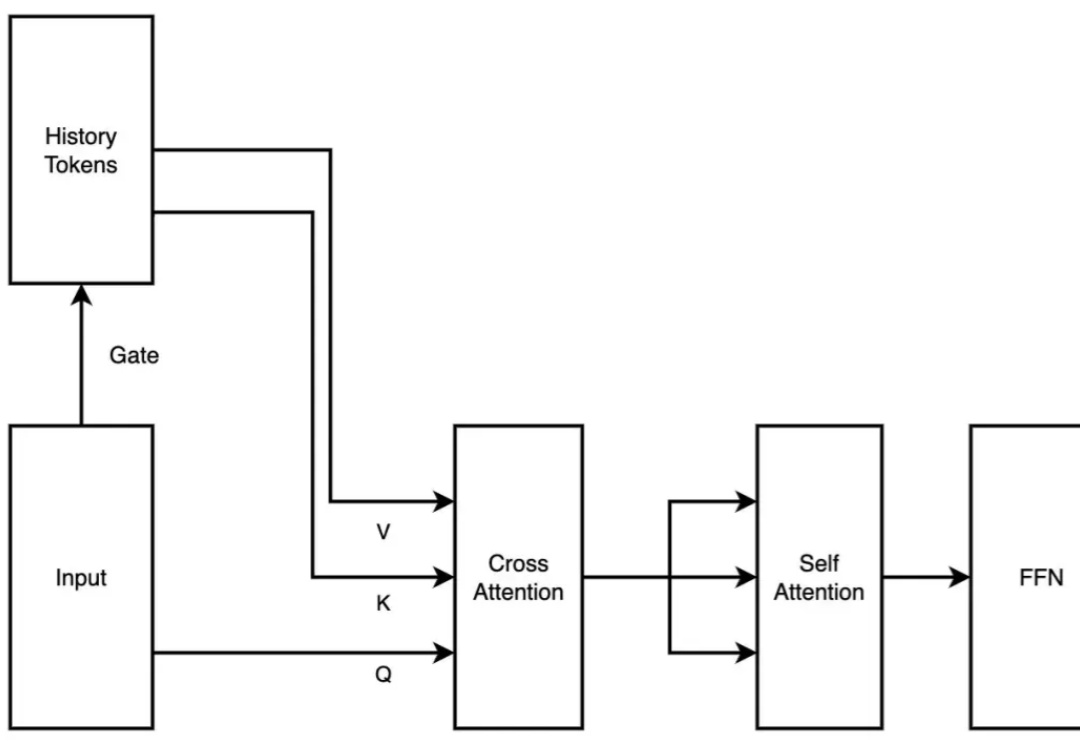
DeepSeek前实习生魔改MoE,用迭代机制把内存需求砍了42%,团队:“免费午餐”优化方法

DeepSeek前实习生魔改MoE,用迭代机制把内存需求砍了42%,团队:“免费午餐”优化方法

DeepSeek前实习生魔改MoE,用迭代机制把内存需求砍了42%,团队:“免费午餐”优化方法

DeepSeek MoE“变体”来了,200美元以内,内存需求减少17.6-42%! 名叫CoE(Chain-of-Experts),被认为是一种“免费午餐”优化方法,突破了MoE并行独立处理token、整体参数数量较大需要大量内存资源的局限。

来自主题: AI技术研报
7867 点击    2025-03-04 20:02
一文详解:DeepSeek 第四天开源的模型设计套件

一文详解:DeepSeek 第四天开源的模型设计套件

一文详解:DeepSeek 第四天开源的模型设计套件

第四天,DeepSee发布包括三个主要项目: DualPipe- 一种用于 V3/R1 训练的双向流水线并行算法,实现计算和通信完全重叠; EPLB(Expert Parallelism Load Balancer) - 专为 V3/R1 设计的专家并行负载均衡器; Profile-data- 分析 V3/R1 中计算与通信重叠的性能数据集。

来自主题: AI技术研报
11450 点击    2025-02-27 12:16
月之暗面Kimi的技术一点都不落后。

月之暗面Kimi的技术一点都不落后。

月之暗面Kimi的技术一点都不落后。

2 月 18 日,月之暗面发布了一篇关于稀疏注意力框架 MoBA 的论文。MoBA 框架借鉴了 Mixture of Experts(MoE)的理念,提升了处理长文本的效率,它的上下文长度可扩展至 10M。并且,MoBA 支持在全注意力和稀疏注意力之间无缝切换,使得与现有的预训练模型兼容性大幅提升。

来自主题: AI技术研报
10441 点击    2025-02-23 11:38
时序大模型突破十亿参数!新混合专家架构,普林斯顿格里菲斯等机构出品

时序大模型突破十亿参数!新混合专家架构,普林斯顿格里菲斯等机构出品

时序大模型突破十亿参数!新混合专家架构,普林斯顿格里菲斯等机构出品

时序大模型,参数规模突破十亿级别。 来自全球多只华人研究团队提出了一种基于混合专家架构(Mixture of Experts, MoE)的时间序列基础模型——Time-MoE。

来自主题: AI资讯
6464 点击    2024-10-28 17:13