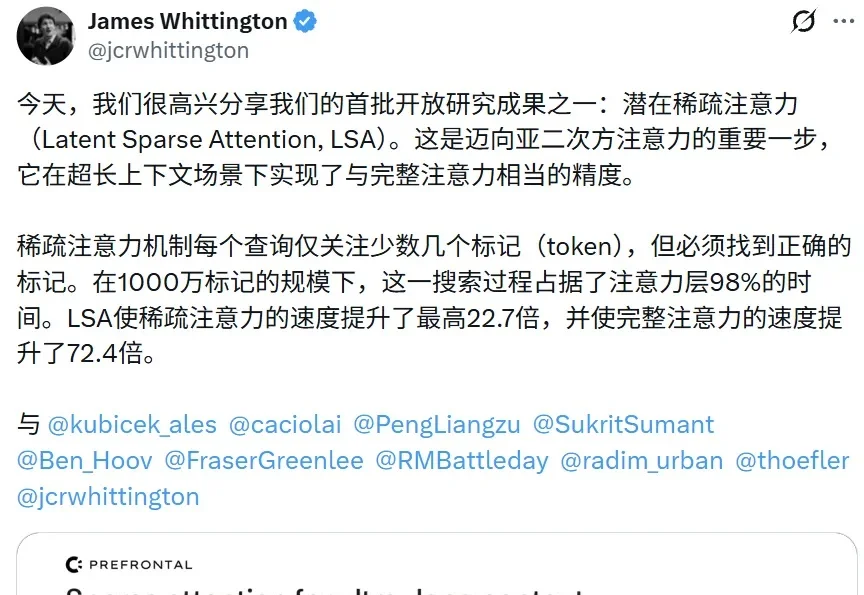
千万token下,比DeepSeek式稀疏注意力再快22倍
千万token下,比DeepSeek式稀疏注意力再快22倍如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。
搜索
如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。
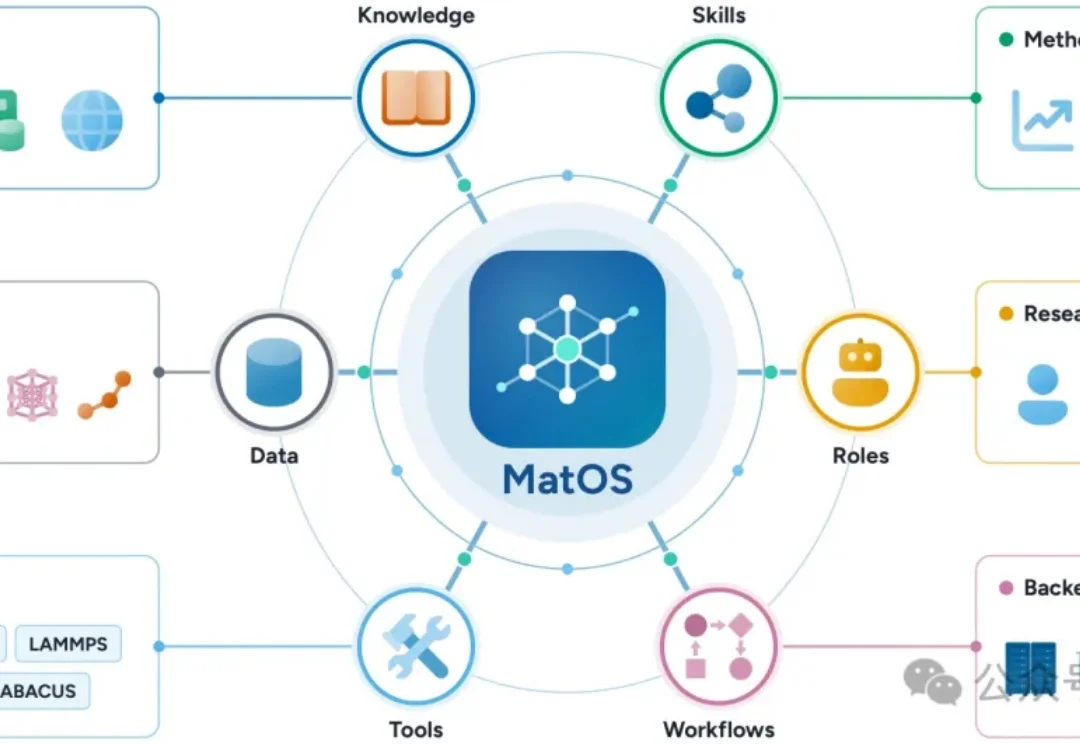
大模型智能体已经能够检索文献、调用模拟软件,甚至与自动化实验室协同工作。但要让它们独立完成一项完整的材料研究,仍然面临挑战:
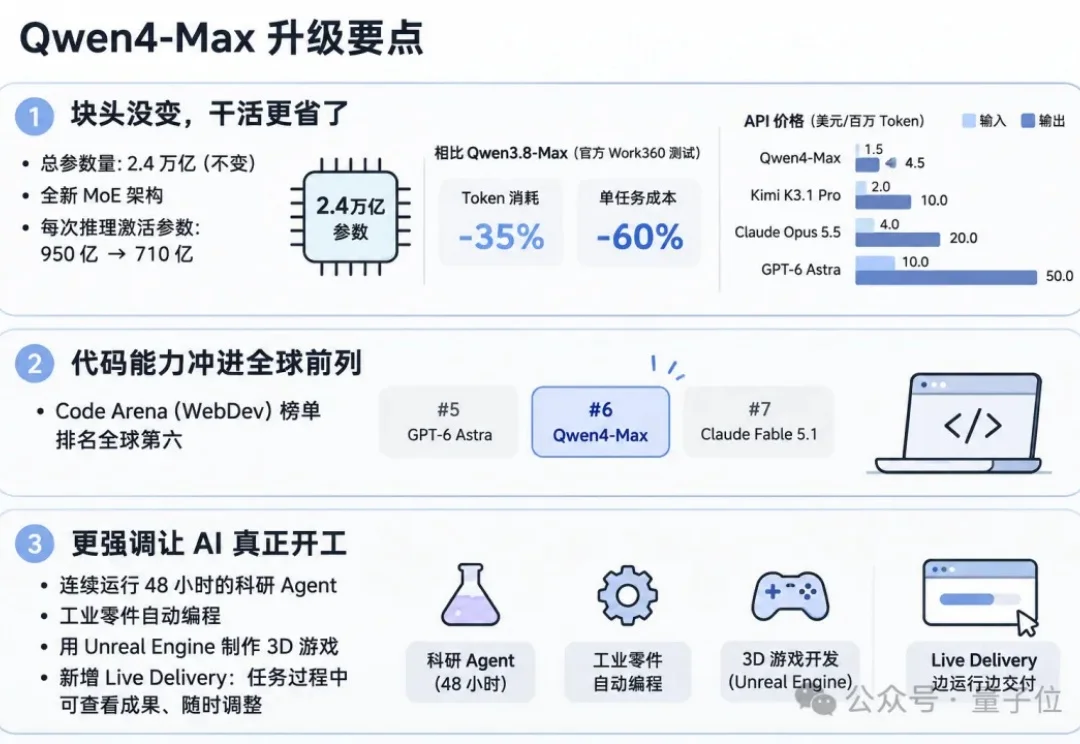
Qwen4-Max发布24小时后,第一波外部测评火速出炉!!
11 月 9 日,Anthropic 发布了新模型 Claude Fable 5.2,它很厉害,带 1000 个分身在 30 小时内做完了费马大定理的形式化证明,解开两道黑洞和量子引力难题,还花 8 天从零写出一套能在笔记本上开机的操作系统。
杨植麟创办的月之暗面正推进香港上市前股权架构重组,最新私人融资估值达500亿美元,Kimi API及海外收入快速增长。
传了好久的GPT-6.2 Astra,至今还是没影儿。
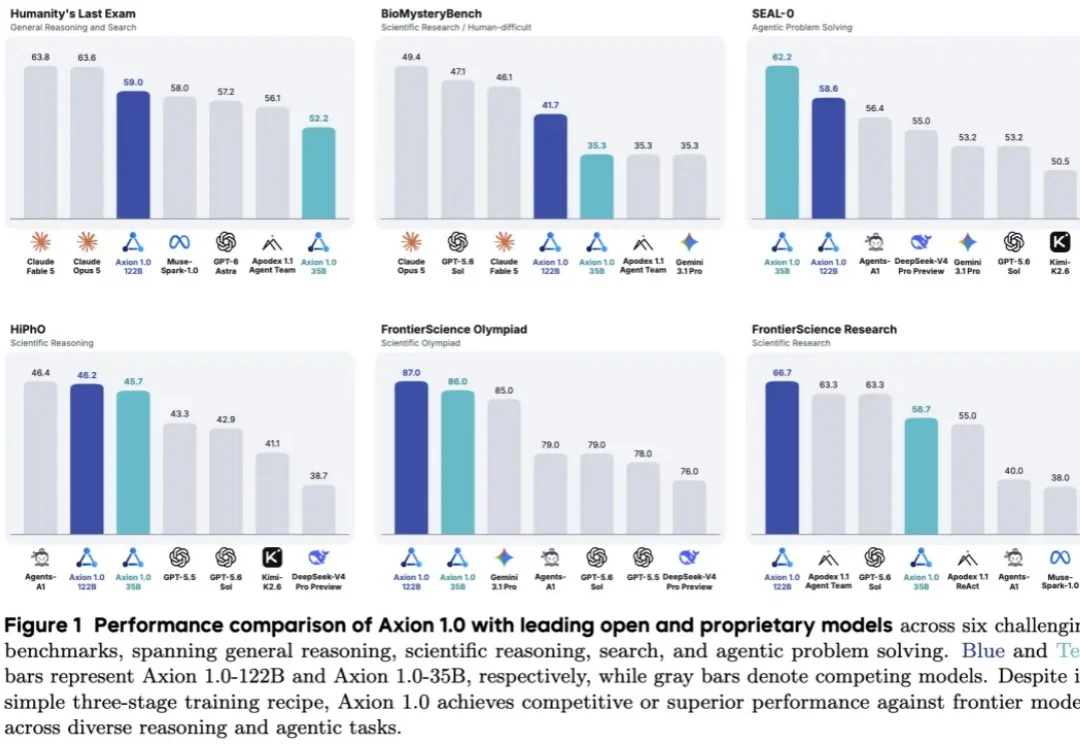
硅谷最卷的新赛道,刚刚杀出了一位开源新王!
给“机器人战场”建立新坐标。
能搜索资料、运行代码,还能完成多步科学研究任务——训练这样的智能体,究竟需要多少道工序?
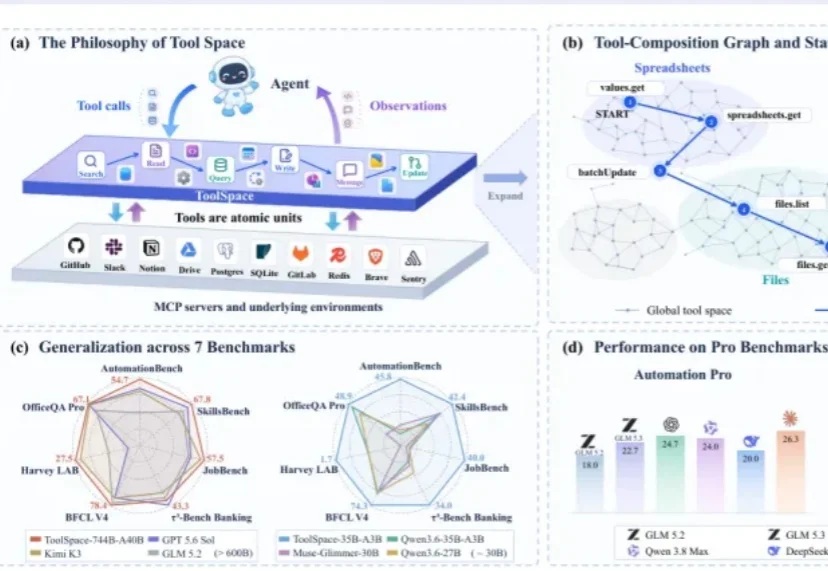
给智能体造训练环境,一定要先从数据库开始吗?现有的环境合成方法通常以数据为中心,先生成数据库和业务场景,再据此构造工具与任务。但沿着这条路线,工具接口和参数逻辑可能偏离真实定义,工具组合也可能缺少执行依据,任务往往局限于单个环境。