马斯克:AI海啸巨浪袭来,DOGE就是沙滩捡垃圾!超级智能最晚明年到
马斯克:AI海啸巨浪袭来,DOGE就是沙滩捡垃圾!超级智能最晚明年到马斯克最新YC创业学校演讲,AI将于今年或明年达到超级智能,人类正处于智能大爆炸的黎明。
来自主题: AI资讯
8318 点击 2025-06-22 16:59

 搜索
马斯克最新YC创业学校演讲,AI将于今年或明年达到超级智能,人类正处于智能大爆炸的黎明。
Y Combinator 最近在旧金山举办的 AI Startup School 活动,邀请了大量 AI 领域最具影响力的创始人和专家进行现场对谈和演讲,之前 Andrej Karpathy 在活动上的演讲视频爆火,现在 OpenAI CEO Sam Altman 的最新采访也已上线。
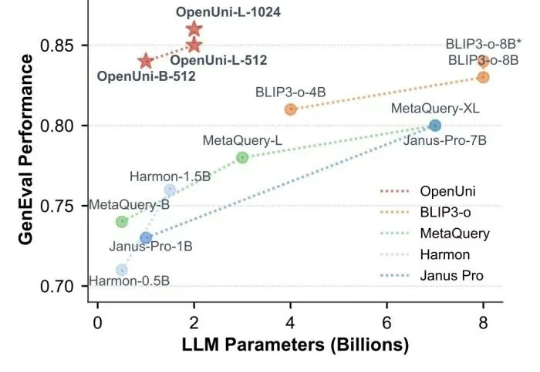
随着 GPT-4o 展现出令人印象深刻的多模态能力,将视觉理解和图像生成统一到单一模型中已成为 AI 领域的研究趋势(如MetaQuery 和 BLIP3-o )。
强化学习可以提升LLM推理吗?英伟达ProRL用超2000步训练配方给出了响亮的答案。仅15亿参数模型,媲美Deepseek-R1-7B,数学、代码等全面泛化。
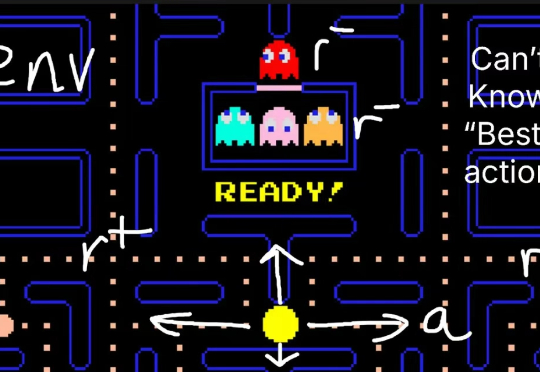
强化学习(RL)已经成为当今 LLM 不可或缺的技术之一。从大模型对齐到推理模型训练再到如今的智能体强化学习(Agentic RL),你几乎能在当今 AI 领域的每个领域看到强化学习的身影。
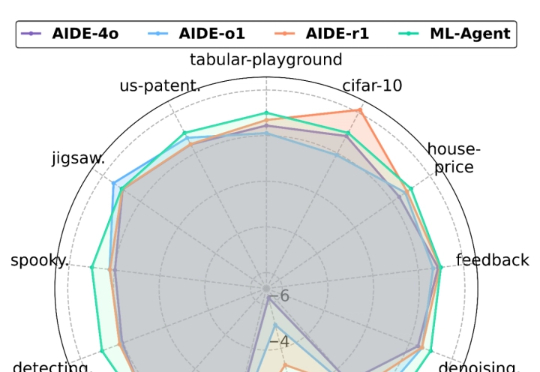
尽管人工智能(AI)在飞速发展,当前 AI 开发仍严重依赖人类专家大量的手动实验和反复的调参迭代,过程费时费力。

据《金融时报》报道,由OpenAI 前CTO Mira Murati 创立的隐秘人工智能初创公司 Thinking Machines Lab 已完成 20 亿美元种子轮融资 。这笔交易使这家成立仅 6 个月的初创公司估值达到 100 亿美元。
你能想象一个汽车经销商每天漏接45%电话的场景吗?这意味着几乎一半想要预约保养、询问配件或购车咨询的客户都被直接晾在了一边。
大语言模型(LLMs)在决策场景中常因贪婪性、频率偏差和知行差距表现欠佳。研究者提出强化学习微调(RLFT),通过自我生成的推理链(CoT)优化模型,提升决策能力。实验表明,RLFT可增加模型探索性,缩小知行差距,但探索策略仍有改进空间。
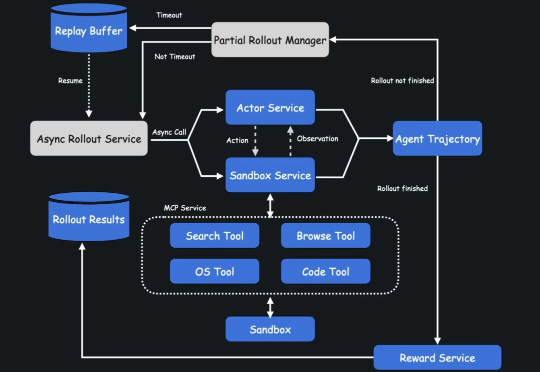
这款 Agent 擅长多轮搜索和推理,平均每项任务执行 23 个推理步骤,访问超过 200 个网址。它是基于 Kimi k 系列模型的内部版本构建,并完全通过端到端智能体强化学习进行训练,也是国内少有的基于自研模型打造的 Agent。