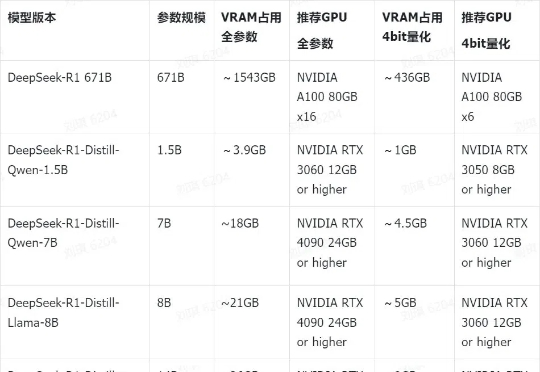
关于DeepSeek部署的一切,都在这里
关于DeepSeek部署的一切,都在这里DeepSeek-R1及其蒸馏版本模型突破了AI Reasoning和大规模AI性能的新基准,其中DeepSeek-R1-Zero和DeepSeek-R1,已经在推理和问题求解上树立了新的标准。本次研究聚焦于如何利用已有的机器进行模型部署,使用这些先进的模型进行开发和研究。
来自主题: AI技术研报
13641 点击 2025-02-21 18:06

 搜索
DeepSeek-R1及其蒸馏版本模型突破了AI Reasoning和大规模AI性能的新基准,其中DeepSeek-R1-Zero和DeepSeek-R1,已经在推理和问题求解上树立了新的标准。本次研究聚焦于如何利用已有的机器进行模型部署,使用这些先进的模型进行开发和研究。
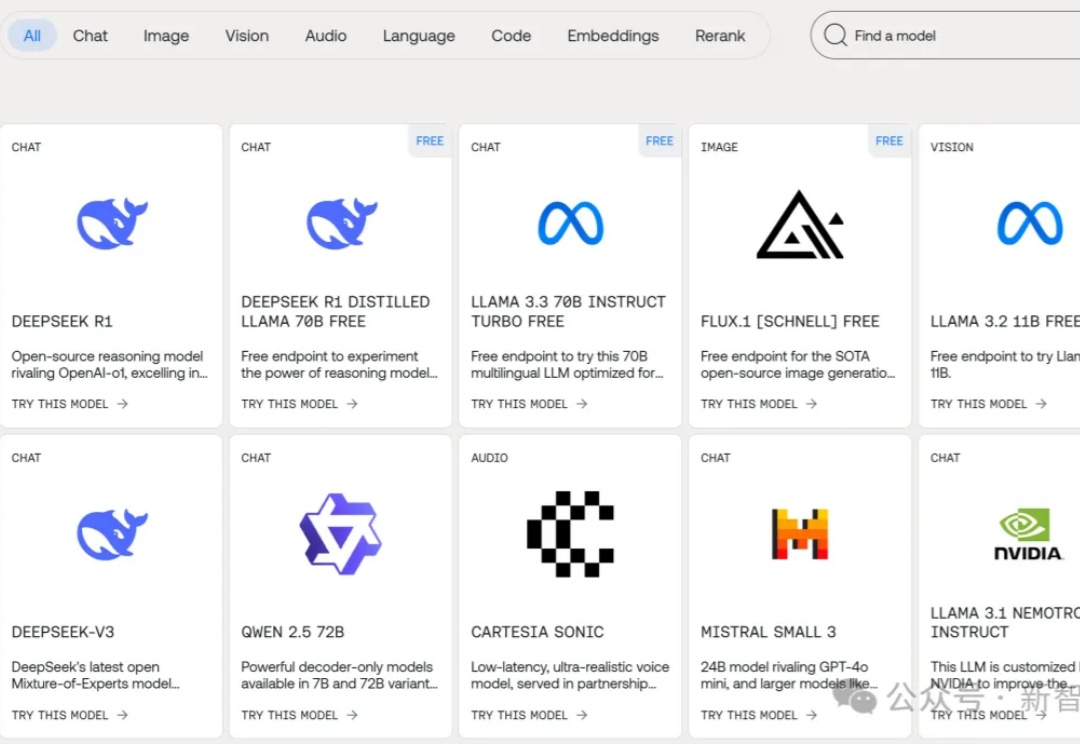
美国AI云服务商Together AI宣布完成3.05亿美元B轮融资,估值高达33亿美元!该公司押注开源模型,提供包括DeepSeek-R1在内的200多个模型API服务,并出租GPU算力,年收入已超1亿美元。

Mercor,由三位 21 岁的 Thiel Fellows 创办的人工智能招聘初创公司,已在 B 轮融资中筹集了 1 亿美元,公司向 TechCrunch 确认了这一消息。
在AI计算资源日益稀缺的时代,Lambda凭借其独特的云GPU解决方案迅速崛起,成为资本市场的宠儿。最近,这家成立于2012年的AI云计算公司宣布完成4.8亿美元D轮融资,累计融资额达到8.63亿美元,跻身AI创投榜云科技赛道第二位,仅次于Coreweave。此次投资阵容强大,包括英伟达、AI技术大牛Andrej Karpathy,以及和硕、超微、纬创、纬颖等行业巨头的战略入股。
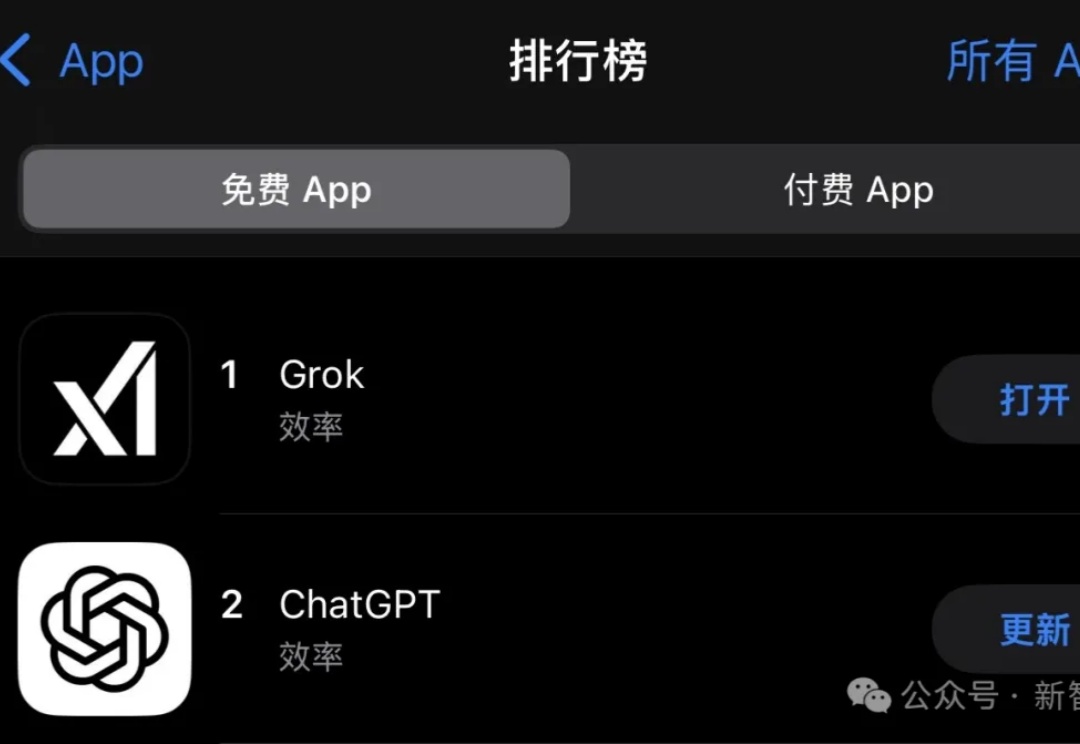
官宣免费后,Grok火速登顶美区App Store榜首,同时,xAI也放出官方博文,秀了一把模型的数学、代码、ASCII Art演示。最引人瞩目的两位C位华人,均来自多伦多大学,分别和Hinton、Bengio有交集。
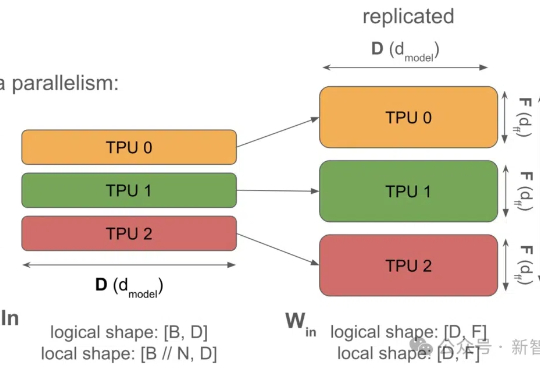
谷歌团队发布LLM硬核技术教科书,从「系统视图」揭秘LLM Scaling的神秘面纱。Jeff Dean强调书中藏着谷歌最强AI模型Gemini训练的更多信息。
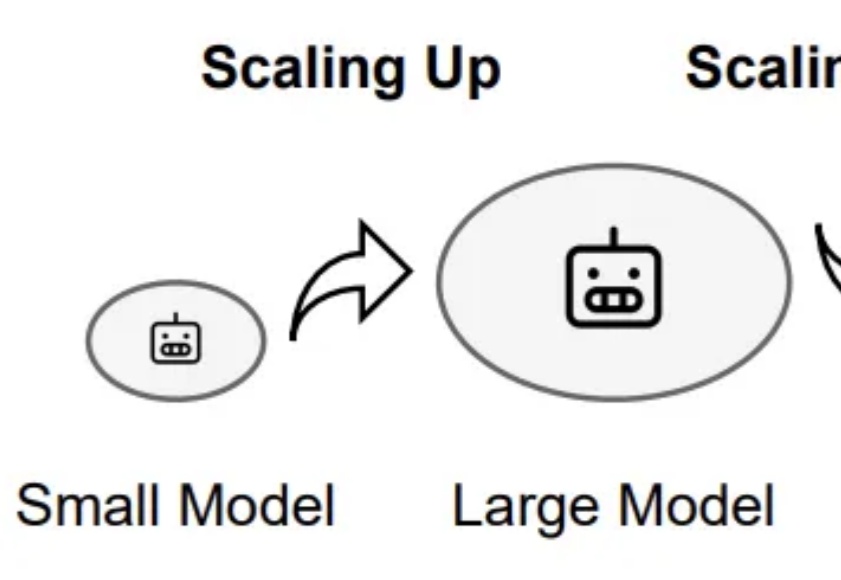
近年来, Scaling Up 指导下的 AI 基础模型取得了多项突破。从早期的 AlexNet、BERT 到如今的 GPT-4,模型规模从数百万参数扩展到数千亿参数,显著提升了 AI 的语言理解和生成等能力。然而,随着模型规模的不断扩大,AI 基础模型的发展也面临瓶颈:高质量数据的获取和处理成本越来越高,单纯依靠 Scaling Up 已难以持续推动 AI 基础模型的进步。
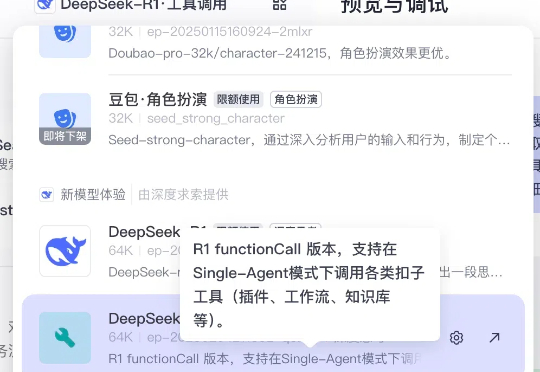
众所周知,目前 DeepSeek R1 有一个很大的痛点是不支持 Function Call 的。GitHub 上有许多开发者都表达了这一诉求。
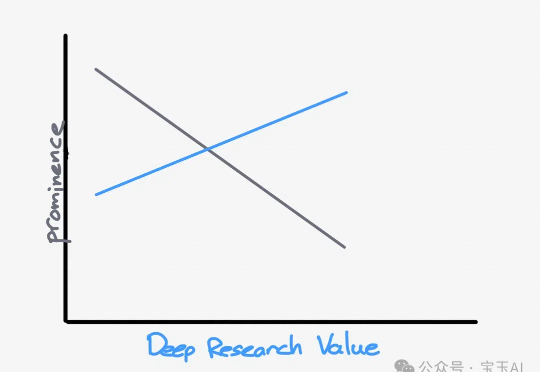
知名博主 Ben Thompson 在使用 Deep Research 后写的一篇 Deep Research and Knowledge Value[1],谈到了在信息搜索上带来的价值。
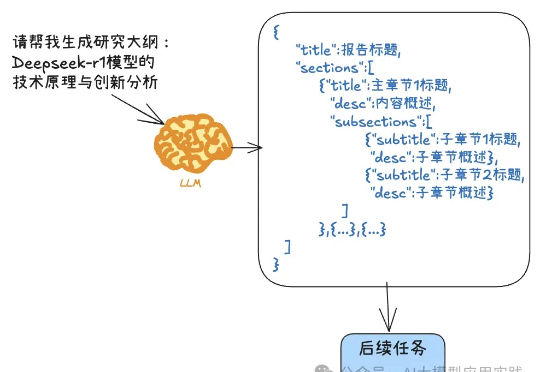
DeepSeek-R1这样的推理模型有着强大的深度思考能力,但也有着一些不同于通用模型的特点与用法,比如不支持函数调用,不支持结构化输出,o1甚至不支持系统提示(System Prompt)等。尽管这和它们的使用场景有关,但有时也会带来不便。今天我们就来说说结构化输出这个常见的问题。