OpenAI最新提示词指南更新了,官方教你8招玩透ChatGPT!
OpenAI最新提示词指南更新了,官方教你8招玩透ChatGPT!号外号外,OpenAI最新提示词指南更新了!如果你还没驯服ChatGPT,或者还在被它像毛线团一样越理越乱的回答折腾得苦不堪言,那么今天这篇OpenAI最新提示词指南,你一定要好好收藏!
来自主题: AI资讯
10798 点击 2026-07-16 12:41

 搜索
号外号外,OpenAI最新提示词指南更新了!如果你还没驯服ChatGPT,或者还在被它像毛线团一样越理越乱的回答折腾得苦不堪言,那么今天这篇OpenAI最新提示词指南,你一定要好好收藏!

Codex 首款硬件,来了。
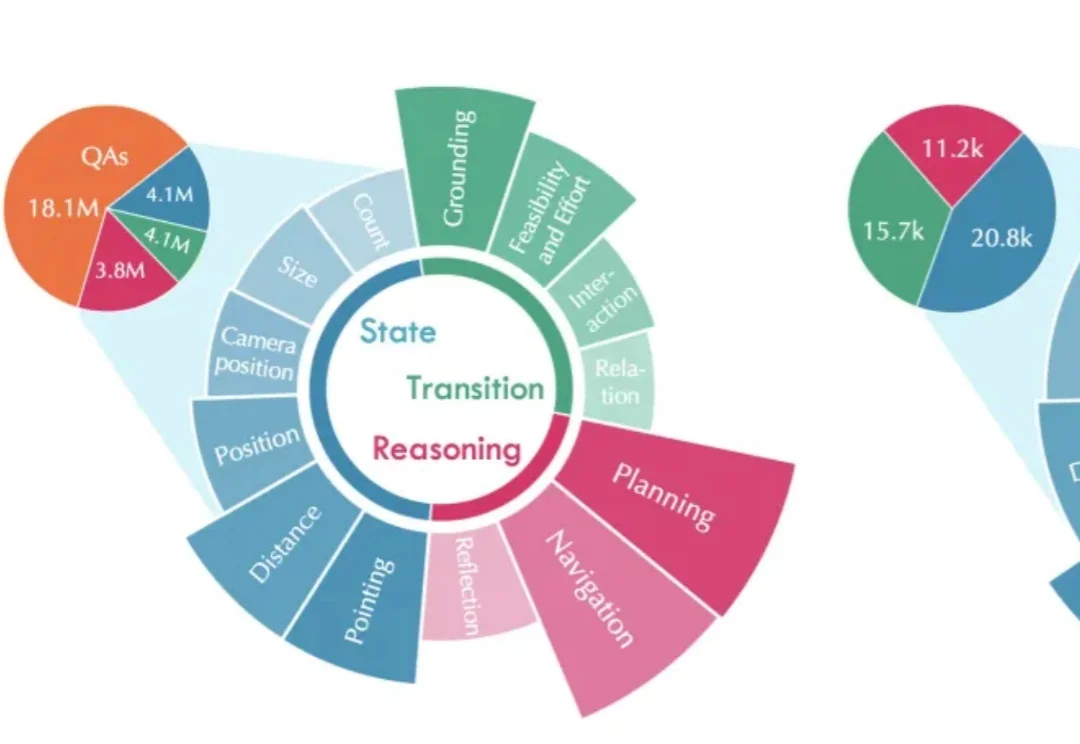
7 月 15 日,腾讯 Robotics X 实验室以及福田实验室联合腾讯混元推出两款具身智能基座模型 —— 具身 VLM 基座模型 Hy-Embodied-VLM-1.0 以及 具身世界认知基座模型 Hy-Embodied-RxBrain-1.0,不仅让具身大脑能够 “看” 懂现实世界,还学会同时推理和想象。
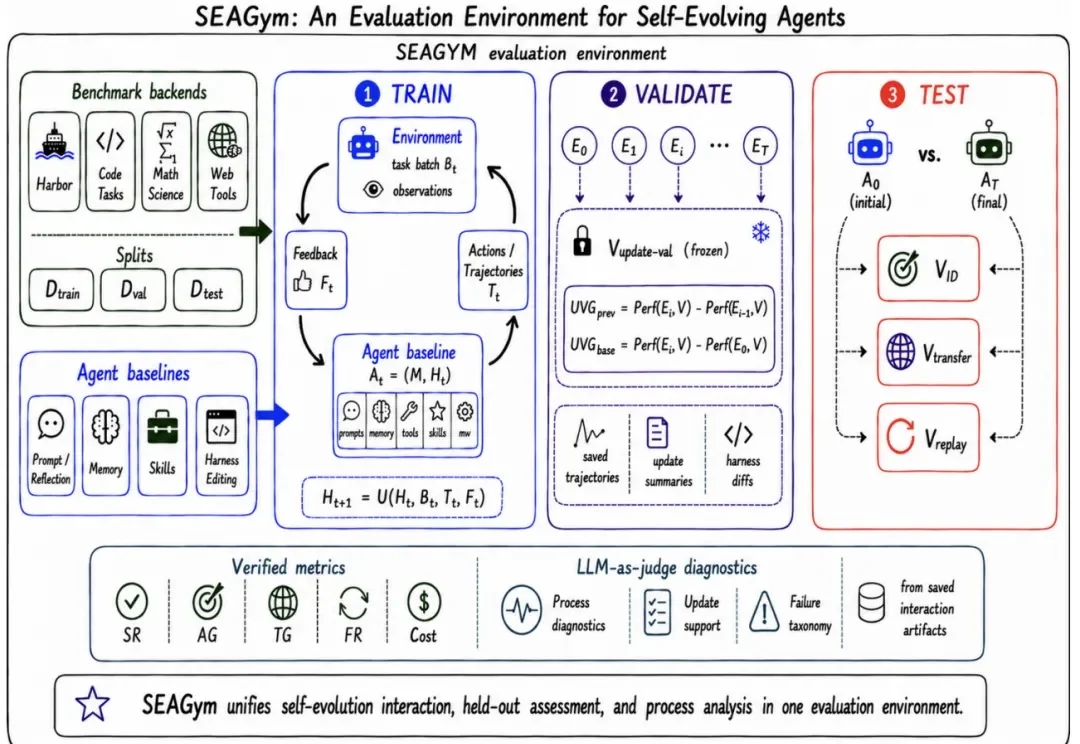
近日,翁荔发布长文 《Harness Engineering for Self-Improvement》,系统梳理了 harness engineering 在 AI 自我改进中的作用。
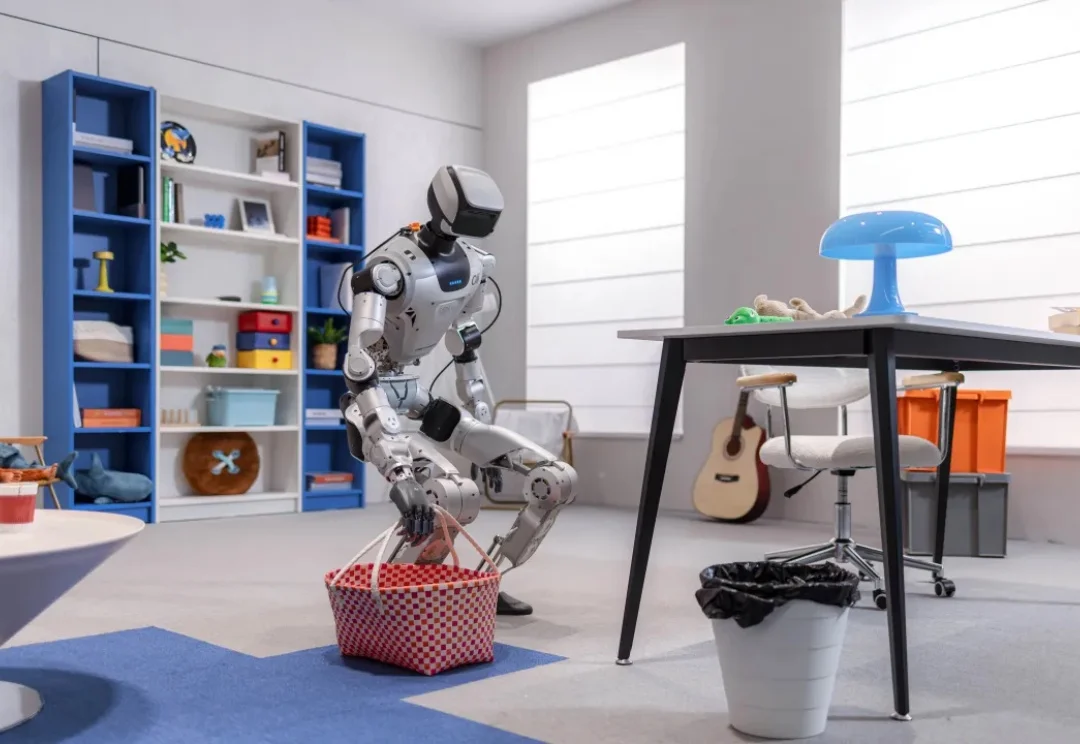
昨天刚完成2亿美元Pre-IPO轮融资,逐际动力没有急着讲资本故事,而是立马甩出一段全尺寸人形机器人Oli全自主做家务的视频:
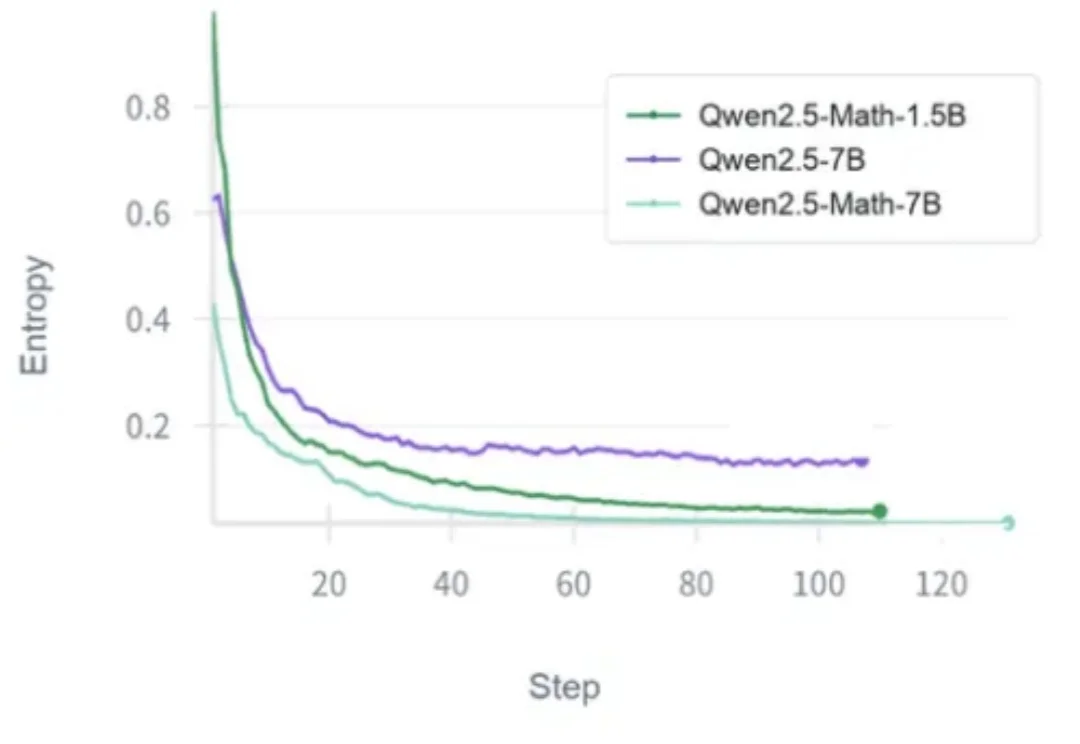
基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards,RLVR)正在成为大模型后训练的关键技术。数学题能判对错,代码能跑测试,可验证奖励让大模型可以通过强化学习持续提升推理能力。
WorldArena 1.0 的核心意义,在于将世界模型评测从 “好不好看” 推进到 “是否真的有用”。它不再只关注视频观感,而是把物理一致性、可控性、3D 准确性和具身任务功能性纳入统一评测框架,使许多看似流畅的生成结果第一次在机器人具身任务中接受检验。
推理大模型 (如 DeepSeek-R1、o1) 靠长思维链拿高分,却普遍「想太多」: 研究统计了五个代表性模型里,发现有 41–52% 的 token 是在模型给出它的最终答案之后生成的。
Raft是一个很神奇的AI产品。当它还叫Slock的时候,我认为这主要是一个投资人自嗨产物。除了极少数自己充了Claude、Codex会员,同时本地电脑还有Opencode、Pi等一系列Agent的极致变态电子佬用户,没人需要一个AI群聊。
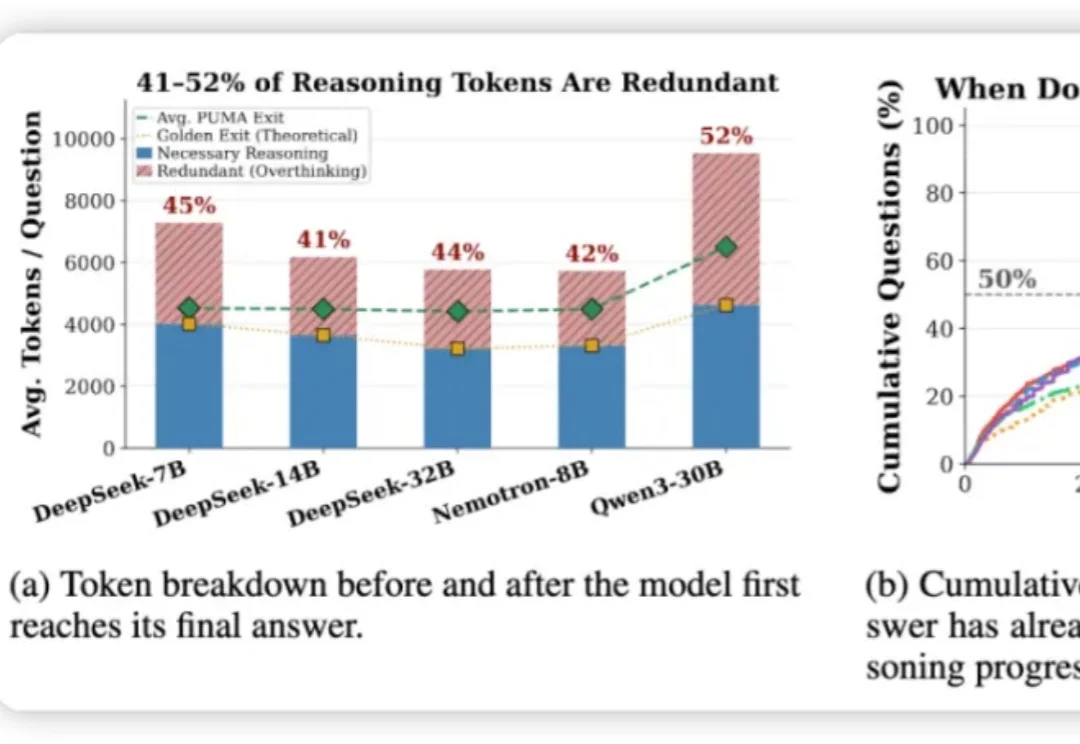
推理大模型 (如 DeepSeek-R1、o1) 靠长思维链拿高分,却普遍「想太多」: 研究统计了五个代表性模型里,发现有 41–52% 的 token 是在模型给出它的最终答案之后生成的。