Thinking Machines曝LoRA终极指南:10倍学习率,媲美全参微调
Thinking Machines曝LoRA终极指南:10倍学习率,媲美全参微调LoRA能否与全参微调性能相当?在Thinking Machines的最新论文中,他们研究了LoRA与FullFT达到相近表现的条件。Thinking Machines关注LoRA,旨在推动其更广泛地应用于各种按需定制的场景,同时也有助于我们更深入审视机器学习中的一些基本问题。
搜索
LoRA能否与全参微调性能相当?在Thinking Machines的最新论文中,他们研究了LoRA与FullFT达到相近表现的条件。Thinking Machines关注LoRA,旨在推动其更广泛地应用于各种按需定制的场景,同时也有助于我们更深入审视机器学习中的一些基本问题。
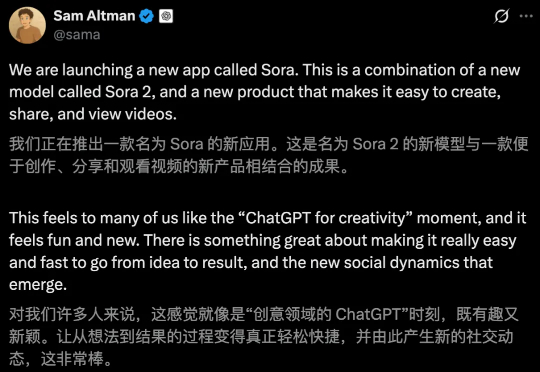
Sora 2,用OpenAI的原话描述就是:“With Sora 2, we are jumping straight to what we think may be the GPT‑3.5 moment for video。”AI视频的ChatGPT时刻,正式来了。
凌晨1点,OpenAI突然扔出Sora 2核弹,AI视频迎来「GPT-3.5时刻」!一大批惊艳Demo放出,物理智能提升一大截,首次实现音画同步,人物一致性、可控性刷新SOTA。但最绝的还是Sora App,它的问世,或将彻底重塑短视频社交媒体的交互逻辑与社区互动方式。
在今年 3 月 DeepSeek 和豆包占领国内产品月活用户增速前两名的时候,以第三姿态紧随其后的,是红果短剧。两者之间这个巧合的「偶遇」,意外也不意外。反映的正是我们当下经历的最重要的技术与文化浪潮。
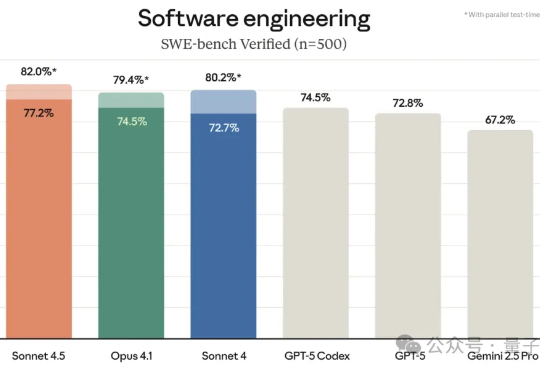
最强编程模型让位了。 但没有换人,依然是Claude。 新发布的Claude Sonnet 4.5,在SWE-bench上的成绩比Sonnet 4提升了1.8个百分点,而且提质不加价。
当全世界都在狂热追逐大模型时,强化学习之父、图灵奖得主Richard Sutton却直言:大语言模型是「死胡同」。在他看来,真正的智能必须源于经验学习,而不是模仿人类语言的「预测游戏」。这番话无异于当头一棒,让人重新思考:我们追逐的所谓智能,究竟是幻影,还是通向未来的歧路?
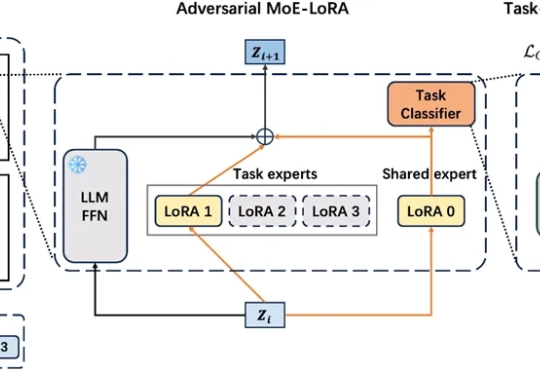
在工业级大语言模型(LLM)应用中,动态适配任务与保留既有能力的 “自进化” 需求日益迫切。真实场景中,不同领域语言模式差异显著,LLM 需在学习新场景合规规则的同时,不丢失旧场景的判断能力。这正是大模型自进化核心诉求,即 “自主优化跨任务知识整合,适应动态环境而无需大量外部干预”。
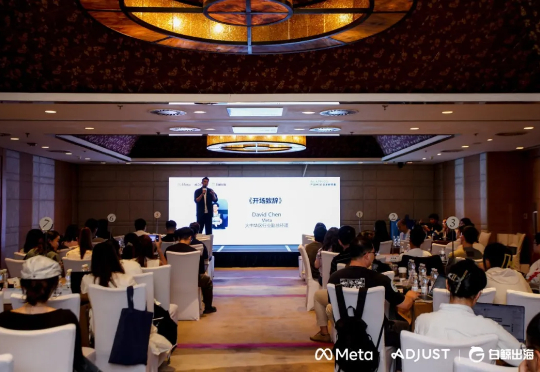
9 月 25 日,白鲸出海携手 Meta、Adjust 特别策划的鲸英会第三十三期 ——「AI+APP=∞」产品 Mix 迸发新惊喜如期在北京举行。来自 Meta 及其国内代理、Adjust 等众多出海行业和政策专家,以及 40 多位中国头部 AI 创企 CXO
正当大家都在预测牌桌上的其他巨头何时出手时,行业领头羊 OpenAI 的「王炸」似乎已经提前被剧透了,那就是 Sora 2。最近,OpenAI 不仅在 X 平台连发多条神秘视频,引爆社区对 Sora 2 的猜想。
Alex 是一家开发 AI 招聘官的初创公司,该公司表示其技术已帮助企业进行视频面试和电话初筛。约18 个月前联合创办 Alex 的王亚伦(图中下排居中)向 TechCrunch 透露,该公司的语音 AI 工具能在求职者投递简历后立即开展自主面试。"我们的 AI 招聘官每天进行数千场面试,帮助求职者进入全球顶尖企业工作,"他说道。