海量文本秒转结构化,试下谷歌的LangExtract,Github上12.3k star
海量文本秒转结构化,试下谷歌的LangExtract,Github上12.3k star真正的业务宝藏往往就埋藏在那些看似杂乱无章的文本数据之中,即非结构化文本,但问题是,如何高效、可靠地把这些宝藏精准地挖出来,一直是个令人头疼的难题,今天我们就来聊聊最近GitHub12.3k star爆火的Google 开源项目LangExtract,它为这个问题提供了一个相当漂亮的答案。
搜索
真正的业务宝藏往往就埋藏在那些看似杂乱无章的文本数据之中,即非结构化文本,但问题是,如何高效、可靠地把这些宝藏精准地挖出来,一直是个令人头疼的难题,今天我们就来聊聊最近GitHub12.3k star爆火的Google 开源项目LangExtract,它为这个问题提供了一个相当漂亮的答案。
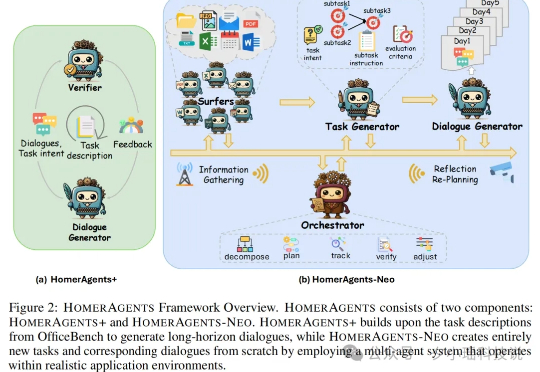
作为大家的测评博主,我最近发现一个巨有意思的现象: 现在市面上大部分评估 Agent 的基准测试,倾向于考核“单项技能”,而非“综合任务”。比如,你让 AI 点份外卖,它能完成;但如果要求它策划一场涵盖预算、选址、菜单、宾客邀请与流程安排的晚宴,它很可能就原地就 G 了。
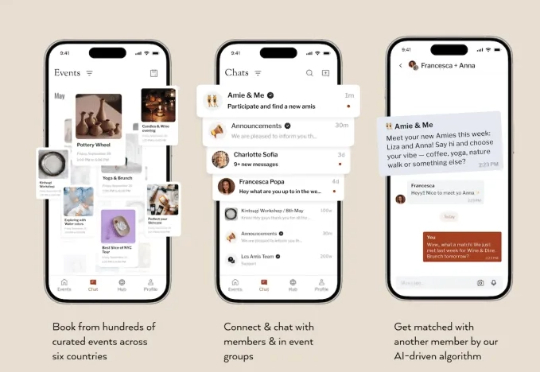
成年后结交朋友可能很困难,尤其是搬到新城市后。幸运的是,现代科技提供了解决方案,越来越多人开始使用Bumble For Friends、Flox 和 Timeleft 等应用快速建立新友谊。
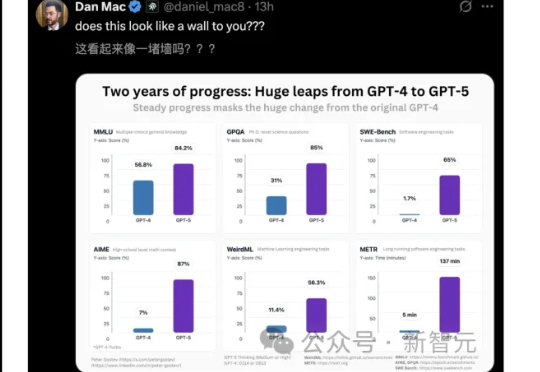
GPT-5发布半月,却被连连吐槽。如今,一张基准与GPT-4对比基准测试图,证明了Scaling Law没有撞墙。七年间,从GPT-1到GPT-5十四个花式Prompt对决,实力差一目了然。
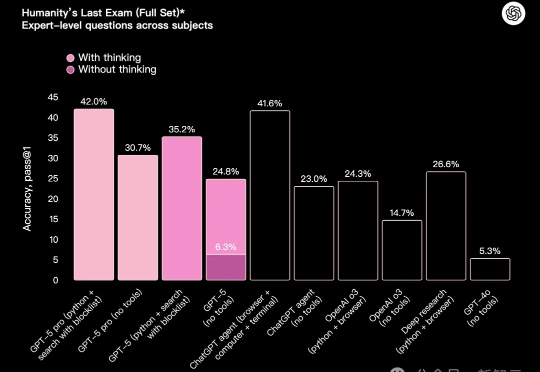
奥特曼称GPT-5「比人聪明」,但OpenAI首席运营官Lightcap澄清:这不是AGI。这只是能力过剩的冰山一角——我们仍有十年产品可建,模型越智能,融合越要精妙。GPT-5标志着从纯智商到反思能力的全面跃进。
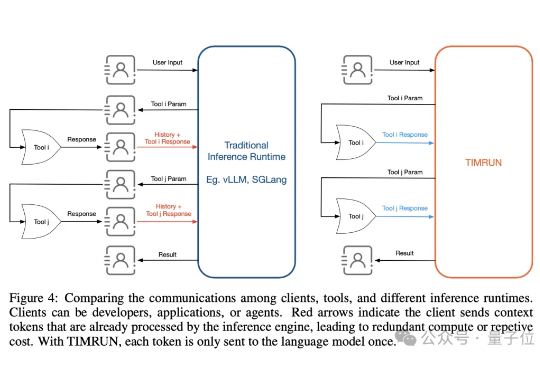
大模型的记忆墙,被MIT撬开了一道口子。 MIT等机构最新提出了一种新架构,让推理大模型的思考长度突破物理限制,理论上可以无限延伸。 这个新架构名叫Thread Inference Model,简称TIM。
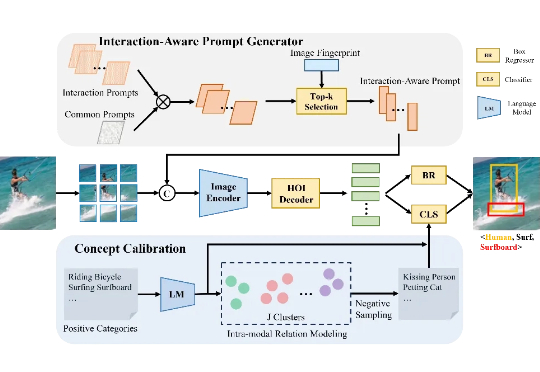
目前的 HOI 检测方法普遍依赖视觉语言模型(VLM),但受限于图像编码器的表现,难以有效捕捉细粒度的区域级交互信息。本文介绍了一种全新的开集人类-物体交互(HOI)检测方法——交互感知提示与概念校准(INP-CC)。
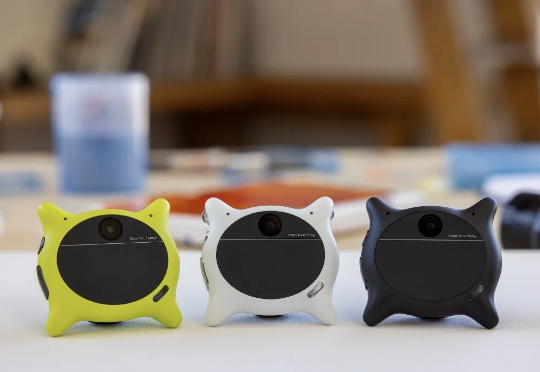
全球首款多模态 AI 硬件 Looki L1 发布,抢先实现了 OpenAI 想象中的交互未来。过去两年,很多人对 AI 的印象,基本都停留在一个对话框里: 有问题,敲几个字,它就给答案。好用是好用,但也让人觉得有点单调——AI 难道就只能困在对话框里吗?
没等到Deepseek R2,DeepSeek悄悄更新了V 3.1。官方群放出的消息就提了一点,上下文长度拓展至128K。128K也是GPT-4o这一代模型的处理Token的长度。因此一开始,鲸哥以为从V3升级到V 3.1,以为是不大的升级,鲸哥体验下来还有惊喜。
情感语音交互模型初创公司宇生月伴近日完成新一轮融资,由靖亚资本和小苗朗程领投,菡源资产(上海交大母基金)跟投,心流资本FlowCapital担任长期财务顾问。本轮融资将用于语音模型的持续优化、产品矩阵拓展及国际化商业落地。作为国内首家聚焦“情感语音交互”的模型公司,宇生月伴正重新定义AI时代的语音交互范式。