喝点VC|No Priors投资复盘:未来两三年仍会诞生千亿美元公司,但要成为数万亿美元公司就相当困难
喝点VC|No Priors投资复盘:未来两三年仍会诞生千亿美元公司,但要成为数万亿美元公司就相当困难当算力真正成为稀缺资源时,人们会发现,在任何一个机构里,往往只有几十名研究者贡献了大约80%的成果。真正昂贵的不是研究者本人,而是与他配套的算力。因此,如果拥有一定的Token预算,你要把它分配给谁,为什么。
搜索
当算力真正成为稀缺资源时,人们会发现,在任何一个机构里,往往只有几十名研究者贡献了大约80%的成果。真正昂贵的不是研究者本人,而是与他配套的算力。因此,如果拥有一定的Token预算,你要把它分配给谁,为什么。
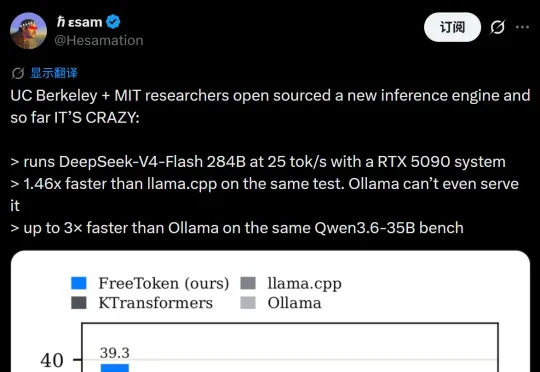
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
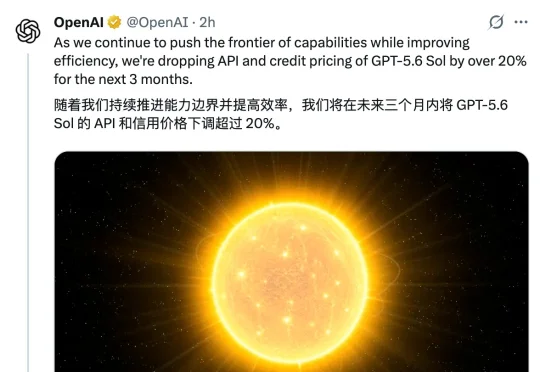
突发,GPT-5.6 Sol 开启大幅降价!未来三个月,API 价格和 credit 价格(超出计划包含额度后的按需付费用量)一起砍掉超过20%。目前,API 端已经即时生效,符合条件的 ChatGPT Work 和 Codex credits 正在陆续推送。
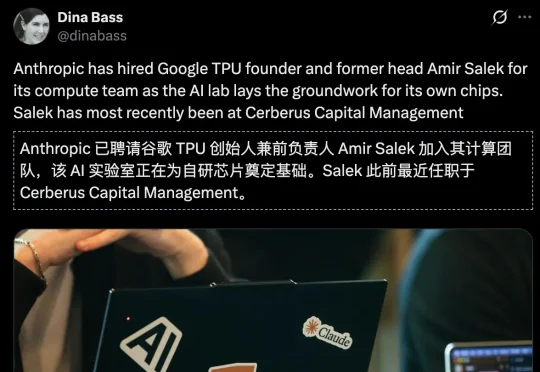
今天一大早,AI圈被这个消息刷屏了。外媒曝出猛料:Anthropic成功挖角前谷歌高管、大名鼎鼎的「TPU之父」Amir Salek!看来,Anthropic要自己造芯片了。此前,Anthropic就从OpenAI那里挖来了自研芯片骨干。
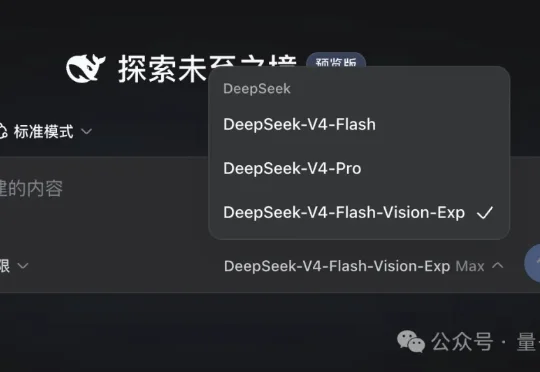
等了四个月,DeepSeek的多模态模型:deepseek-v4-flash-vision-exp,终于发布。我也是第一时间赶到现场,连夜开始实测。相比V4 Flash最大的不同,就是支持原生支持图片输入了,但图片生成当然还是没有的。
这期节目的嘉宾黄东旭,就是Token Maxing热潮的亲历者。他曾经只用最前沿的模型,每天账单三四百美元。让他转变的,是前沿模型的智力碾压和中国开源模型们的崛起——Fable 5可以一句话终结Agent群的讨论,同时大量的日常任务可以做到“只烧电费,不烧Token”。他的结论是:不是前沿模型用不起,而是本地开源模型底座+前沿模型的搭配,成本可控,更具性价比。
Anthropic开学校了,所有课程免费。而且是新员工入职教什么,这里就教什么。起因他们发现,每个月有数百万人访问Anthropic官网,想知道AI到底该怎么用。但除了有技术背景才能看懂的文档,也找不到什么特别有体系的教学。
商汤科技这次正式开源的SenseNova U1.5 Lite,其亮点如下:而且啊,SenseNova U1.5 Lite依旧保持了8B的大小,还能在复杂排版与精准编辑等核心的场景上比肩闭源的GPT-Image-2:
前两天发了个深度思考的Prompt,没想到大家反馈还挺好,然后也有人说,能不能把过去我写过以及一些最有用的Prompt整理个合集,再给大家分享一下。 然后我就翻了一下,才发现过去几年,确实已经零零散散
过去一年,很多品牌都在研究 GEO。 简单说,就是以前想办法让自己出现在 Google 搜索第一页,现在要想办法让 ChatGPT、Gemini 这些 AI 在回答问题时提到自己。但最近几个月,事情已经又往前走了一步。