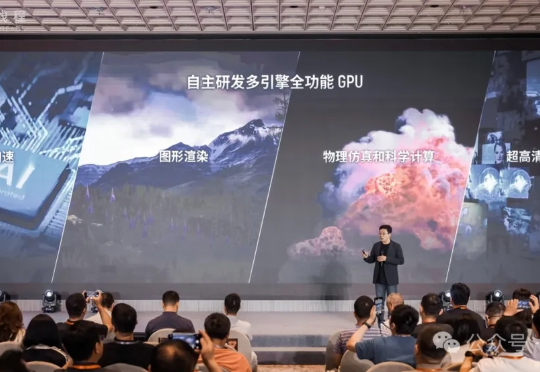
国产GPU跑满血DeepSeek,已经可以100 tokens/s了!
国产GPU跑满血DeepSeek,已经可以100 tokens/s了!放眼当下,到底哪个芯片跑满血DeepSeek是最快的? 答案很意外——不是你以为的英伟达,而是一家国产GPU。 因为现在它的速度,已经直接来到了100 tokens/s!
来自主题: AI资讯
8577 点击 2025-07-27 14:04

 搜索
放眼当下,到底哪个芯片跑满血DeepSeek是最快的? 答案很意外——不是你以为的英伟达,而是一家国产GPU。 因为现在它的速度,已经直接来到了100 tokens/s!
庸笔下的乔峰,在聚贤庄单挑群雄时,用一套人人会使的「太祖长拳」,打出了震慑全场的必杀效果。这门功夫看似平平无奇,却因使用者内力深厚、大巧不工,而威力无穷。
在大语言模型席卷全球的时代,坚持更接近生命本质的智能是少有人走的路。2025年7月初,一篇来自Numenta与Thousand Brains Project的论文,首次通过一个名为“Monty”的AI系统,实验性地验证了神经科学家杰夫·霍金斯(Jeff Hawkins)提出的“千脑智能理论”。
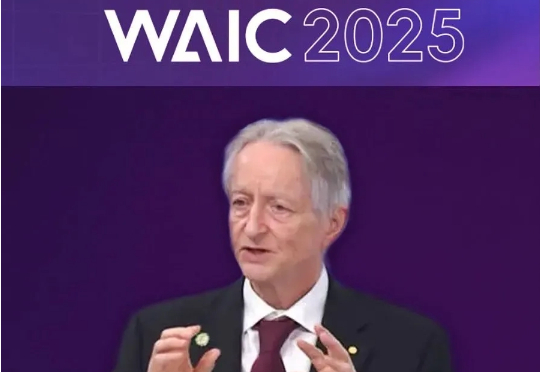
在首次中国演讲中,AI教父Hinton于WAIC2025上探讨数字智能与生物智能的差异,指出AI因具备永生与高效共享而快速超越人脑。他警示若无全球安全协作,超级智能或将反噬人类。Hinton提出通过AI安全研究所联盟与技术栈分离,推动AI向善发展。
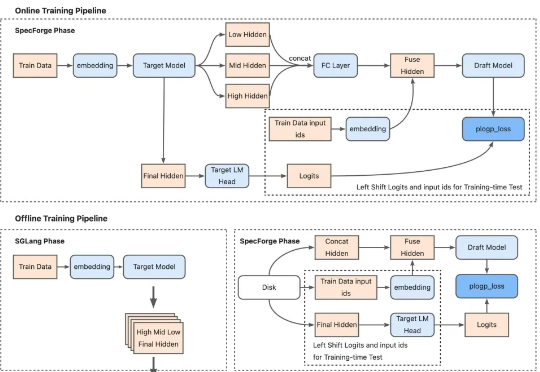
专门适用超大模型、带来2.18倍推理加速,最新投机采样训练框架开源! SGLang团队联合美团搜推平台、Cloudsway.AI开源SpecForge。
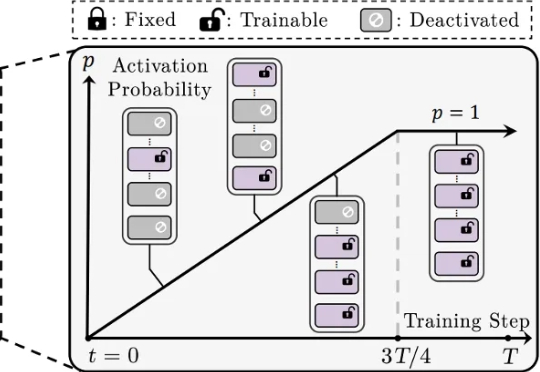
还在为 LoRA 训练不稳定、模型融合效果差、剪枝后性能大降而烦恼吗?来自香港城市大学、南方科技大学、浙江大学等机构的研究者们提出了一种简单的渐进式训练策略,CoTo,通过在训练早期随机失活一部分适配器,并逐渐提高其激活概率,有效缓解了层级不均衡问题,并显著增强了模型在多任务融合和剪枝等操作上的鲁棒性和有效性。该工作已被机器学习顶会 ICML 2025 接收。
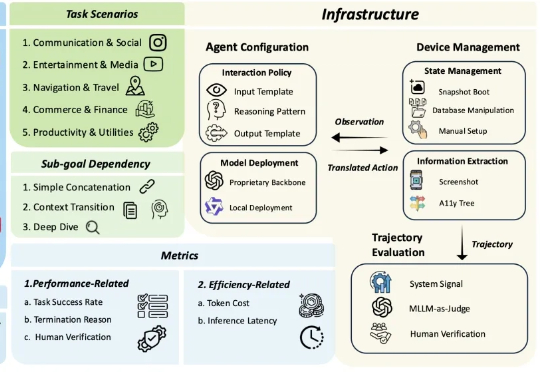
多模态大模型 (MLLM) 驱动的 OS 智能体在单屏动作落实(如 ScreenSpot)、短链操作任务(如 AndroidControl)上展现出突出的表现,标志着端侧任务自动化的初步成熟。
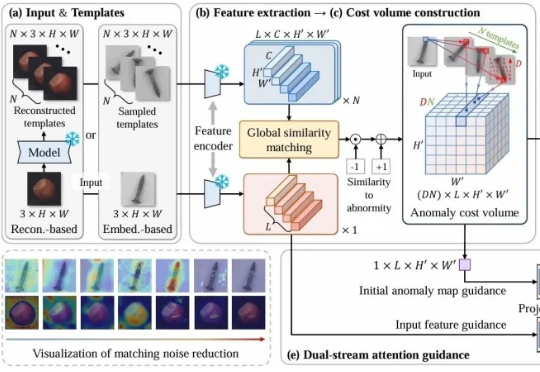
CostFilter-AD通过构建异常代价体并滤波来优化异常检测,能精准识别微小缺陷,无需缺陷样本训练。可作为通用插件提升现有检测系统,帮助工厂提前发现缺陷,提高产品质量。
当前最强大的大语言模型(LLM)虽然代码能力飞速发展,但在解决真实、复杂的机器学习工程(MLE)任务时,仍像是在进行一场“闭卷考试”。它们可以在单次尝试中生成代码,却无法模拟人类工程师那样,在反复的实验、调试、反馈和优化中寻找最优解的真实工作流。
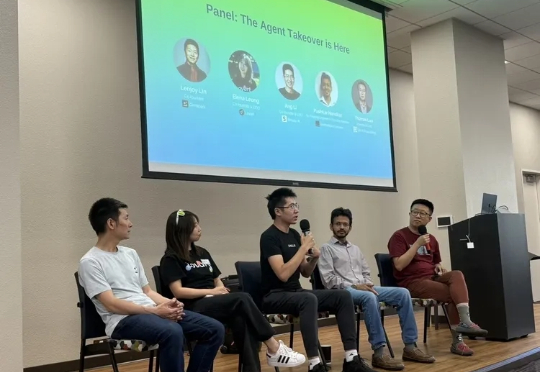
2025年7月17日,在GenAI Assembling 第五期硅谷Meetup上,最近火热的明星AI Agent 公司Genspark、Lovart、和Simular.ai的创始人,以及新一代基础设施公司SambaNova的Agent技术负责人,一起讨论了他们在今天AI Agent发展第一线所观察和感受到的一切。