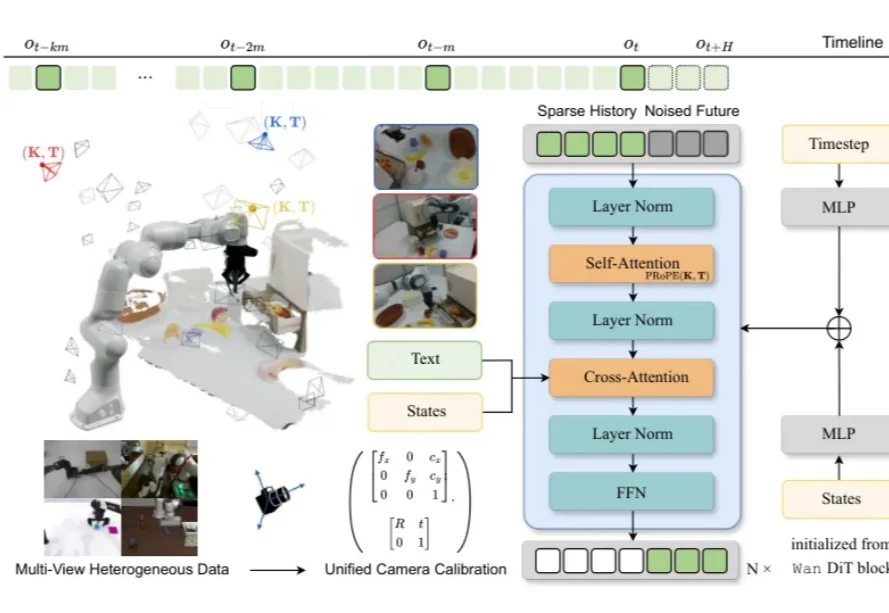
迈向Physical RSI第一步,具身智能系统RoboCoach如何高效主动纠错?
迈向Physical RSI第一步,具身智能系统RoboCoach如何高效主动纠错?RSI(Recursive Self-Improvement,递归自我改进)关注系统能否不断发现自身短板、获取新经验,并用新经验提升下一轮表现。然而,当前的具身系统仍高度依赖真机试错和人工决策。
来自主题: AI技术研报
8436 点击 2026-10-26 14:43

 搜索
RSI(Recursive Self-Improvement,递归自我改进)关注系统能否不断发现自身短板、获取新经验,并用新经验提升下一轮表现。然而,当前的具身系统仍高度依赖真机试错和人工决策。
机器人领域已经轰轰烈烈地 Scaling 了好几年。
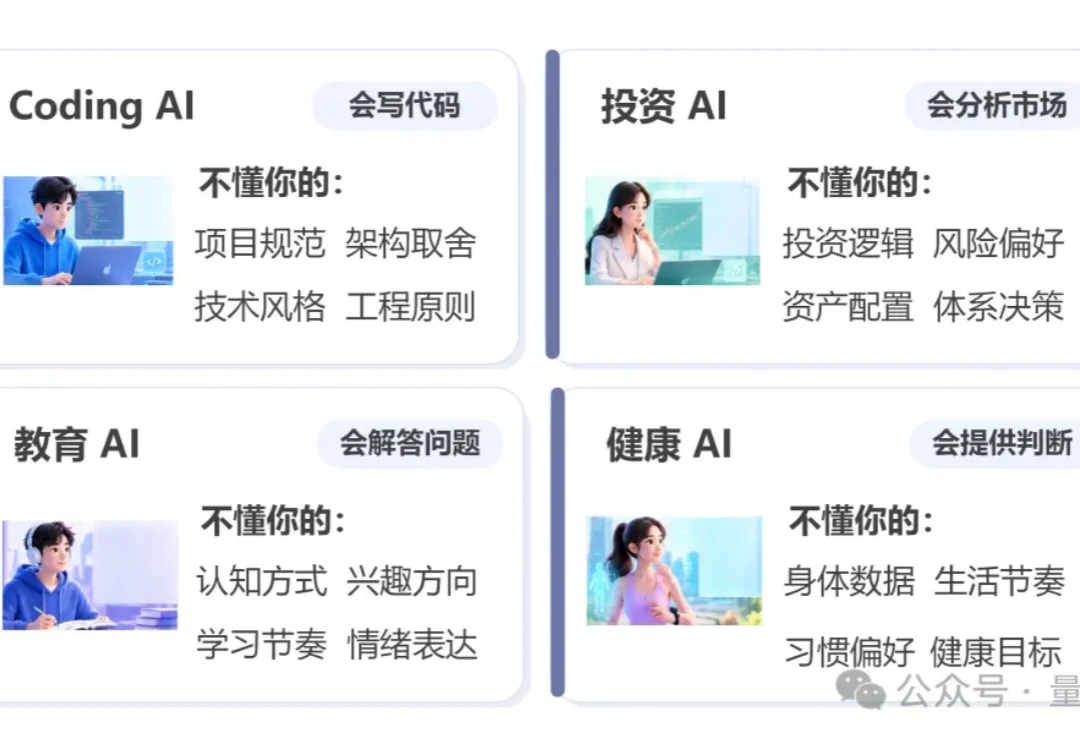
从通用模型到个性化智能,人工智能的竞争正在向长期学习与专属能力沉淀延伸。
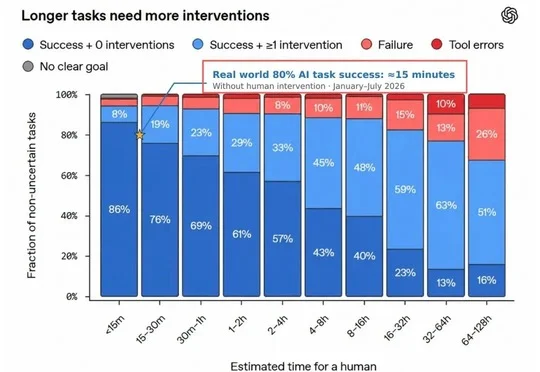
AI 确实在帮 AI 变强,但收益正逐轮递减。当前 AI 自我改进回路的实际强度,仅为触发“智能爆炸”所需理论阈值的 10% 到 20%;若要实现自我维持式的加速进化,这条回路必须再增强 5 到 10 倍。而在巨额过程损耗面前,眼下的系统连维持匀速进步都已十分吃力。
RSI(Recursive Self-Improvement,递归自我改进)最近成为了行业内关注的新热点。 简单说来,模型参与训练和提升模型自己,在业界已经开始成为一种惯例。Anthropic 在六月
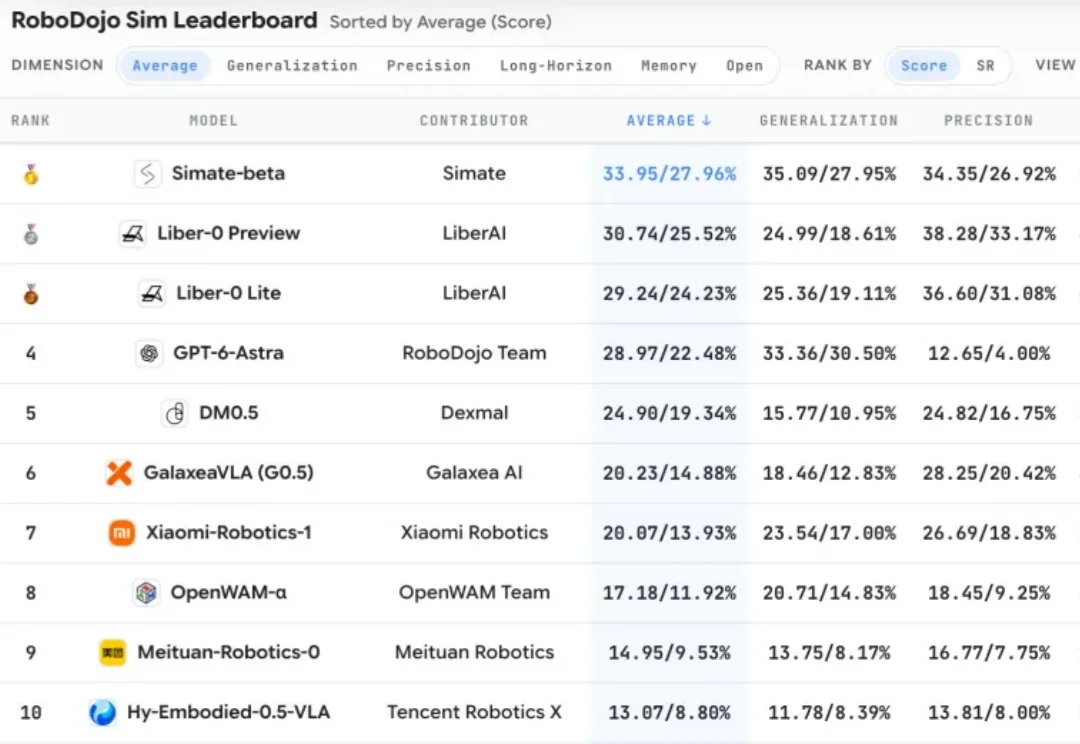
今年以来,RSI(Recursive Self-Improvement,递归自我改进)逐渐从硅谷前沿话题,演变为全球共识。
要论造词和包装概念,AI 圈要是自认第二,恐怕就没人敢称第一。
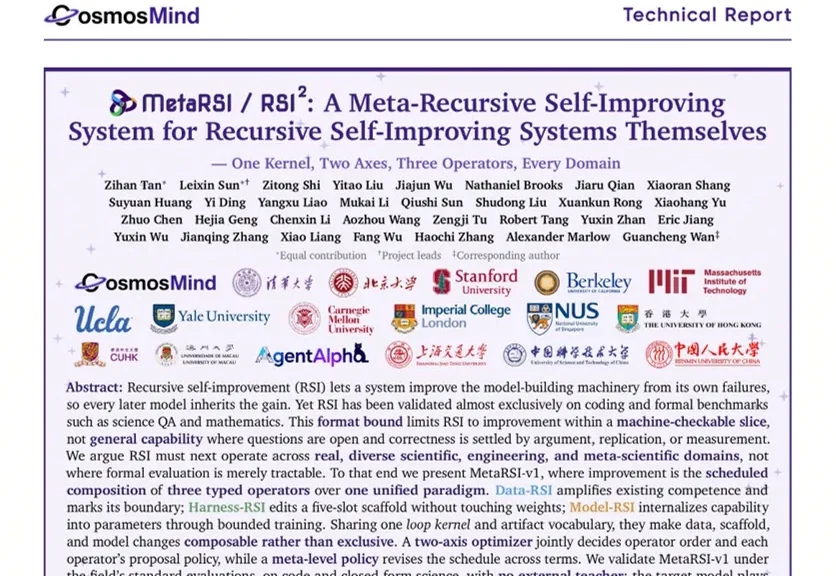
让模型自己生成训练数据、自己改写提示词、自己修复代码,这条路线被称为: 递归自我改进(Recursive Self-Improvement,RSI)。

第一篇AI4AI综述论文将long horizon智能体、AI4AI与recursive self-improvement纳入同一研究地图,指出AI能在明确目标与评价规则下承担部分研发工作,但单项能力提升无法证明完整流程可靠,持续自我改进仍面临组合鸿沟等验证挑战。
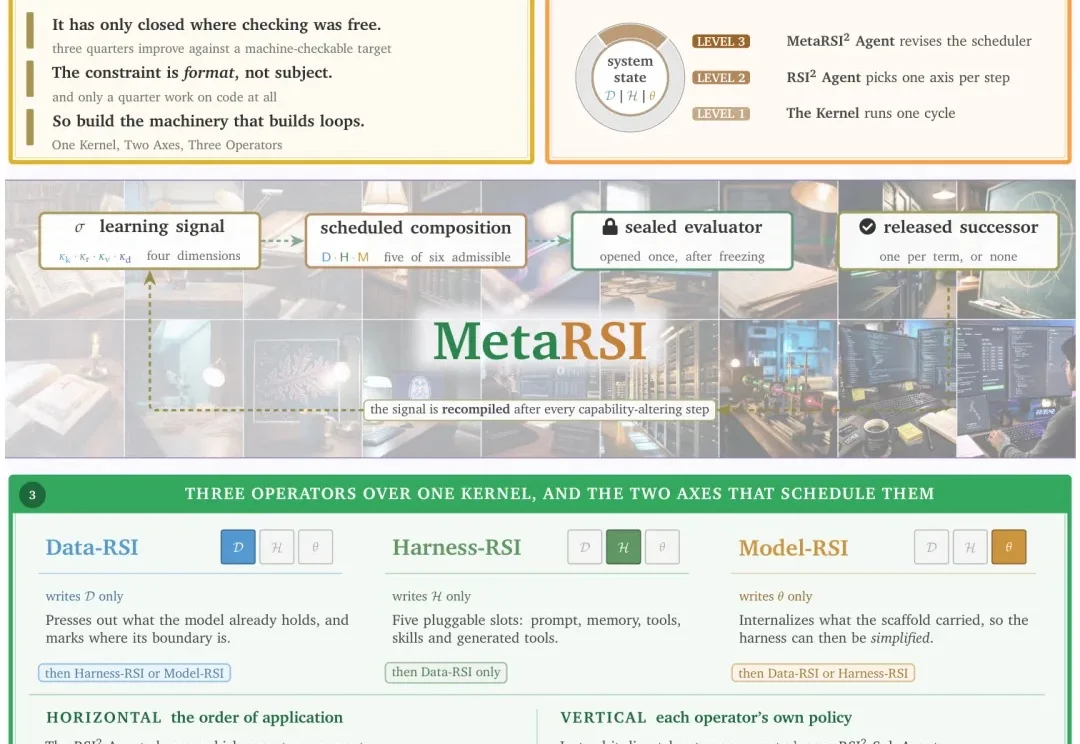
过去两年,AI 领域最激动人心的叙事之一,是让模型自己改进自己:自己生成训练数据、自己改写提示词、自己修复自己的代码。这条路线叫递归自我改进(Recursive Self-Improvement,RSI)。