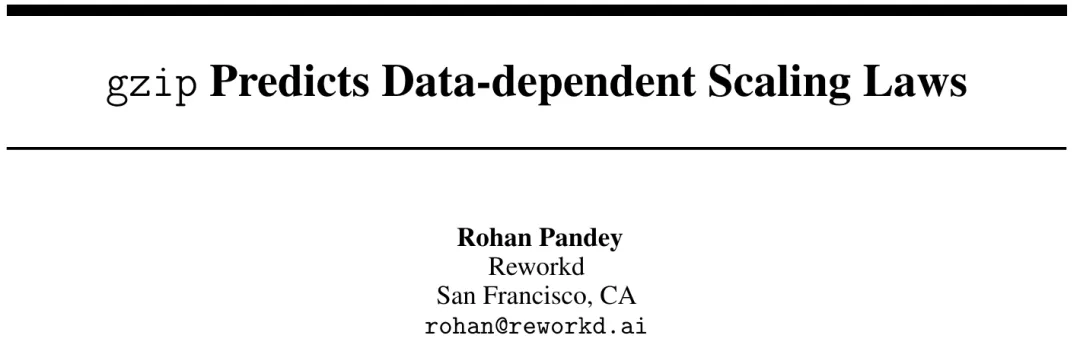
不同数据集有不同的Scaling law?而你可用一个压缩算法来预测它
不同数据集有不同的Scaling law?而你可用一个压缩算法来预测它一般而言,训练神经网络耗费的计算量越大,其性能就越好。在扩大计算规模时,必须要做个决定:是增多模型参数量还是提升数据集大小 —— 必须在固定的计算预算下权衡此两项因素。
来自主题: AI技术研报
8317 点击 2024-06-03 17:55

 搜索
一般而言,训练神经网络耗费的计算量越大,其性能就越好。在扩大计算规模时,必须要做个决定:是增多模型参数量还是提升数据集大小 —— 必须在固定的计算预算下权衡此两项因素。
清北爸爸李永乐都搞不定的事情,这个隐身的大模型在发起挑战

都在说大模型,都不会用大模型。

媒体与科技平台所谓的第三次大战里,OpenAI几乎已经不战而胜。
除了OpenAI自己,居然还有别人能用上GPT-4-Base版??
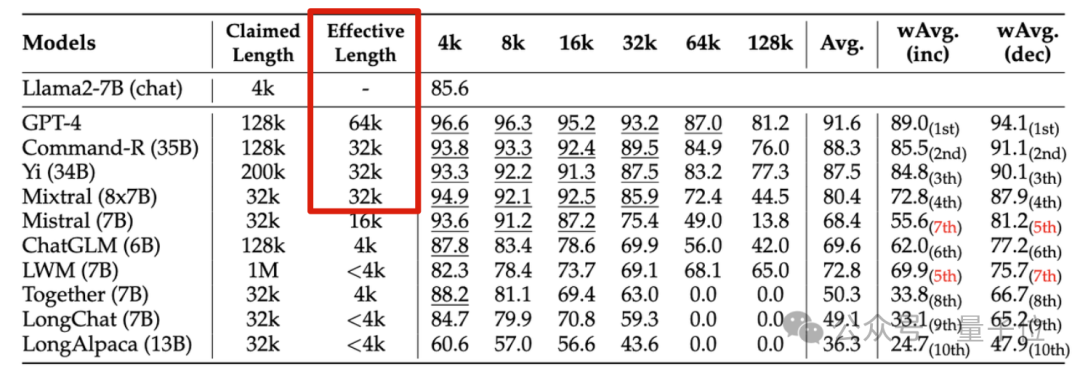
无情戳穿“长上下文”大模型的虚标现象
研究人员提出了一种新的大型语言模型训练方法,通过一次性预测多个未来tokens来提高样本效率和模型性能,在代码和自然语言生成任务上均表现出显著优势,且不会增加训练时间,推理速度还能提升至三倍。
在脑机接口领域取得突破性进展的公司不止Neuralink一家。Precision Neuroscience发布公告称,他们采用与Neuralink不同的技术路径,在人脑上成功放置了4096个电极,打破了去年2048个电极的最高纪录。
不卖模型卖算力
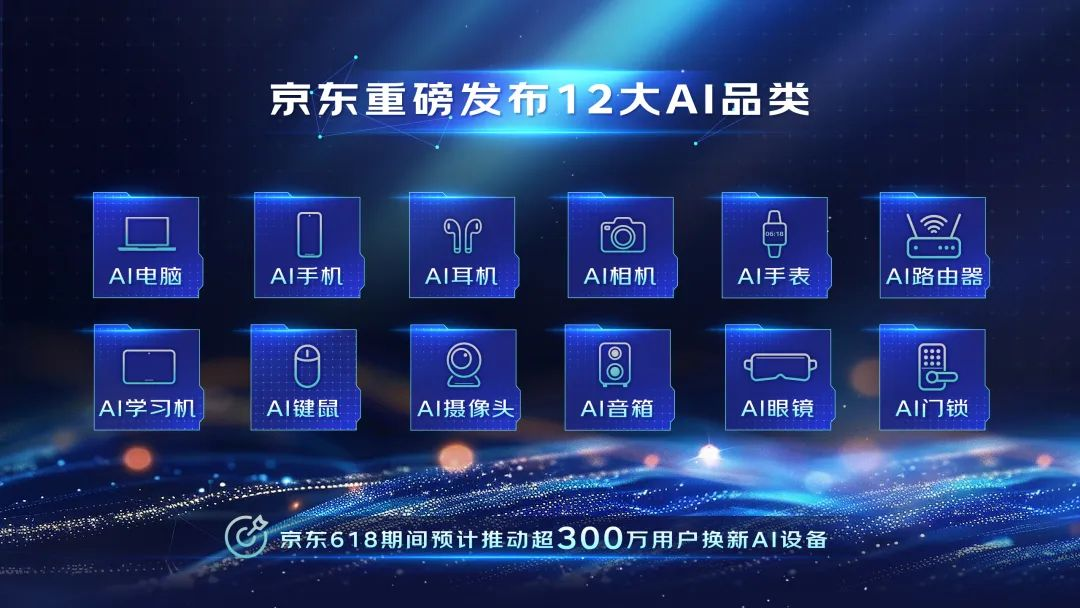
为了让更多用户先人一步体验AI,京东联合产业上下游企业乘胜追击,定下了618期间让300万人换新AI硬件的“小目标”。