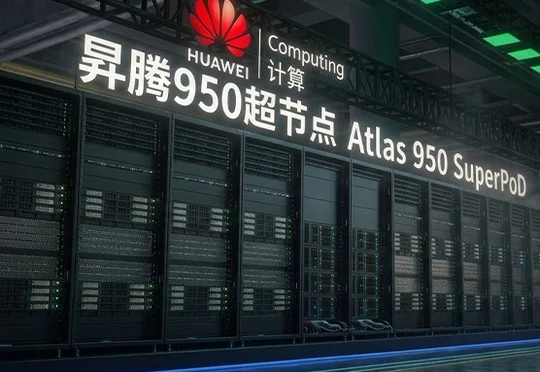
打破“算力存储通信”三堵墙,昇腾超节点给出十万亿大模型训推“最优解”
打破“算力存储通信”三堵墙,昇腾超节点给出十万亿大模型训推“最优解”华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
来自主题: AI资讯
9263 点击 2026-09-25 10:11

 搜索
华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
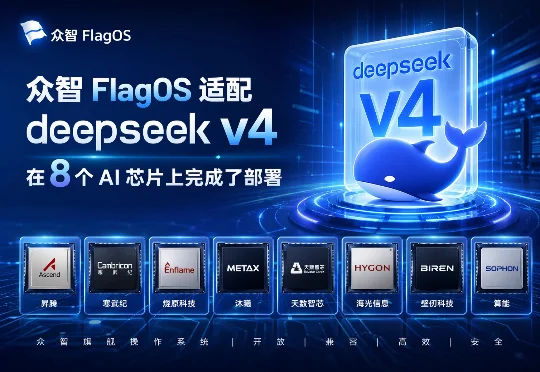
由智源研究院牵头研发的众智 FlagOS 第一时间对两个“巨无霸”模型进行全量适配,已经完成 DeepSeek-V4-Flash 在8款以上 AI 芯片上的全量适配与推理部署,包括海光、沐曦、华为昇腾、摩尔线程(FP8)、昆仑芯、平头哥真武、天数、英伟达(FP8)等芯片。FlagOS 同时正在推进 DeepSeek-V4-Pro 模型在多个芯片的迁移适配,晚些时间开源出来,敬请期待。
MiniMax M2.7 在今天正式开源。我们和华为昇腾、摩尔线程、沐曦、昆仑芯、NVIDIA,以及 Together AI、Fireworks、Ollama 等海内外芯片厂商、推理平台携手,在开源首日即完成模型接入与推理适配工作,推动全球 AI 生态繁荣发展。
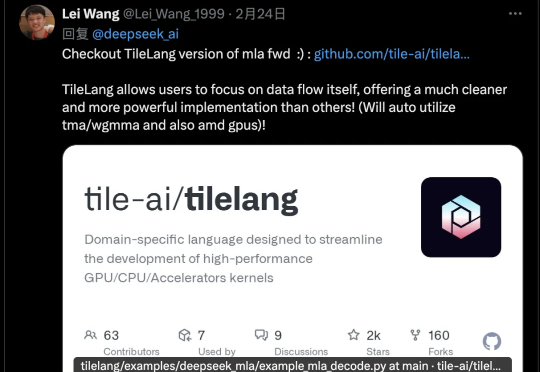
DeepSeek v3.2有一个新改动,在论文里完全没提,只在官方公告中出现一次,却引起墙裂关注。开源TileLang版本算子,其受关注程度甚至超过新稀疏注意力机制DSA,从画线转发的数量就可以看出来。
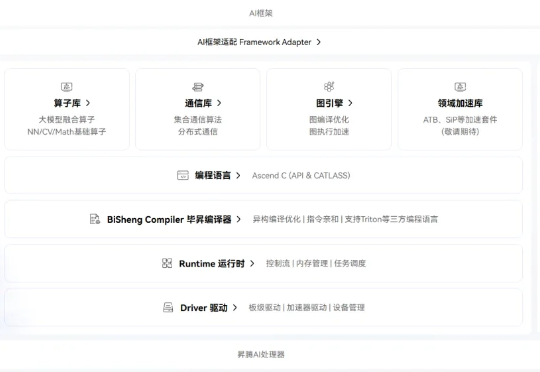
AI 行业很多人相信,我们正在或已经进入所谓的「AI 下半场」。在这一轮 AI 的浪潮中,硬件的竞争早已不再是单纯的算力比拼,而是一场围绕软件、开发者与生态的「护城河」之战。当国产 AI 生态的转型成为科技领域的时代呼声,华为昇腾及其异构计算架构 CANN 正站在了这场变革的聚光灯下。
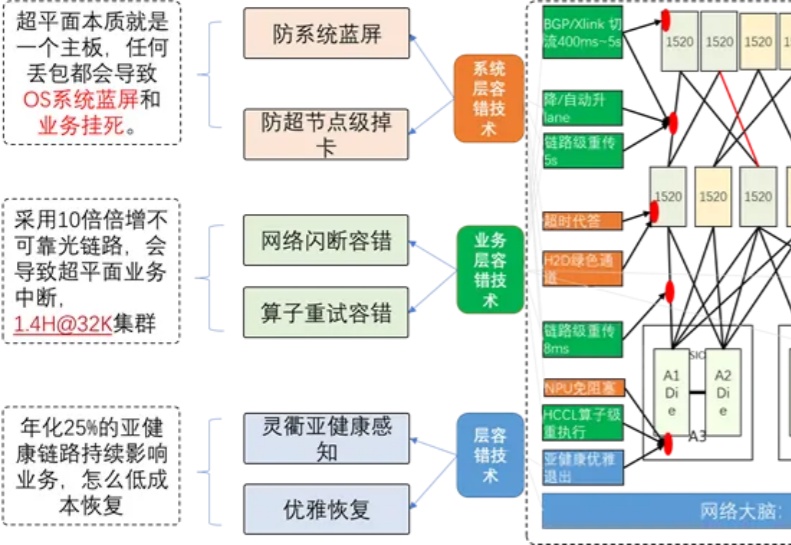
你是否注意到,现在的 AI 越来越 "聪明" 了?能写小说、做翻译、甚至帮医生看 CT 片,这些能力背后离不开一个默默工作的 "超级大脑工厂"——AI 算力集群。
部署超大规模MoE这件事,国产芯片的推理性能,已经再创新高了—— 不仅是“英伟达含量为0”这么简单,更是性能全面超越英伟达Hopper架构!
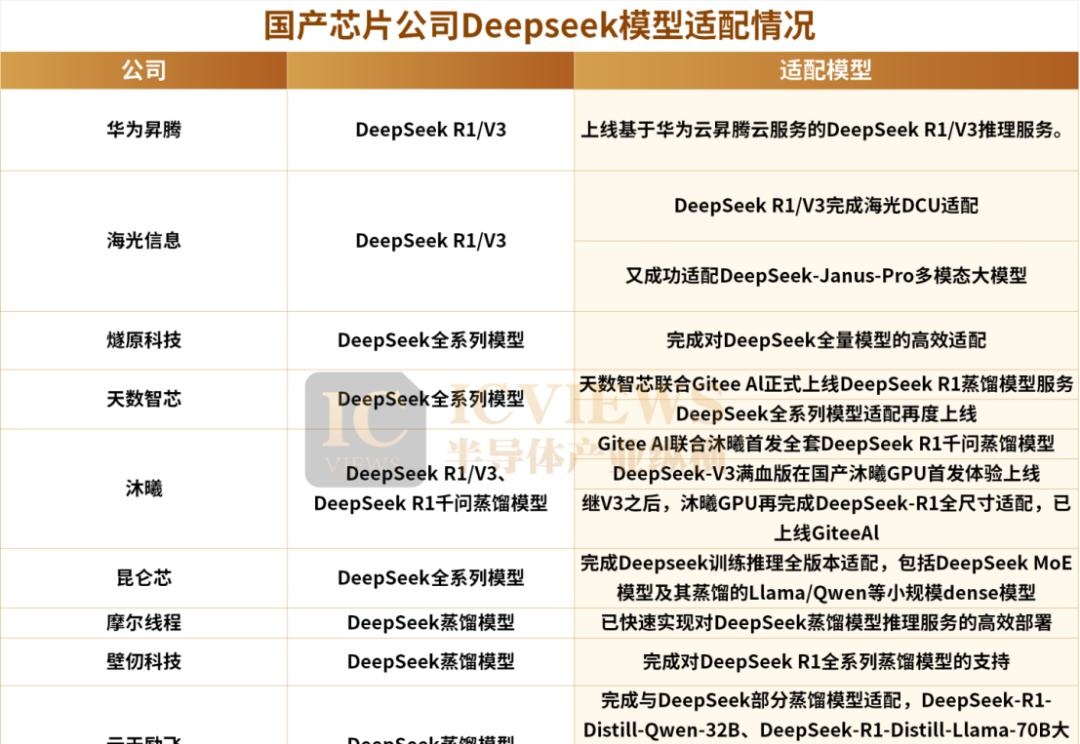
国产GPU适配DeepSeek,商用前景广阔。
DeepSeek掀起的算力热潮还在持续。中国电信昨日宣布推出了息壤智算一体机-DeepSeek版,在硬件层面以华为昇腾芯片为基础,提供8卡、16卡、32卡等多种规格型号。此前,京东云也发布DeepSeek大模型一体机,支持华为昇腾、海光、寒武纪、摩尔线程、天数智芯等国产AI加速芯片。《科创板日报》了解到,华鲲振宇也推出了DeepSeek大模型一体机方案。

DeepSeek-R1 系列模型的开源,因其出色的性能和低廉的开发成本,已引发全球的热切讨论和关注。