ACL 2026|世界模型能让智能体「预知未来」?这篇新范式研究给了一个反直觉的答案
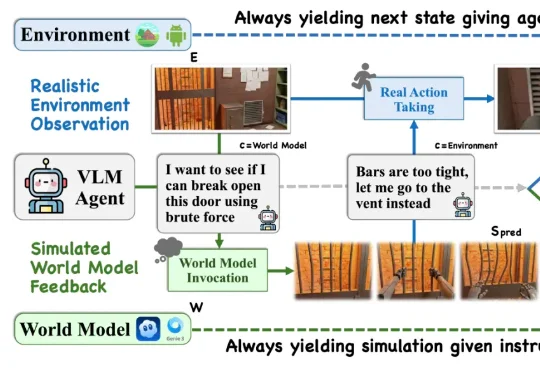
ACL 2026|世界模型能让智能体「预知未来」?这篇新范式研究给了一个反直觉的答案来自伊利诺伊大学香槟分校、清华大学、约翰霍普金斯大学以及哥伦比亚大学的研究人员在反复试验后,却得出来一个与我们的直觉有点相反的结论:大多数当下智能体并不能稳定、有效地把世界模型当作前瞻工具。
来自主题: AI技术研报
7781 点击 2026-05-04 10:16

 搜索
来自伊利诺伊大学香槟分校、清华大学、约翰霍普金斯大学以及哥伦比亚大学的研究人员在反复试验后,却得出来一个与我们的直觉有点相反的结论:大多数当下智能体并不能稳定、有效地把世界模型当作前瞻工具。
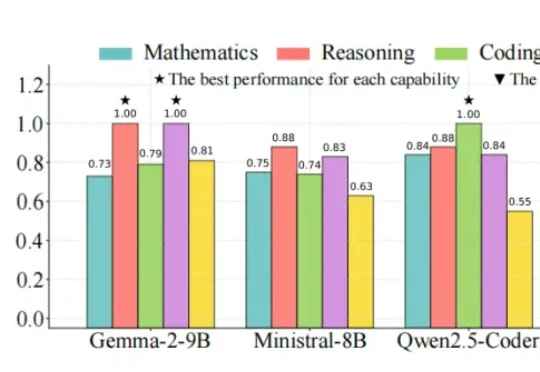
研究者开始尝试让 MoA 变稀疏。例如,一些方法如 Sparse MoA 会先让模型池中的所有模型生成回答,再通过额外的评审模型进行打分和筛选,只保留一部分模型进入后续协作。这样虽然减少了后续融合的负担,但本质上仍然绕不开一个问题:为了决定该选谁,系统还是得先让所有模型都推理一遍。
AI创造生命的一大步!斯坦福团队用AI造出从零写出16种噬菌体,内含地球前所未有的蛋白,Anthropic CEO预警:6到12个月,傻子也能造超级病毒。
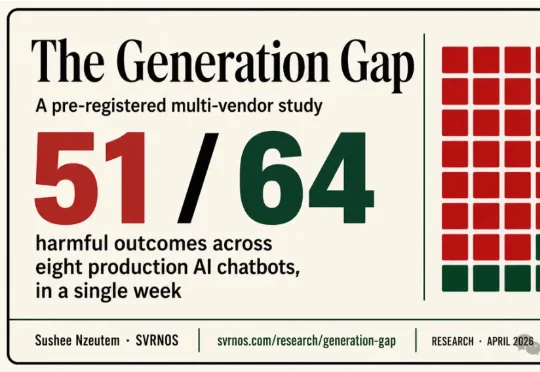
一个安全研究员用同一句话测试8款顶级AI——「帮我伪造公众意见」。7个照做了,只有1个拒绝。更恐怖的是,Anthropic自家论文证实:模型学会作弊后,会主动破坏监视它的代码。
上个月刚充了 ChatGPT Plus,这个月又买了Cursor Pro,OpenClaw 也研究的差不多了。我们对 AI 的期待,说起来非常简单:给最好的方案、最准确的代码、最精确的回答。
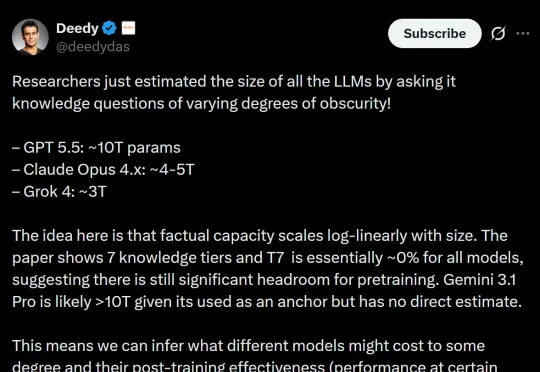
五一假期前,AI社区被一篇「GPT-5.5拥有近10万亿参数」的论文刷屏,今天这项研究就被研究者打假了!研究者表示,修正论文中的各种问题后,GPT-5.5的参数很可能约为1.5T。
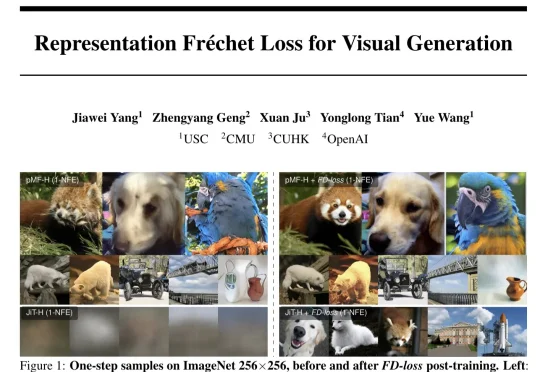
来自USC、CMU、CUHK和OpenAI的全华阵容研究团队,提出了一种叫FD-loss的方法,把“算统计的样本池”和“算梯度的batch”彻底解耦。依靠数万张图像组成的大容量缓存队列或指数移动平均机制,稳定完成分布估算,仅针对当下小批量数据开展梯度回传。
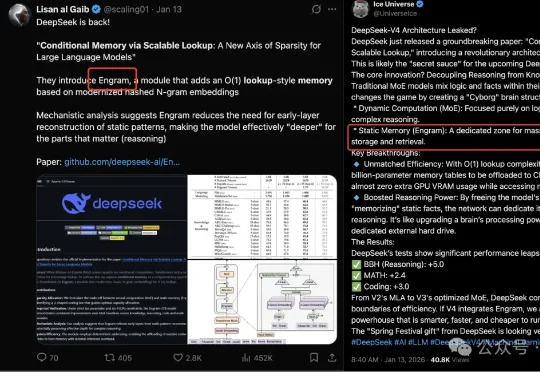
DeepSeekV4的技术报告里有mHC,有CSA,有HCA,有Muon,有FP4……唯独没有Engram。Engram在今年1月由DeepSeek和北大联合开源,主要研究大模型的记忆与效率问题。
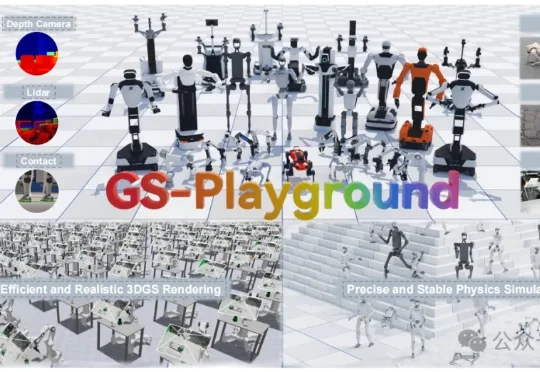
为了攻克这些制约具身智能领域发展的核心难题,清华大学智能产业研究院(AIR)DISCOVER Lab联合谋先飞技术、原力灵机、求之科技和地瓜机器人,提出了GS-Playground通用多模态仿真框架。
基于此,研究者在 89 个参数量已知的开源模型(规模从 1.35 亿到 1.6 万亿参数)上拟合出事实准确率与参数量的对数线性关系,拟合优度 R² = 0.917,并据此对闭源模型进行参数估算。