批量生成AI视频!Vidu接入飞书多维表格,工作流思路解析与模板分享
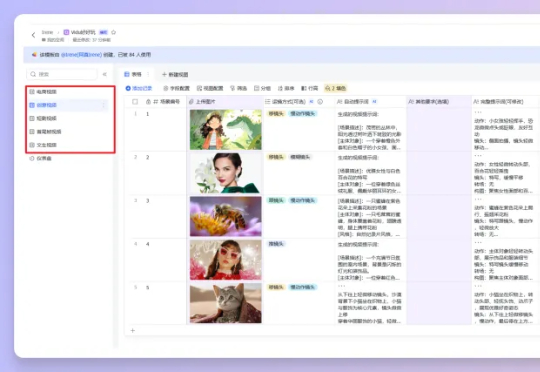
批量生成AI视频!Vidu接入飞书多维表格,工作流思路解析与模板分享这里介绍一下Vidu,Vidu是由生数科技联合清华大学正式发布的中国首个长时长、高一致性、高动态性视频大模型。Vidu在语义理解、推理速度、动态幅度等方面具备领先优势,并上线了全球首个“多主体参考”功能,突破视频模型一致性生成难题,开启了视觉上下文时代。最近上线了 Vidu Q1 的高质量视频大模型,不仅视频效果质感更高,而且性价比很不错。
搜索
这里介绍一下Vidu,Vidu是由生数科技联合清华大学正式发布的中国首个长时长、高一致性、高动态性视频大模型。Vidu在语义理解、推理速度、动态幅度等方面具备领先优势,并上线了全球首个“多主体参考”功能,突破视频模型一致性生成难题,开启了视觉上下文时代。最近上线了 Vidu Q1 的高质量视频大模型,不仅视频效果质感更高,而且性价比很不错。
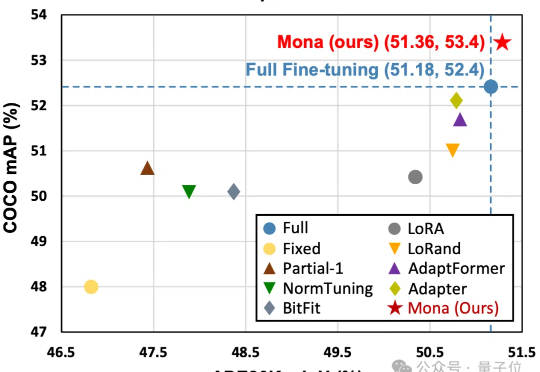
仅调整5%的骨干网络参数,就能超越全参数微调效果?!
算力砍半,视觉生成任务依然SOTA!
复旦大学和美团的研究者们提出了UniToken——一种创新的统一视觉编码方案,在一个框架内兼顾了图文理解与图像生成任务,并在多个权威评测中取得了领先的性能表现。
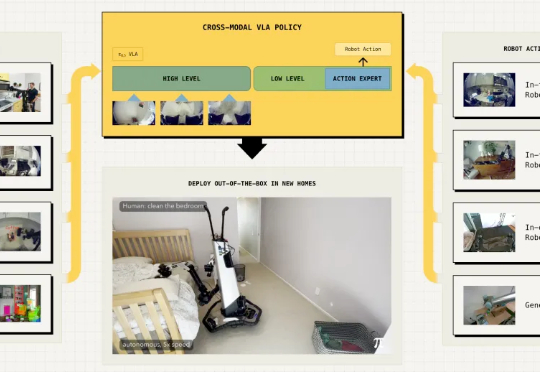
今天,美国具身智能公司 Physical Intelligence 推出了一个基于 π0 的视觉-语言-动作(VLA)模型 π0.5,其利用异构任务的协同训练来实现广泛的泛化,可以在全新的家中执行各种任务。
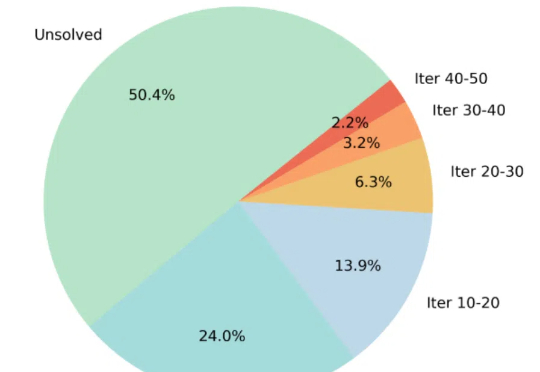
通过蒙特卡洛树搜索筛选高难度样本,ThinkLite-VL仅用少量数据就能显著提升视觉语言模型的推理能力,无需知识蒸馏,为高效训练提供了新思路。
最近也是好起来了,上周四去杭州参加了字节火山的线下meetup开发者大会。在会议现场亲自体验了他们这次新发布的大模型和产品,整个过程还挺有意思的。视觉模型Doubao-1.5-vision-pro也非常nice
o3和o4-mini视觉推理突破,竟未引用他人成果?一名华盛顿大学博士生发出质疑,OpenAI研究人员对此回应:不存在。
知道大模型接下来要卷视觉推理,但没想到这么卷——数学试卷都快要不够用了。
对于AI视觉多模态大模型只关注显著信息这一根本性缺陷,哈工大GiVE实现突破!