AI资讯新闻榜单内容搜索-视觉

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 视觉
Harmon:协调视觉表征,统一多模态理解和生成(模型已开源)

Harmon:协调视觉表征,统一多模态理解和生成(模型已开源)

Harmon:协调视觉表征,统一多模态理解和生成(模型已开源)

GPT-4o 生图功能的出现揭示了统一理解与生成模型的巨大潜力,然而如何在同一个框架内协调图像理解与生成这两种不同粒度的任务,是一个巨大的挑战。

来自主题: AI技术研报
10267 点击    2025-05-10 13:35
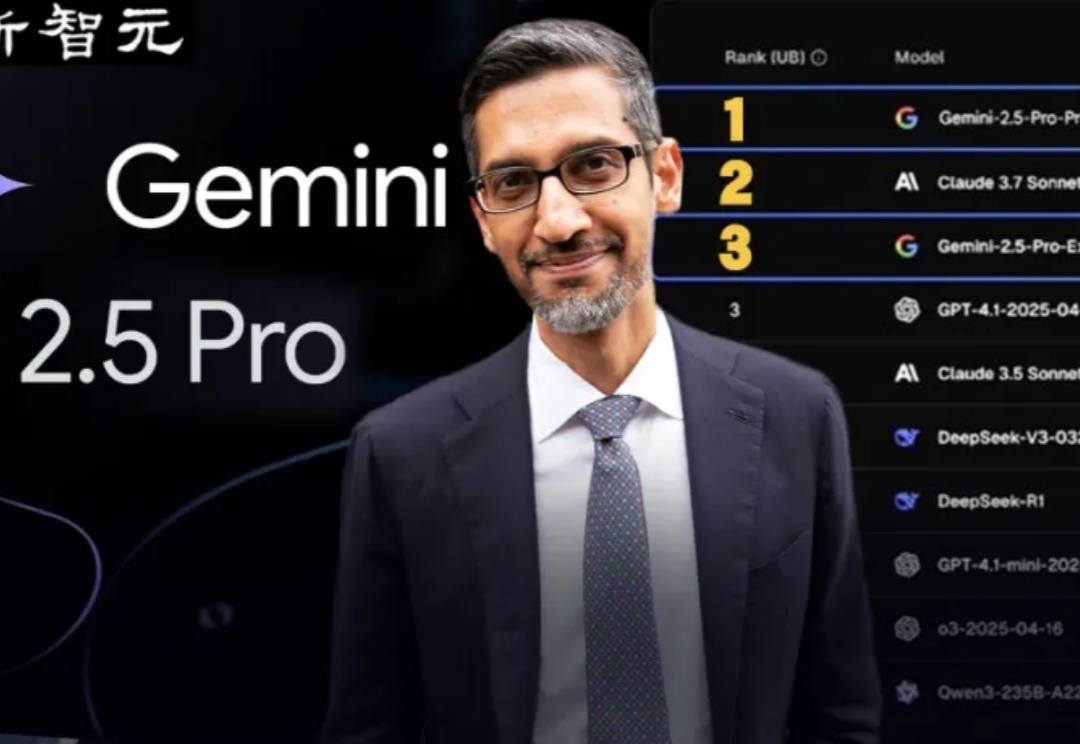
Gemini 2.5 Pro登顶三冠王!AI最强编程屠榜,全面碾压Claude 3.7

Gemini 2.5 Pro登顶三冠王!AI最强编程屠榜,全面碾压Claude 3.7

Gemini 2.5 Pro登顶三冠王!AI最强编程屠榜,全面碾压Claude 3.7

谷歌Gemini 2.5 Pro(I/O版)横空出世,强势登顶LMAreana,斩获文本、视觉、编码三连冠,甚至编程能力全面碾压Claude 3.7,地表最强编码模型诞生。

来自主题: AI资讯
9724 点击    2025-05-07 14:32
想去哪就去哪!FindAnything:基于CLIP的开放词汇三维建图,实现真正的“按需探索”

想去哪就去哪!FindAnything:基于CLIP的开放词汇三维建图,实现真正的“按需探索”

想去哪就去哪!FindAnything:基于CLIP的开放词汇三维建图,实现真正的“按需探索”

在复杂、未知的现实环境中,传统导航方法往往依赖闭集语义或事先构建的地图,难以实现真正的“按需探索”。为打破这一瓶颈,本文提出了 FindAnything ——一套融合视觉语言模型的对象为中心、开放词汇三维建图与探索系统。
来自主题: AI技术研报
8630 点击    2025-05-06 10:23
CVPR 2025 | CV 微调卷出天际,Mona:我小、我强、我省资源

CVPR 2025 | CV 微调卷出天际,Mona:我小、我强、我省资源

CVPR 2025 | CV 微调卷出天际,Mona:我小、我强、我省资源

Mona(Multi-cognitive Visual Adapter)是一种新型视觉适配器微调方法,旨在打破传统全参数微调(full fine-tuning)在视觉识别任务中的性能瓶颈。
来自主题: AI技术研报
10153 点击    2025-05-02 14:17
ICLR 2025|首个动态视觉-文本稀疏化框架来了,计算开销直降50%-75%

ICLR 2025|首个动态视觉-文本稀疏化框架来了,计算开销直降50%-75%

ICLR 2025|首个动态视觉-文本稀疏化框架来了,计算开销直降50%-75%

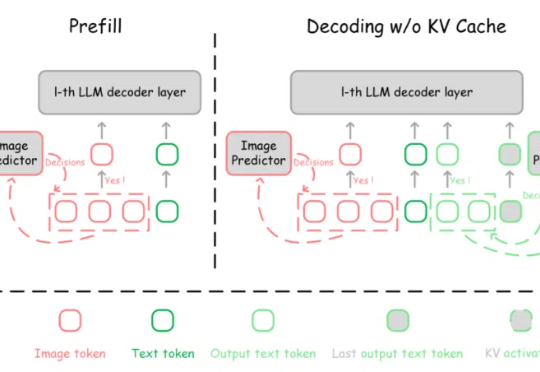
多模态大模型(MLLMs)在视觉理解与推理等领域取得了显著成就。然而,随着解码(decoding)阶段不断生成新的 token,推理过程的计算复杂度和 GPU 显存占用逐渐增加,这导致了多模态大模型推理效率的降低。
来自主题: AI技术研报
9124 点击    2025-04-29 14:56
7B超越GPT!1/20数据,无需知识蒸馏,马里兰等推出全新视觉推理方法

7B超越GPT!1/20数据,无需知识蒸馏,马里兰等推出全新视觉推理方法

7B超越GPT!1/20数据,无需知识蒸馏,马里兰等推出全新视觉推理方法

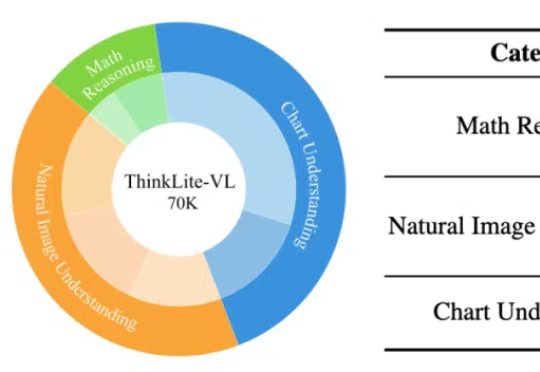
通过蒙特卡洛树搜索筛选高难度样本,ThinkLite-VL仅用少量数据就能显著提升视觉语言模型的推理能力,无需知识蒸馏,为高效训练提供了新思路。
来自主题: AI技术研报
11092 点击    2025-04-28 16:59
OpenAI没说的秘密,Meta全揭了?华人一作GPT-4o同款技术,爆打扩散王者

OpenAI没说的秘密,Meta全揭了?华人一作GPT-4o同款技术,爆打扩散王者

OpenAI没说的秘密,Meta全揭了?华人一作GPT-4o同款技术,爆打扩散王者

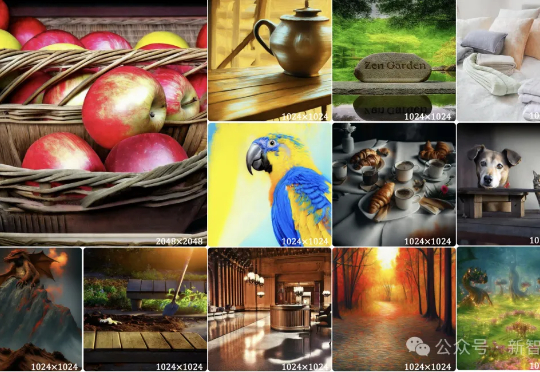
自回归模型,首次生成2048×2048分辨率图像!来自Meta、西北大学、新加坡国立大学等机构的研究人员,专门为多模态大语言模型(MLLMs)设计的TokenShuffle,显著减少了计算中的视觉Token数量,提升效率并支持高分辨率图像合成。
来自主题: AI技术研报
10666 点击    2025-04-28 09:16
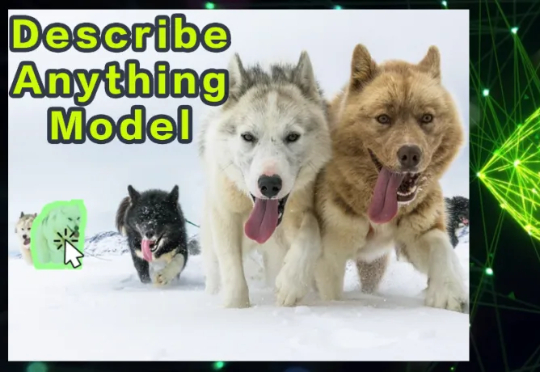
英伟达华人硬核AI神器,「描述一切」秒变细节狂魔!仅3B逆袭GPT-4o

英伟达华人硬核AI神器,「描述一切」秒变细节狂魔!仅3B逆袭GPT-4o

英伟达华人硬核AI神器,「描述一切」秒变细节狂魔!仅3B逆袭GPT-4o

视觉AI终极突破来了!英伟达等机构推出超强多模态模型DAM,仅3B参数,就能精准描述图像和视频中的任何细节。刚刚,英伟达联手UC伯克利、UCSF团队祭出首个神级多模态模型——Describe Anything Model(DAM),仅3B参数。

来自主题: AI资讯
12043 点击    2025-04-27 10:47