Unstructured.io:让企业非结构化数据 LLM-Ready
Unstructured.io:让企业非结构化数据 LLM-Ready企业要用好 LLM 离不开高质量数据。和传统机器学习模型相比,LLM 对于数据需求量更大、要求更高,尤其是非结构化数据。而传统 ETL 工具并不擅长非结构化数据的处理,因此,企业在部署 LLM 的过程中,数据科学家们往往要耗费大量的时间精力在数据处理环节。这一环节既关系到 LLM 部署的效率和质量,也对数据科学家人力的 ROI 产生影响。
搜索
企业要用好 LLM 离不开高质量数据。和传统机器学习模型相比,LLM 对于数据需求量更大、要求更高,尤其是非结构化数据。而传统 ETL 工具并不擅长非结构化数据的处理,因此,企业在部署 LLM 的过程中,数据科学家们往往要耗费大量的时间精力在数据处理环节。这一环节既关系到 LLM 部署的效率和质量,也对数据科学家人力的 ROI 产生影响。
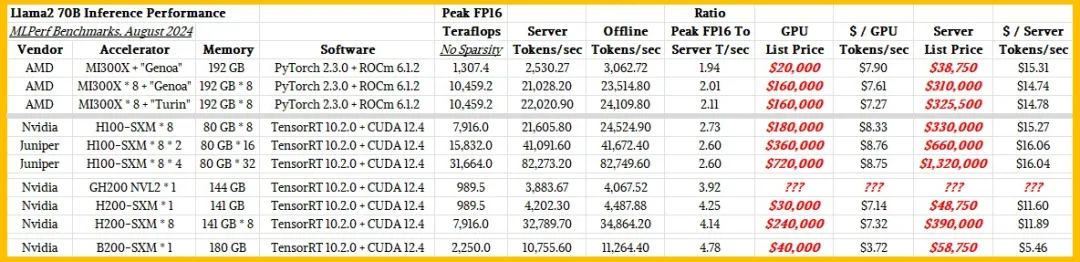
都很贵。
内含一键部署教程
之前介绍了很多在本地部署远程大模型以及本地大模型的教程,但是对于 AI 的使用尤其是如何让 AI 准确理解并执行下达的任务也是一个技术活,所以又诞生了 Prompt 提示词工程这个概念。
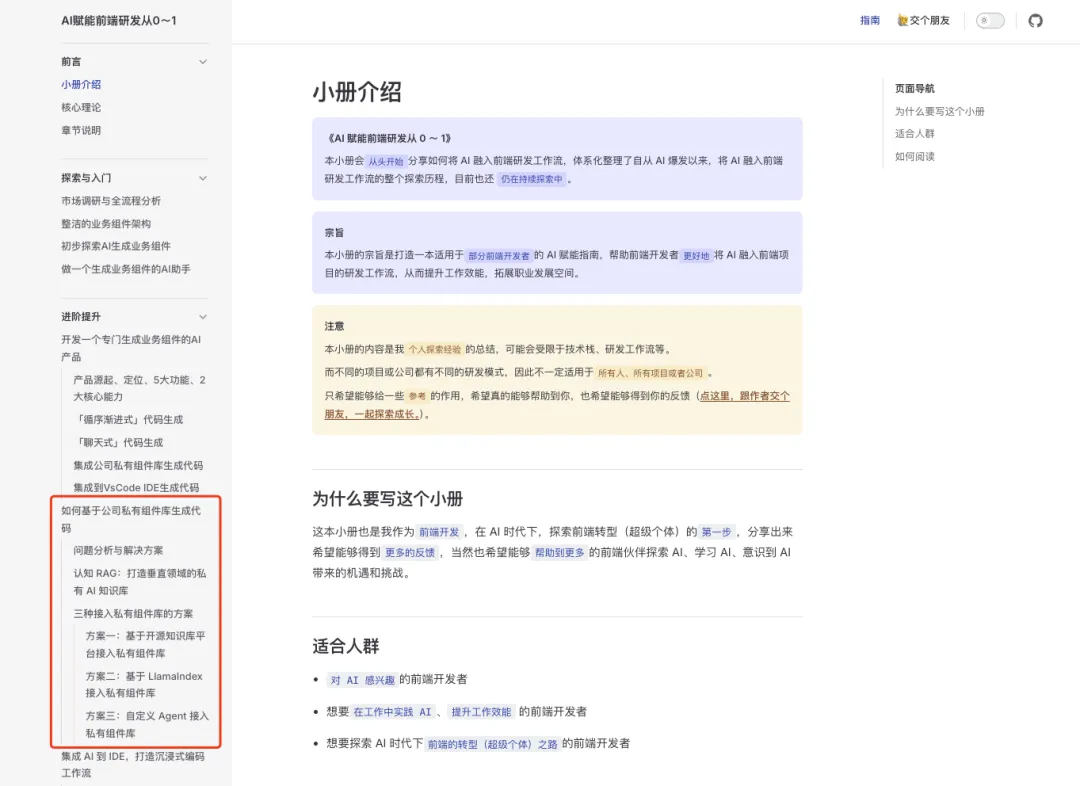
基于公司私有组件生成代码,这个问题的本质是:由于大模型的训练数据集不包含你公司的私有组件数据,因此不能够生成符合公司私有组件库的代码。
2024年,落地,无疑是大模型最重要的主题。
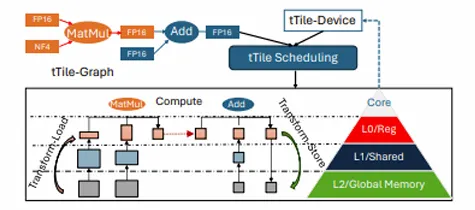
在人工智能领域,模型参数的增多往往意味着性能的提升。但随着模型规模的扩大,其对终端设备的算力与内存需求也日益增加。低比特量化技术,由于可以大幅降低存储和计算成本并提升推理效率,已成为实现大模型在资源受限设备上高效运行的关键技术之一。然而,如果硬件设备不支持低比特量化后的数据模式,那么低比特量化的优势将无法发挥。
无需硬件传感器或对现有网络环境进行重大改动即可轻松部署。
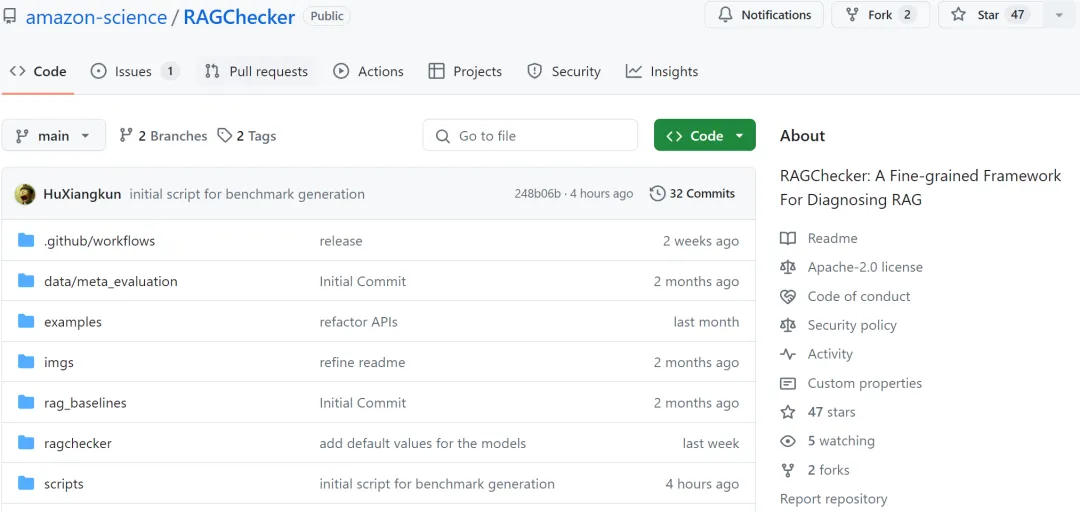
检索增强生成(Retrieval-Augmented Generation, RAG)技术正在彻底革新 AI 应用领域,通过将外部知识库和 LLM 内部知识的无缝整合,大幅提升了 AI 系统的准确性和可靠性。然而,随着 RAG 系统在各行各业的广泛部署,其评估和优化面临着重大挑战
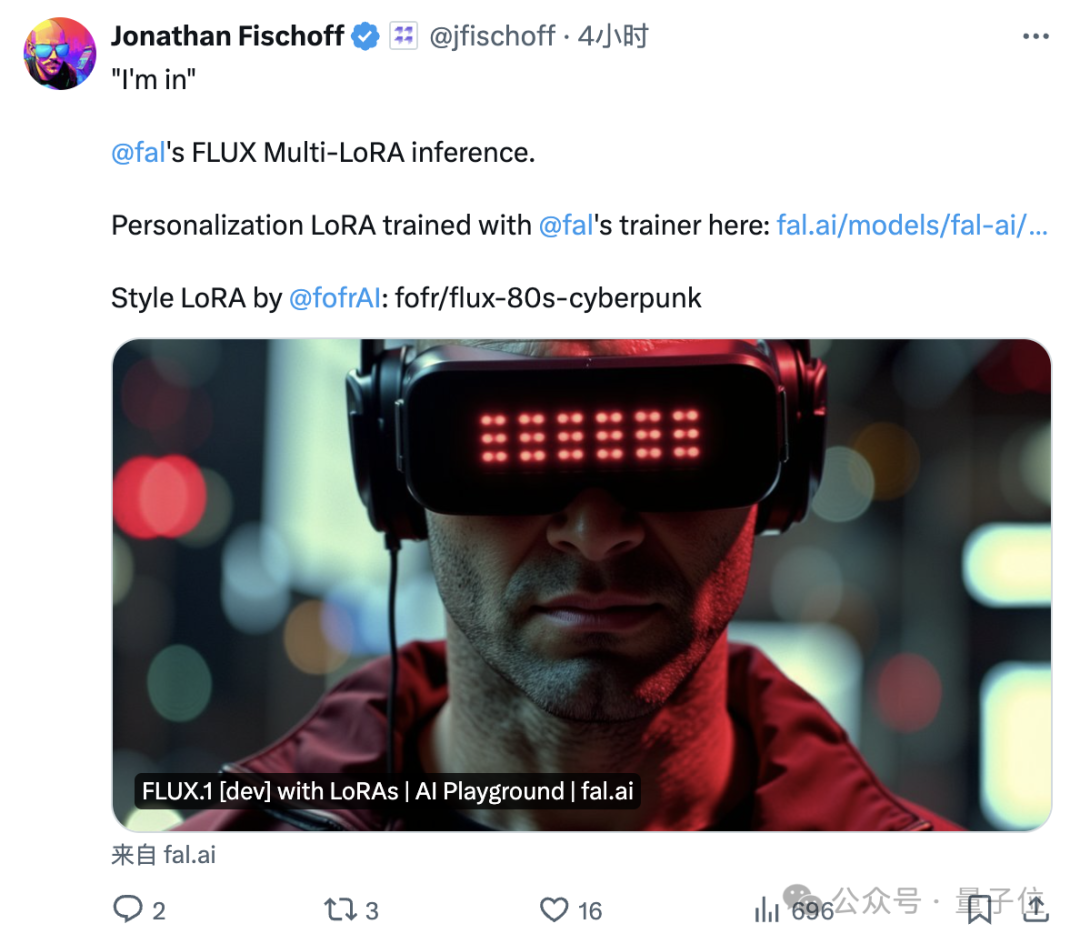
“FLUX在线版”,新增一系列重磅功能!