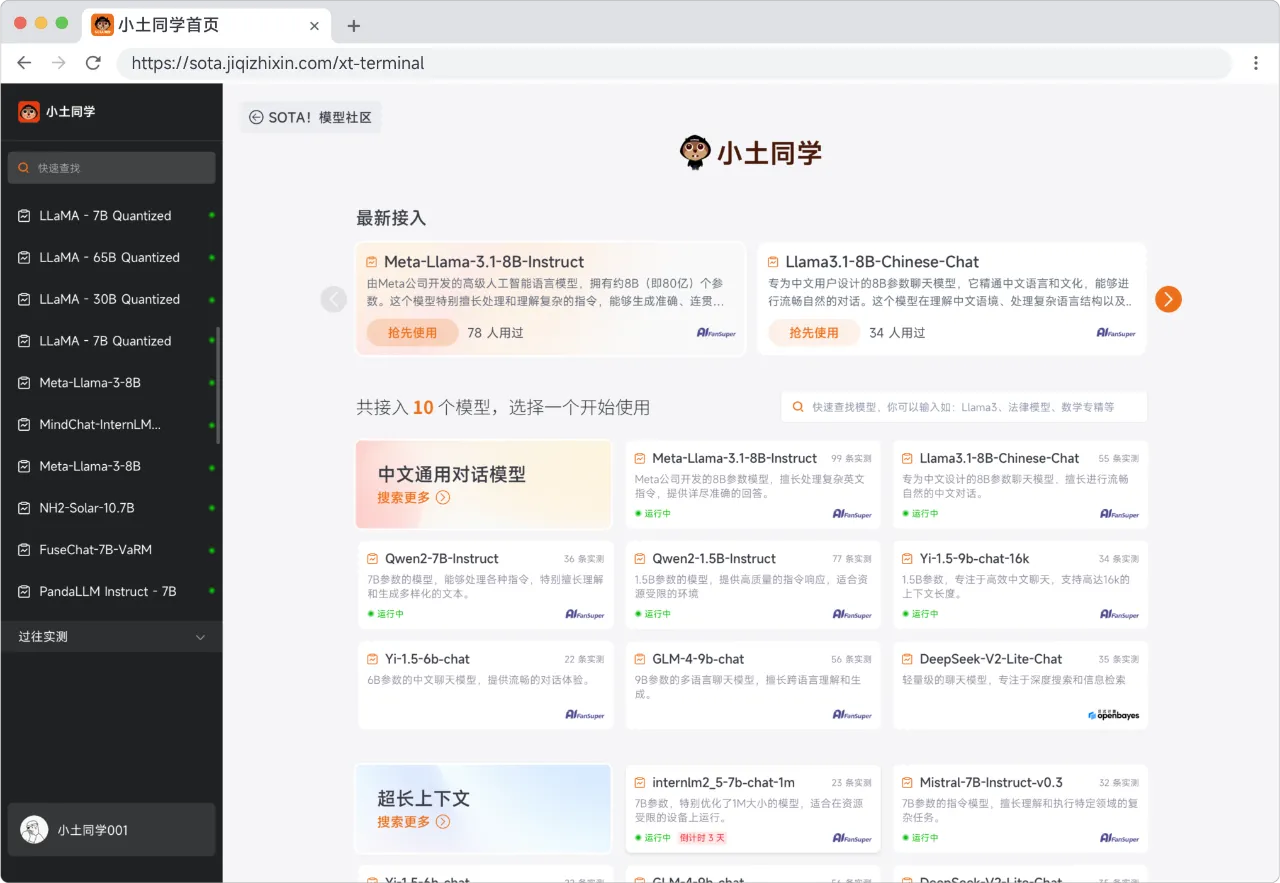
不用部署,实现大模型切换自由!Token、算力免费薅!咱AI开发者今年整个秋天的奶茶都省出来了!
不用部署,实现大模型切换自由!Token、算力免费薅!咱AI开发者今年整个秋天的奶茶都省出来了!作为全公司产品做的最好的工程师,同时也是代码写得最好的产品经理,你深刻地知道:搞个靠谱的 AI 应用需要灵感,而好的灵感则需要一个靠谱的 demo 来验证。
来自主题: AI资讯
7314 点击 2024-08-13 18:04

 搜索
作为全公司产品做的最好的工程师,同时也是代码写得最好的产品经理,你深刻地知道:搞个靠谱的 AI 应用需要灵感,而好的灵感则需要一个靠谱的 demo 来验证。

T-MAC是一种创新的基于查找表(LUT)的方法,专为在CPU上高效执行低比特大型语言模型(LLMs)推理而设计,无需权重反量化,支持混合精度矩阵乘法(mpGEMM),显著降低了推理开销并提升了计算速度。
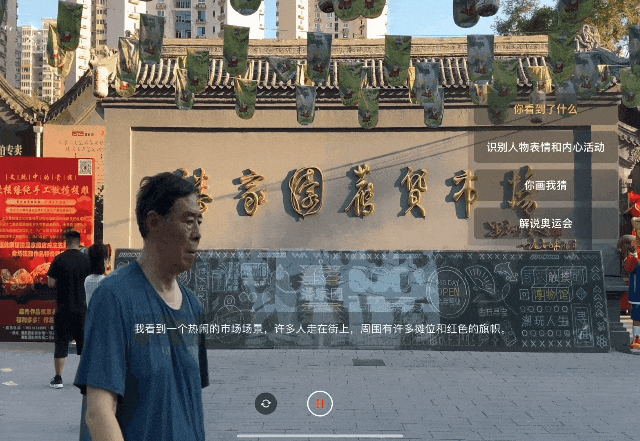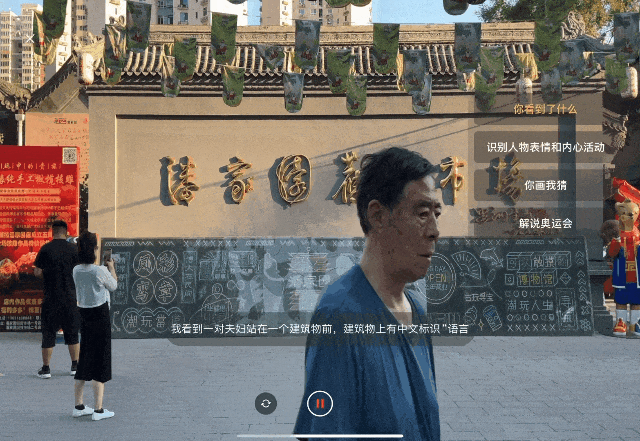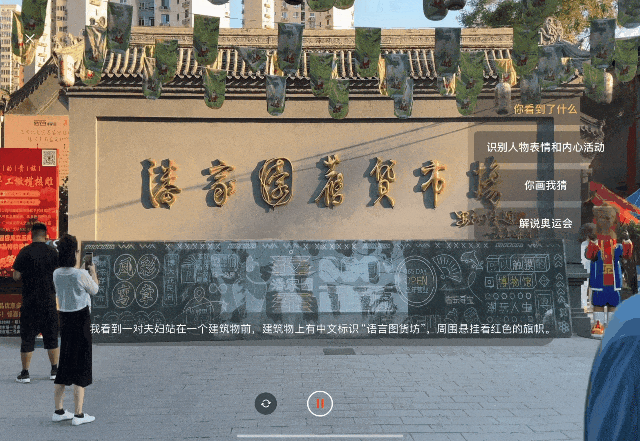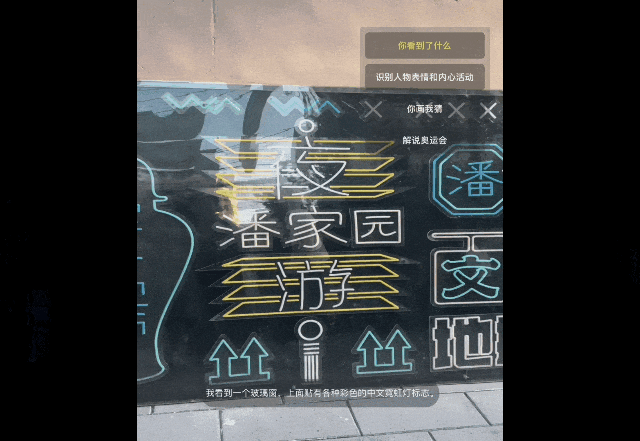
事情是这样的,前两天面壁刚刚推出了“小钢炮” MiniCPM-V 2.6 模型,据说视频理解能力直接对标GPT-4V,最重要的是能直接部署在iPad 上。
有CPU就能跑大模型,性能甚至超过NPU/GPU!
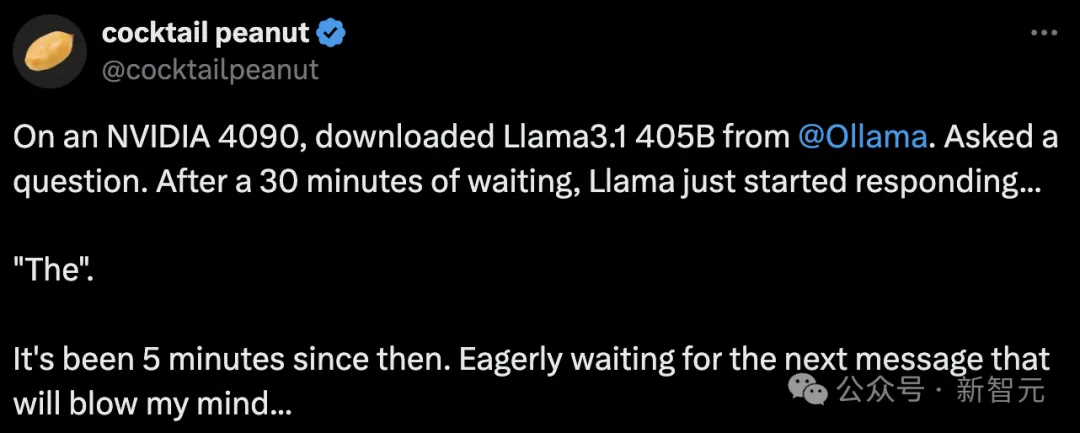
单卡搞定Llama 3.1(405B),最新大模型压缩工具来了!
不同类型的数据配比如何配置:先通过小规模实验确定最优配比,然后将其应用到大模型的训练中。 Token配比结论:通用知识50%;数学与逻辑25%;代码17%;多语言8%。
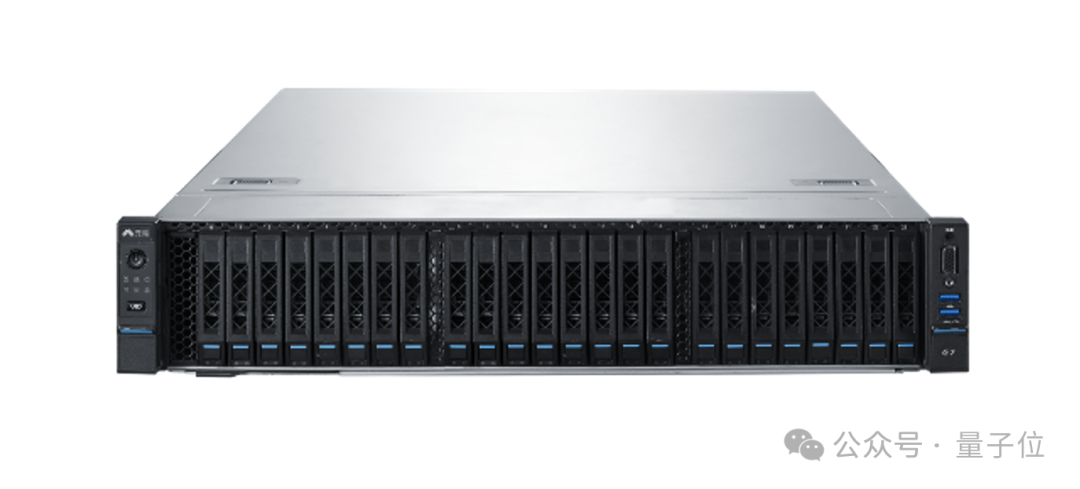
千亿参数规模的大模型推理,服务器仅用4颗CPU就能实现!
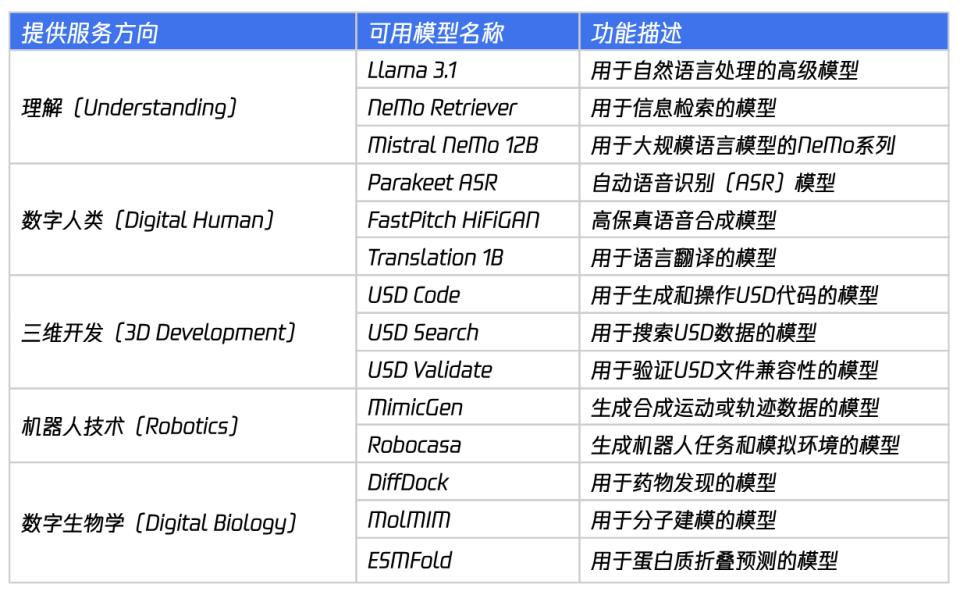
英伟达NIM新升级,助力AI在多领域应用。
紧跟着Meta的重磅发布,Mistral Large 2也带着权重一起上新了,而且参数量仅为Llama 3.1 405B的三分之一。不仅在编码、数学和多语言等专业领域可与SOTA模型直接竞争,还支持单节点部署。
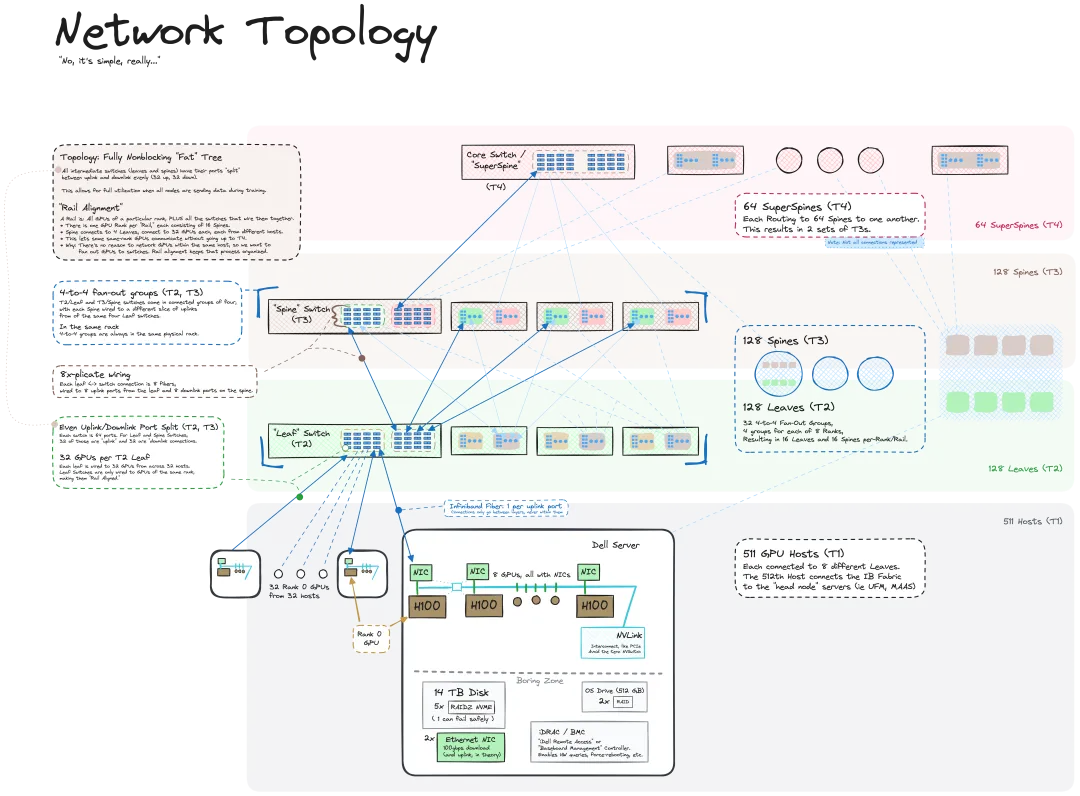
我们知道 LLM 是在大规模计算机集群上使用海量数据训练得到的,机器之心曾介绍过不少用于辅助和改进 LLM 训练流程的方法和技术。而今天,我们要分享的是一篇深入技术底层的文章,介绍如何将一堆连操作系统也没有的「裸机」变成用于训练 LLM 的计算机集群。