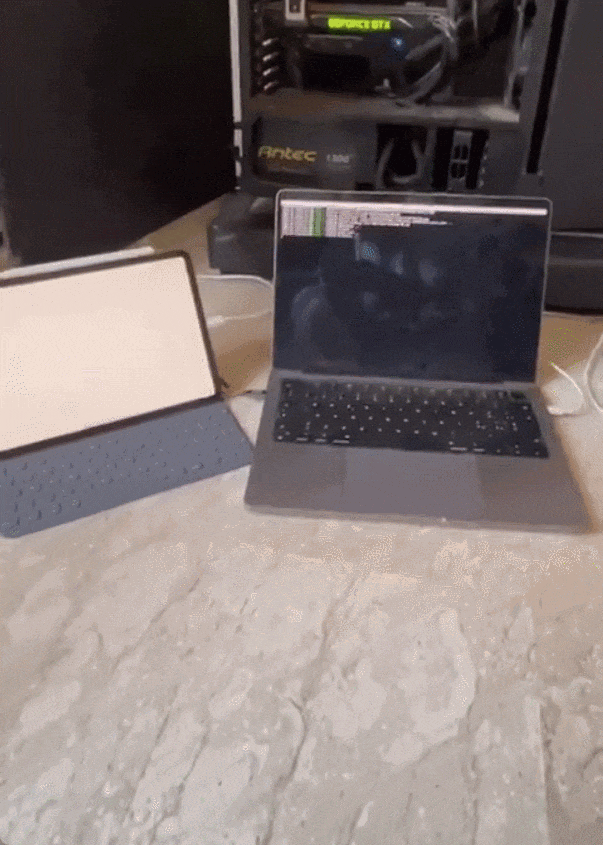
太酷了!iPhone、iPad、MacBook老旧设备组成异构集群,能跑Llama 3
太酷了!iPhone、iPad、MacBook老旧设备组成异构集群,能跑Llama 3假如你有闲置的设备,或许可以试一试。
来自主题: AI资讯
11886 点击 2024-07-16 19:50

 搜索
假如你有闲置的设备,或许可以试一试。
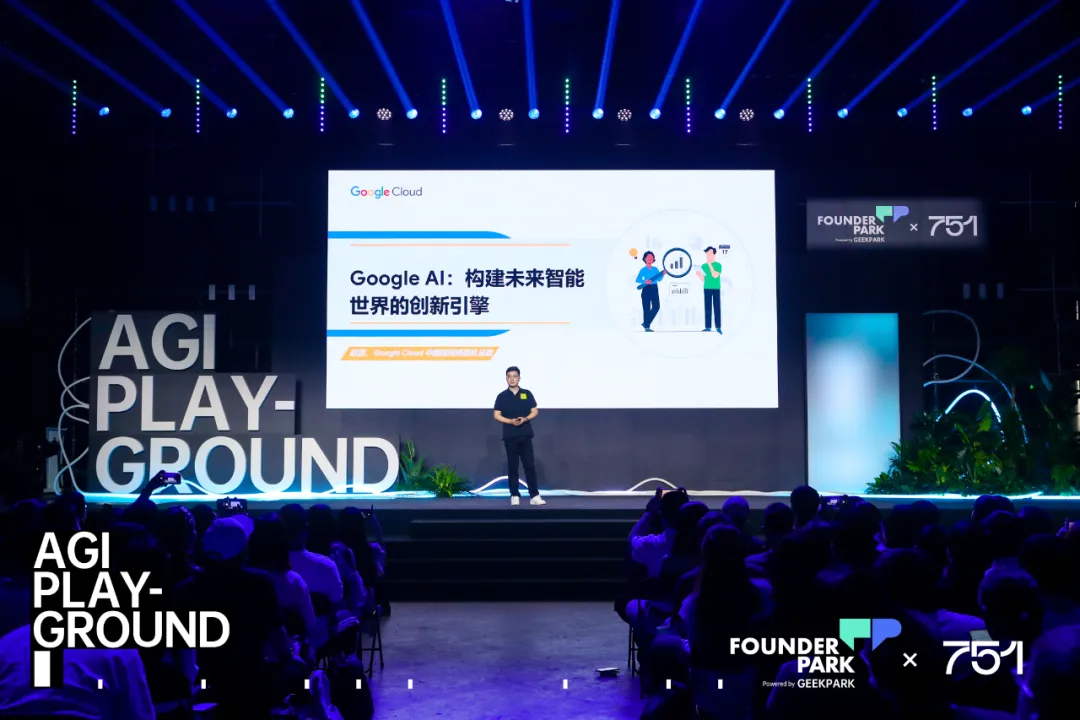
谷歌作为全球领先的科技公司,在 AI 领域拥有深厚的积累和卓越的创新能力,在谷歌眼里,生成式 AI 带来了哪些机会?Google AI 是如何在谷歌产品中落地的?Google Cloud 提供了一系列工具和平台,如何帮助开发者构建和部署自己的专属 LLM 和 Agent?负责任的 AI 为企业带来哪些价值?
昨晚,谷歌正式开源了自家最强的开源模型Gemma 2,直指为全球范围研究开发者提供实用部署工具。
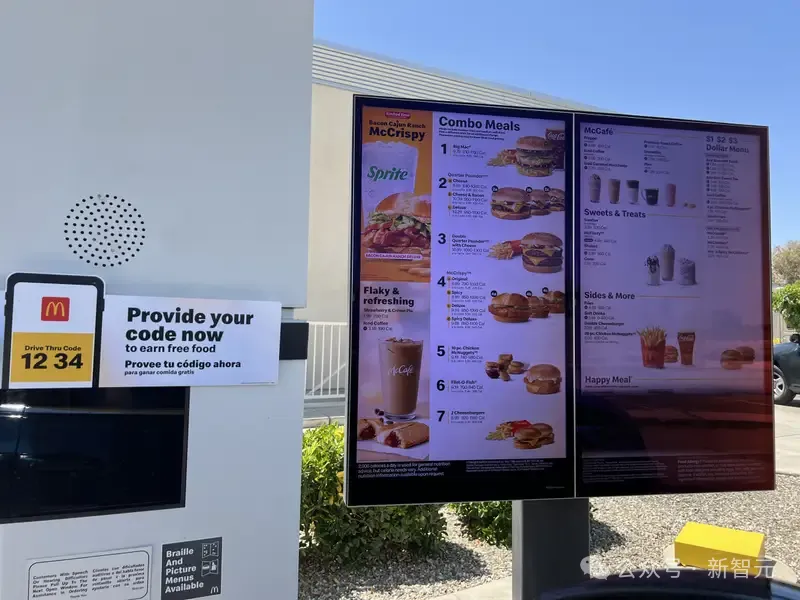
麦当劳宣布其与IBM合作进行的得来速人工智能语音点餐技术测试期结束,该技术已在100多家餐厅部署,这些餐厅将在下个月暂停此项服务。麦当劳表示,将会为自动点赞技术寻求新的合作方,潜在的合作伙伴可能包括OpenAI的Whisper/ChatGPT和谷歌的Gemini。
Build大会召开两周之后,微软更新了Phi-3系列模型的技术报告。不仅加入最新的基准测试结果,而且对小模型、高性能的实现机制做出了适当的揭示。
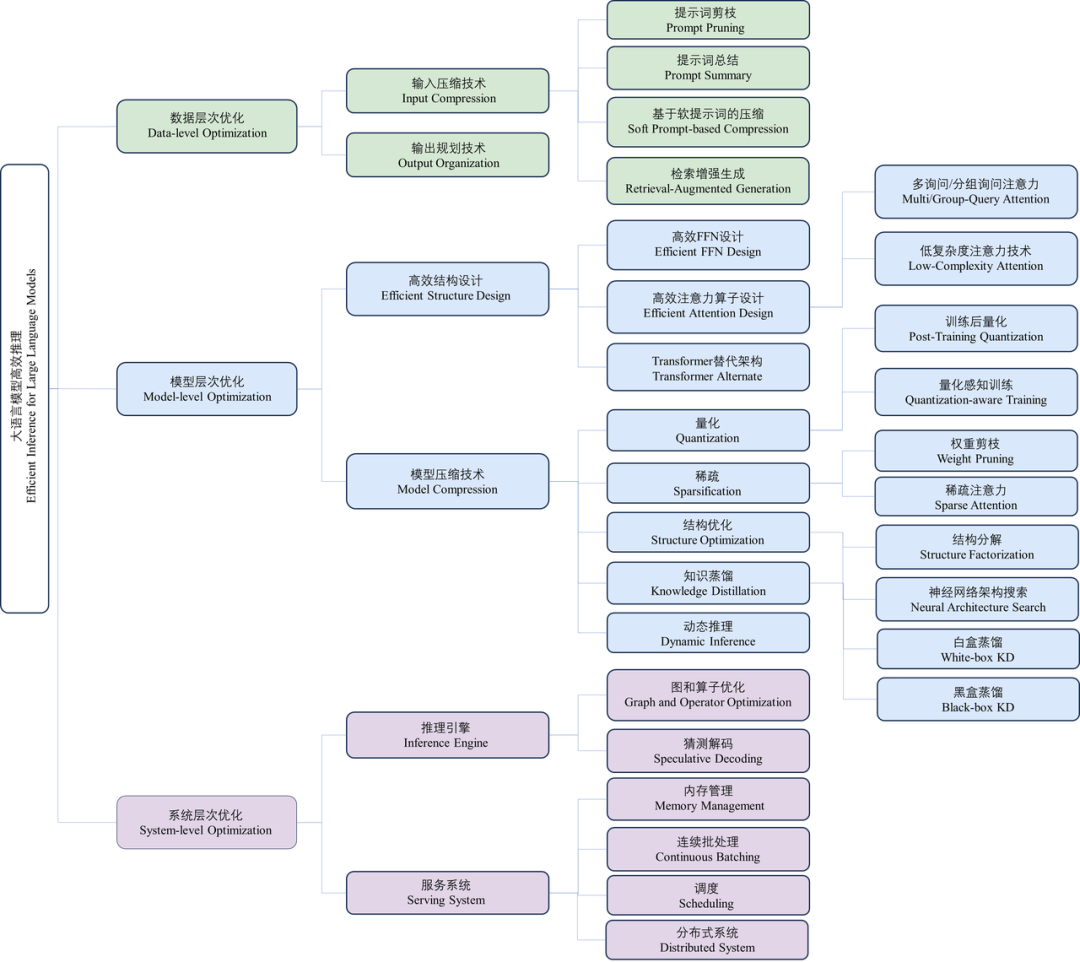
近年来,大语言模型(Large Language Models, LLMs)受到学术界和工业界的广泛关注,得益于其在各种语言生成任务上的出色表现,大语言模型推动了各种人工智能应用(例如ChatGPT、Copilot等)的发展。然而,大语言模型的落地应用受到其较大的推理开销的限制,对部署资源、用户体验、经济成本都带来了巨大挑战。
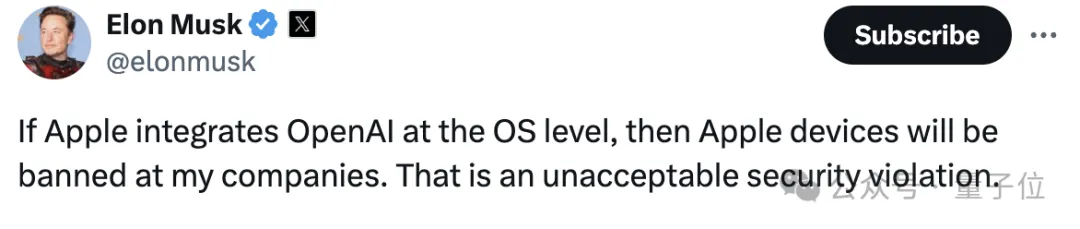
苹果一出手,在手机等移动设备上部署大模型不可避免地成为行业关注焦点。
大型语言模型(LLM)的一个主要特点是「大」,也因此其训练和部署成本都相当高,如何在保证 LLM 准确度的同时让其变小就成了非常重要且有价值的研究课题。
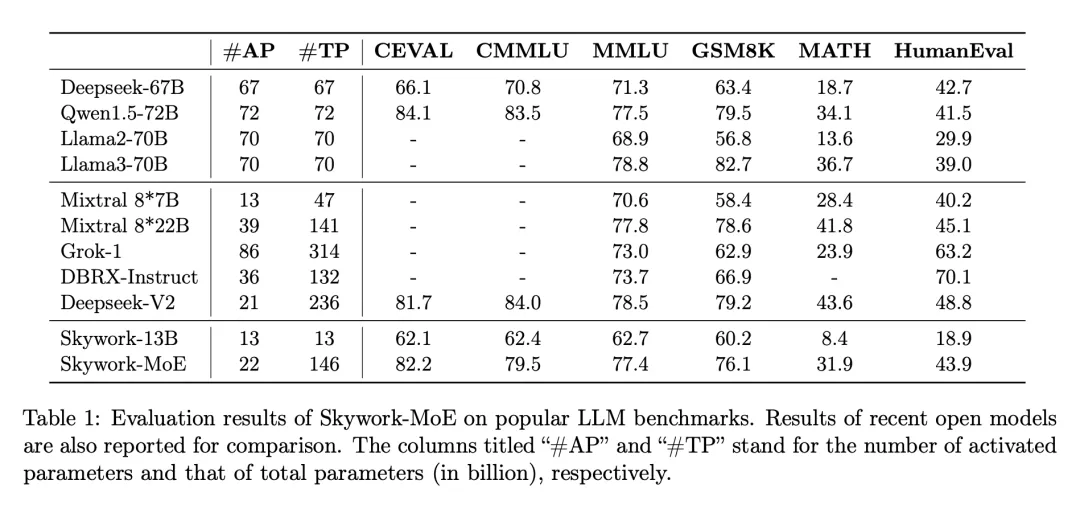
在大模型浪潮中,训练和部署最先进的密集 LLM 在计算需求和相关成本上带来了巨大挑战,尤其是在数百亿或数千亿参数的规模上。为了应对这些挑战,稀疏模型,如专家混合模型(MoE),已经变得越来越重要。这些模型通过将计算分配给各种专门的子模型或「专家」,提供了一种经济上更可行的替代方案,有可能以极低的资源需求达到甚至超过密集型模型的性能。
在大模型实际部署落地的过程中,如何赋予大模型持续学习的能力是一个至关重要的挑战。这使其能够动态适应新的任务并不断获得新的知识。大模型的持续学习主要面临两个重大挑战,分别是灾难性遗忘和知识迁移。灾难性遗忘是指模型在学习新任务时,会忘记其已掌握的旧任务。知识迁移则涉及到如何在学习新任务时有效地应用旧任务的知识来提升新任务学习的效果。