

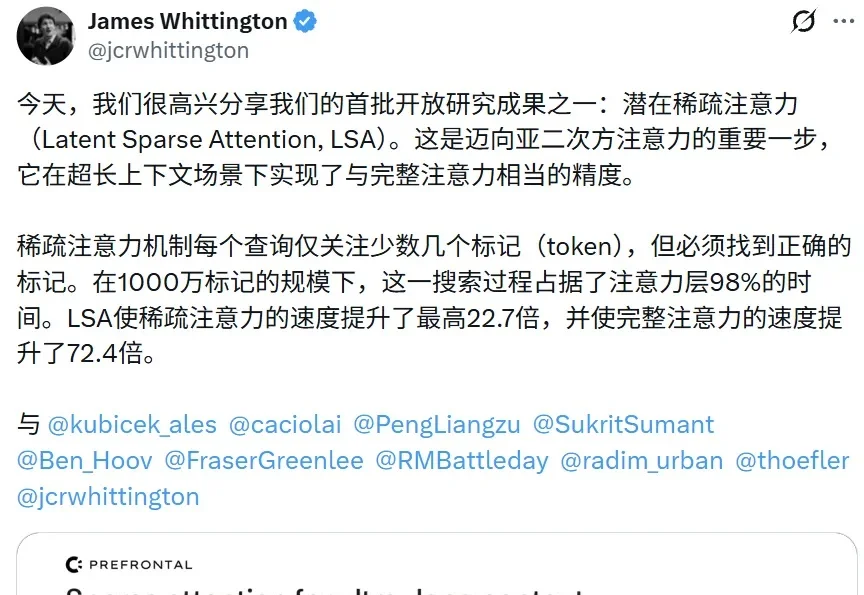
千万token下,比DeepSeek式稀疏注意力再快22倍
千万token下,比DeepSeek式稀疏注意力再快22倍如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。
来自主题: AI技术研报
9070 点击 2026-11-17 16:25