
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
大模型一定要一个 token 接一个 token 地生成文字吗?
9 月 15 日,前 OpenAI 研究员 Diogo Almeida 在社交媒体上公布了自己过去两年一直秘密推进的项目——一种名为 Jev 的全新 AI 模型。和 ChatGPT、Claude 等主流 LLM 不同,Jev 不再生成自然语言,而是直接输出结构化判断、概率和置信度。
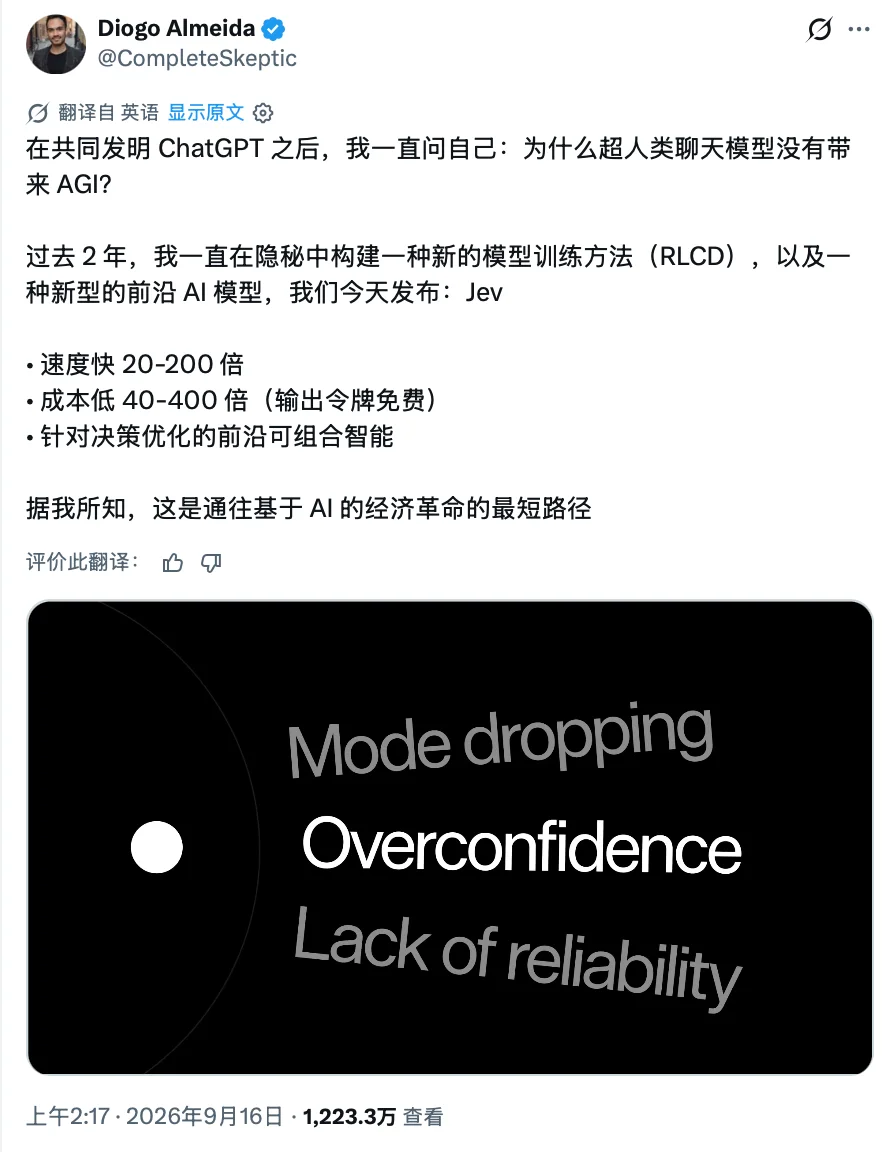
(来源:X)
这也是 Almeida 创办的 AI 初创公司 TypeSafe AI 推出的首款模型。2024 年离开 OpenAI 后,Almeida 与几位联合创始人组建 TypeSafe,此后一直保持隐身。直到这次发帖,公司才正式亮相,并同期披露完成 4,000 万美元种子轮融资,由 DCVC 领投,本轮估值约为 2 亿美元。
TypeSafe 将 Jev 归入一类名为 System One 的新模型,并给出了看起来相当不错的性能数据。其宣称,在特定结构化工作流中,Jev 最高可比前沿 LLM 快近 200 倍、便宜 400 多倍,甚至能把“幻觉”和类型错误率做到 0%。
而 Almeida 的背景让这条路线显得尤其有意思。在 OpenAI 期间,他参与了 2022 年 InstructGPT 的研究。这项工作将监督微调、人类偏好数据和 RLHF 结合起来,让 GPT-3 更能按照人的意图回答问题,后来 ChatGPT 也沿用了相近的 RLHF 路线。OpenAI 在 GPT-4 的贡献者名单中,也将 Almeida 列入“Foundational RLHF and InstructGPT work”一栏。
图|Diogo Almeida(来源:Typesafe)
换句话说,他此前参与推动的是一条让大语言模型更擅长理解指令、生成符合人类偏好的自然语言回答的路线。如今,他却开始反过来追问这套范式在自动化场景里的局限:如果 AI 最终要进入软件后台持续做判断,是否还有必要每次都先生成一段文字,再把结果交给程序解析?
要理解 Jev,首先要区分人与 AI 交互和机器调用 AI 这两种场景。
ChatGPT、Claude 这类大语言模型,本质上是生成模型。接到输入之后,它们不断预测下一个 token,再用已经生成的 token 继续预测后面的内容,最终形成一段文字。即使用户要求的是 JSON、函数调用或者几个固定选项,底层仍然是在按照序列逐步产生 token。
这种设计非常适合聊天,因为人需要模型解释、推理、写作,也需要它处理几乎无法提前穷举的开放式问题。字符串是一种极其通用的接口,一段文字可以是文章、代码,也可以是工具调用。
可到了软件后台,情况会有所不同。比如一个电商系统需要连续判断:“这笔订单是否异常?”“应该进入哪个审核流程?”“这个客户的流失风险有多高?”软件最终需要的可能只是几个值,却要先等待 LLM 生成字段名、数字、标点乃至额外解释,然后再解析、检查这段输出,才能进入下一步。
Jev 想要直接去掉这个中间环节。TypeSafe 用一句话概括它的接口:“unstructured state in, typed probabilistic decisions out”,也就是输入可以是一段复杂的业务信息,输出则是预先定义好的判断结果和概率。
比如,一个客服系统收到一段用户投诉记录,传统 LLM 可能先生成一段文字:“这名用户有较高流失风险,建议转人工处理,并考虑退款。”程序还要再从这句话里提取“高风险”“转人工”“退款”这几个真正有用的结果。
Jev 的做法则更直接,系统可以事先规定只需要三个答案:是否有流失风险、是否转人工、是否退款。Jev 读取同样的投诉记录后,直接返回“流失风险 82%”“转人工 91%”“退款 37%”。程序拿到这些结果后,就可以直接进入下一步,不需要再解析一段自然语言。
在采样方式上,TypeSafe 称 Jev 使用了并行采样器(parallel sampler)。主流自回归 LLM 需要逐 token 生成,而 Jev 可以在一次查询中并行产生多个结构化结果。
不过,“全新架构”这个说法目前还有待考察。因为TypeSafe 只披露了“new model architecture”、并行采样器以及一套新的训练方法,却没有公开参数规模、网络结构、backbone、预训练方式和训练数据。Jev 内部究竟使用了多少 Transformer 或语言模型已有技术,现在还无法判断。目前能确定的,是它明显改变了输出接口、训练目标和采样方式。
与 Jev 配套的,是 TypeSafe 提出的一套新训练方法 RLCD(Reinforcement Learning for Calibrated Decisions)。它不再主要优化模型生成的回答是否讨人喜欢,而是训练模型在做结构化决策时,给出尽可能可靠的概率和置信度。
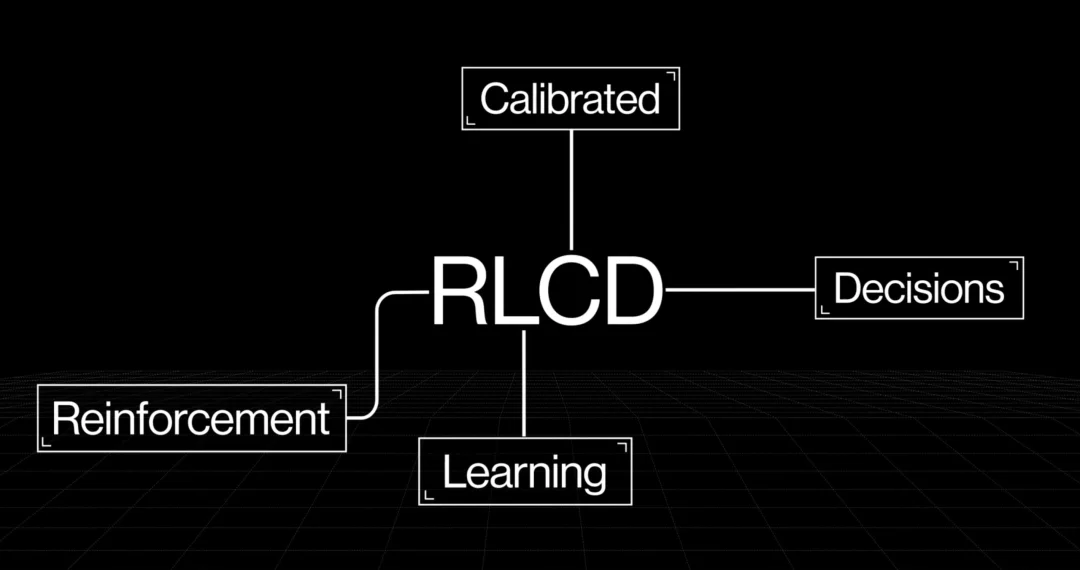
(来源:TypeSafe AI)
举个例子,如果模型对很多次判断都给出“90% 的把握”,那么统计下来,这些判断中大约应该有 90% 最终是正确的。也就是说,模型说自己有多大把握,最好就真的有多可靠,这就是所谓的 calibration(概率校准)。TypeSafe 认为,这比让模型只给一个“是/否”更适合自动化系统,因为程序可以根据置信度决定是自动执行、继续验证,还是交给人工。
这也决定了 Jev 目前瞄准的应用范围。TypeSafe 列出的场景包括分类、路由、评分、信息提取、业务流程分支、大规模数据处理,以及给其他 LLM 做 judge、guardrail 和越狱检测等。公司把它形容成一种“smart if-statement”:原本必须由程序员提前写死规则的地方,可以插入一个能够理解语义的概率判断。
为了展示低延迟,TypeSafe 甚至让 Jev 玩起了《毁灭战士》。不过这个 Demo 本身并没有证明什么新的游戏能力。模型读取的是已经转换成文本和数据结构的游戏状态,并没有直接处理画面,公司也承认,一个传统专用游戏 Bot 完全可以玩得更好。但展示的重点是模型可以每秒连续接受多次查询,在实时软件中反复做判断。
Jev 发布时最吸引眼球的,是“20~200 倍更快”和“40~400 倍更便宜”这两组数字。
从技术原理看,这种差距并不难理解。Jev 面向的是结构化决策任务,不需要像传统 LLM 那样自回归生成几十甚至数百个 token,而是可以一次性给出一组概率或判断,因此响应时间和推理成本天然更低。
TypeSafe 也展示过这种差异。在一项与 GPT-5.6 Terra 的并排演示中,两边读取相同的业务信息,并回答一批结构化问题。Jev 可以一次输出所有概率,而 GPT-5.6 Terra 仍需逐 token 生成答案,因此速度差非常明显。不过,公司也主动说明,这项演示经过了高度简化:输入较短、信息密度高,问题也被整理成适合结构化判断的形式,这些条件都会放大 Jev 的优势。
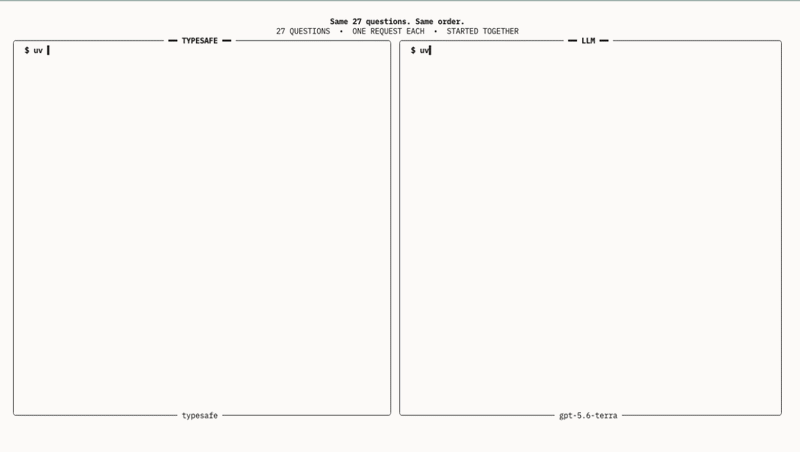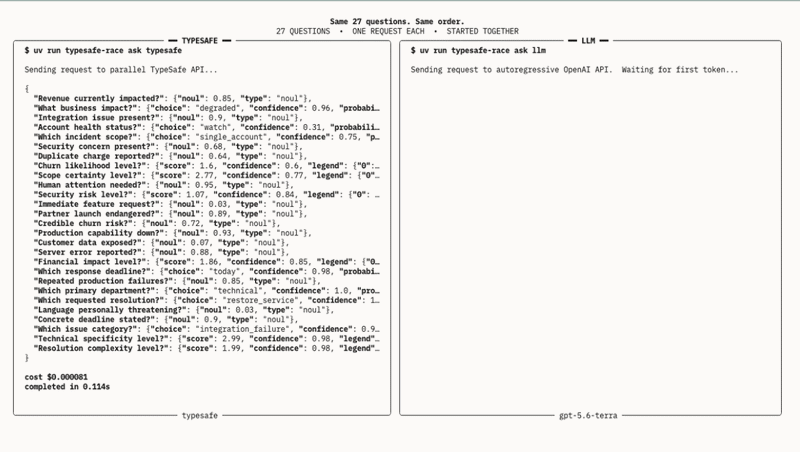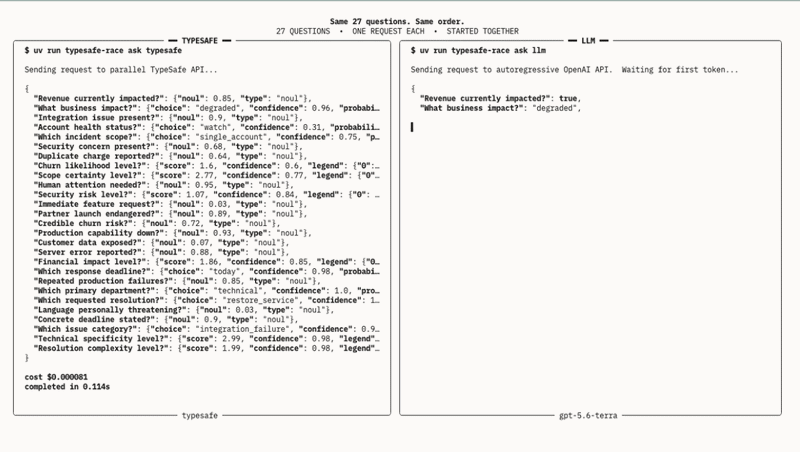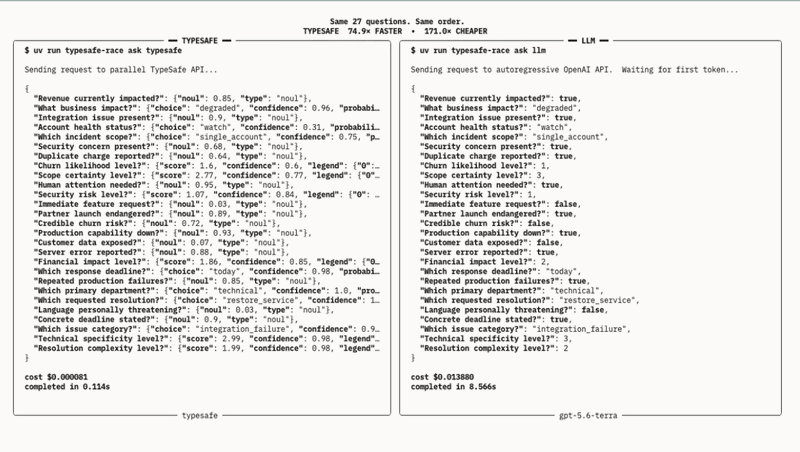
图 | 在同一组 27 个结构化判断中,Jev 一次并行返回所有结果,而传统 LLM 仍需逐 token 生成答案(来源:TypeSafe AI)
官网中“193.6 倍更快、444.6 倍更便宜”的数字,则来自 TypeSafe 自行设计的 workflow eval。4 个工作流都包含大量独立判断,但评测并没有采用现实世界的 ground truth,而是把 GPT-6 Astra 和 Fable 5.1 的预测概率取平均作为参考,再衡量 Jev 与这个参考值有多接近。
因此,这套 benchmark 更适合说明:在 TypeSafe 设定的结构化决策任务里,Jev 可以用更低的时间和成本,做到与前沿 LLM 相近的判断。它还不足以证明 Jev 已经拥有与这些模型相同的通用能力。
TypeSafe 自己也给这些数字留了余地。公司称,193.6 倍和 444.6 倍属于他们预计在现实场景中“偏高端”的收益,而且 4 个 workflow 由自己的模型能力团队制作,因此可能存在一定选择偏差。对照组中的 LLM 还要通过 TypeSafe 的 System One wrapper 输出完整概率,这也会增加一些延迟和成本。
另一个值得注意的说法是,TypeSafe 宣称 Jev 可以避免传统 LLM 常见的幻觉和类型错误。这里更准确地说,是 Jev 的输出空间被提前限定,因此不会生成 schema 之外的字段或工具名称。公司在结构化输出和工具调用测试中把 Jev 的错误率标为 0%,但也明确说明,这个 0% 并非经验测试结果,而是来自 schema matching 的机制保证。
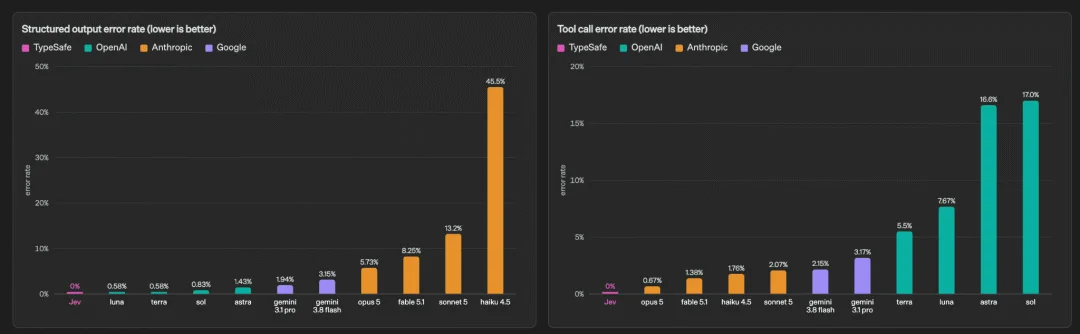
图 | TypeSafe 对比 Jev 与多款前沿模型的结构化输出和工具调用错误率,并称 Jev 可从机制上避免格式和类型错误(来源:TypeSafe AI)
这并不代表 Jev 的判断永远正确。如果可选答案只有 A、B、C,它可以保证不会输出 D,但仍然可能在 A、B、C 中选错。因此,“不会幻觉”更适合理解为不会产生越出预设结构的输出,而不是不会犯语义或判断错误。
RLCD 也是类似。TypeSafe 希望通过这种训练方法,让模型给出的概率更加可信,这个方向对自动化系统确实重要。不过目前公开材料还没有给出足够完整的校准指标和外部测试,因此它到底能把概率校准做到什么程度,还需要后续论文或独立评测来验证。
但这不等于模型永远不会判断错误。如果可选答案只有 A、B、C,Jev 可以保证绝不会输出 D,可它依然可能坚定地选择 A,而真实答案其实是 B。TypeSafe 自己也注明,其图表中的“0%”并非经验测试测出来的,而是基于 schema matching 的结构保证。
RLCD 的概率校准也面临类似问题。这个方向本身很有价值,但目前公开材料里还看不到足够完整的 ECE、Brier Score、reliability diagram,也没有系统展示模型在领域变化、输入分布偏移之后,置信度是否仍然可靠。
不过在质疑之外,Jev的出现,也确实带来了一个更有意思的角度。
过去几年,LLM 逐渐成为 AI 应用里的通用接口。分类可以问 GPT,审核可以问 GPT,信息提取可以问 GPT,Agent 不知道下一步做什么,同样可以再调用一次 GPT。生成模型够通用,开发者不需要为每个环节单独训练模型。
但这种便利很可能带来另一种浪费:我们开始用一个擅长“生成任何东西”的模型,去完成大量其实只需要“做一个判断”的工作。
当然,过去也已经有分类器、reranker、reward model 和各种专用判别模型,它们都可以比大型生成模型便宜得多。
TypeSafe 押注的是更进一步的可能性:能不能把过去高度专用的判别模型,做成一个通用的基础模型。它既能读取复杂的自然语言和程序状态,又能跨任务完成大量不同判断,并给出足够可靠的概率,同时保持远低于生成模型的成本和延迟。
如果这个假设能够成立,AI 软件未来可能出现更明确的分工。大型语言模型继续负责开放式生成、复杂推理和长程规划;另一类像 Jev 这样的模型,则被埋进代码深处,每秒完成大量分类、路由、检查和决策。一个 Agent 内部可能不需要每一步都调用最昂贵的前沿 LLM。
这也是为什么,Jev 最值得关注的指标可能最终不是“快多少倍”,而是它能覆盖多少原本必须交给前沿 LLM 的判断。
如果只能处理几个高度结构化的工作流,它更接近一个高效的专用模型平台;如果能够跨行业、跨数据分布保持接近前沿模型的判断能力和概率校准,那么 TypeSafe 才真正证明了一类新的软件原生 AI 接口具有存在价值。
参考链接:
1.https://typesafe.ai/blog/introducing-system-one-models-and-jev
2.https://typesafe.ai/
3.https://www.dcvc.com/news-insights/typesafe-emerges-from-stealth-with-a-new-way-of-doing-ai/
4.https://www.forbes.com/sites/the-prompt/2026/09/15/this-200-million-startup-wants-to-fix-ais-overconfidence-problem/
5.https://openai.com/contributions/gpt-4/
6.https://arxiv.org/abs/2203.02155
7.https://github.com/openai/following-instructions-human-feedback/blob/main/README.md
文章来自于"DeepTech深科技",作者 "张锦怡"。


【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
