
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
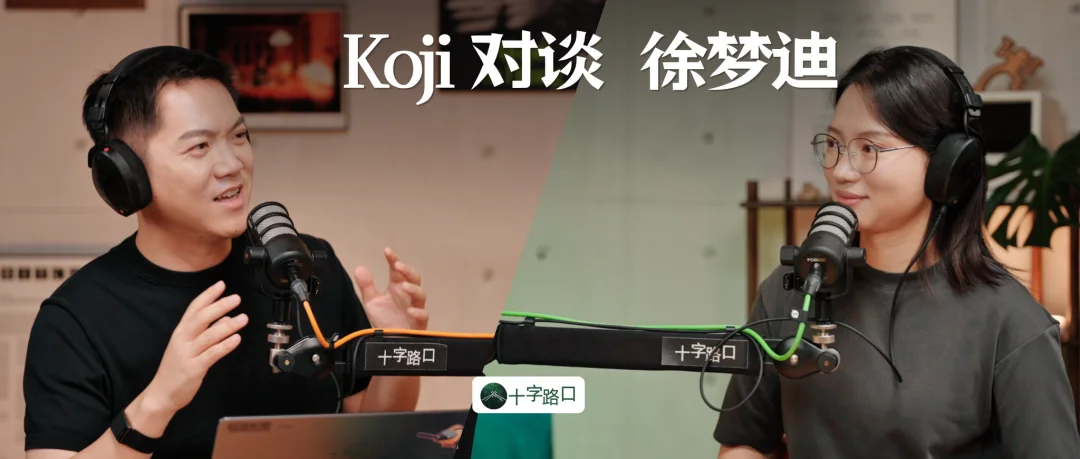
🚥 本周「十字路口」的嘉宾是清华叉院助理教授徐梦迪。从清华车辆工程出发,途经 Johns Hopkins、CMU,再到 Stanford 吴佳俊、李飞飞组做博士后,2024 年初她选择回国,加入清华交叉信息研究院。她的核心命题是机器人的 In-Context Learning (ICL):让机器人到一个新环境,通过一两次交互当场学会新任务,而且越学越快。
本期节目还有一个及时的注脚:就在我们录完节目后的第二周,Generalist 发布 GEN-1.5 ——只给机器人看一段 3-12 秒的动作示范作为 "physical prompt",不做微调、不更新参数,它就能当场尝试完成新任务(10 项任务平均成功率约 59%)。ICL 随即成为全球具身智能领域最受关注的话题之一,而这正是梦迪持续押注的方向。
除了 ICL,我们还聊到:
•预训练的天花板
•真正的泛化
•Scaling Law 的信号与陷阱
•跑通稳定的数据闭环
•叠衣服 demo 的误导
•行业的泡沫与进步
•年轻 PI 的真实生活与研究选择
穿越所有的技术话题之后,这还是一期关于人生选择、环境与长期主义的对话,希望可以是给所有站在中美之间、学术与产业之间、跟随热点与坚持长线之间的年轻人的一份参考。
微信收听播客:
小宇宙收听播客:
🎬 视频播客已同步上线于 @Koji杨远骋 的视频号、小红书、哔哩哔哩、Youtube 等平台
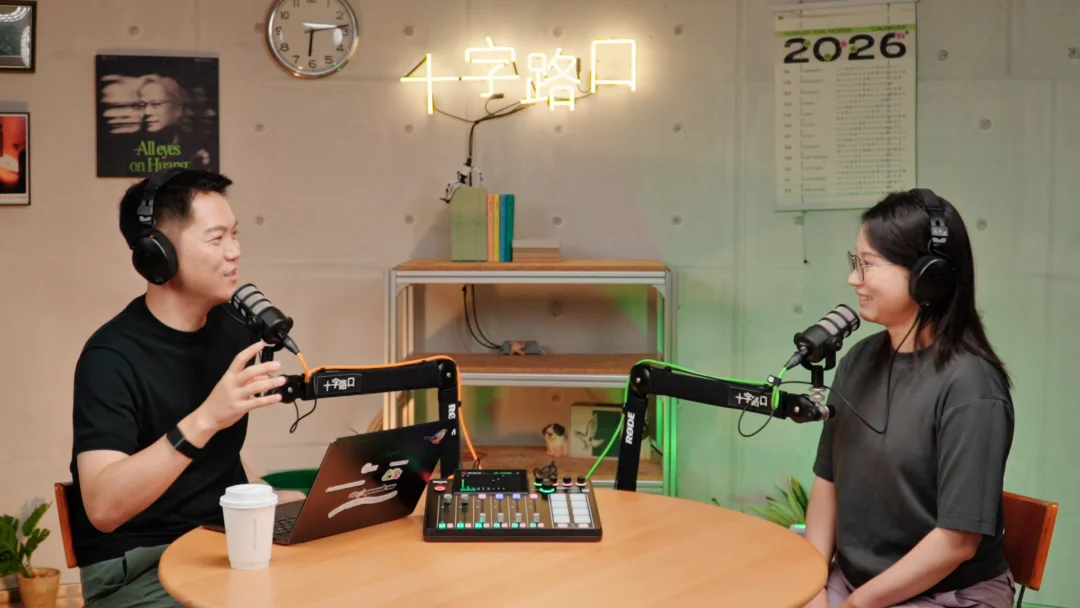
👦🏻 Koji
我们先从传统快问快答开始,帮助大家了解你。梦迪你的年龄?
👩🏻 徐梦迪
我今年 30.5 岁。
👦🏻 Koji
30.5?这么精确!MBTI 和星座?
👩🏻 徐梦迪
我的 MBTI 是 INTJ,星座是摩羯。
👦🏻 Koji
一句话介绍你当前花时间最多的研究方向是什么?
👩🏻 徐梦迪
让机器人能够从现实场景当中,不断地持续提升自己。
👦🏻 Koji
这个做了多久?我记得很早之前你就在做泛化。
👩🏻 徐梦迪
在 CMU 之后,我其实就一直在沿着泛化的方向做。
当时觉得机器人不能只依赖预先学到的知识。人类之所以有这么强的泛化性,有两个层面:一是人有很多先验知识;二是人学新知识学得非常快。真正的泛化,是希望让机器人具备类似人类这种快速学习的能力。
👦🏻 Koji
当时是什么契机让你进入这个研究方向的?
👩🏻 徐梦迪
到 CMU 之后,我开始做当时叫 Robot Learning 的方向,把机器学习的方法用到机器人上,当时还不叫具身智能这个 fancy 的名字。
我在 CMU 时非常喜欢一个工作叫 MAML,是 Stanford 教授、Physical Intelligence 联合创始人 Chelsea Finn 非常有名的一项成果。MAML 厉害的地方在于,它能让机器人学到没见过的任务。我当时觉得这才是机器人未来的方向。
👦🏻 Koji
当时是怎么关注到这个工作的?
👩🏻 徐梦迪
当时这个工作非常有名,实验室有同学对 ML 前沿方向都很感兴趣,大家平时经常交流、分享文章。我们看的论文非常杂,就注意到了这个方向。
👦🏻 Koji
清华本科你读的是车辆工程系,从车辆工程到具身智能,中间感觉隔着一个“变形金刚”,你是怎么转型的?
👩🏻 徐梦迪
本科我学的是汽车,专业叫车辆工程。现在回想,当时去汽车系是一个非常正确的选择,汽车系学得非常全面:机械设计、汽车电子,跟电子系交叉很强,还有很多算法课程。从机械设计到算法,本科时都有所涉猎。
真正转向 Robotics 的契机在大二。当时我跟着机械系的阎绍泽老师做科研,做 Bio Robotics,研究蜜蜂翅膀的超弹性恢复。蜜蜂在采蜜过程中,翅膀会频繁与周围环境碰撞,但翅膀不会受损,因为它在结构上具有超弹性的性质。
以此为契机,大三暑研我去了 CMU Howie Choset 教授的组,他们组非常有名的方向就是 Bio Robotics。我在那里设计了一个爬管子的蛇形机器人,从那会儿开始,工作重心从机械设计逐渐转向了机器人算法。
👦🏻 Koji
这应该不是车辆工程系学生的常规路径吧?
👩🏻 徐梦迪
汽车系学生有个特点:自己想做的事情,就会非常努力去找跟兴趣 match 的地方。
当时有一些学长在阎绍泽老师组里,包括现在在哈佛做 AP 的杨珩学长,还有我高中一起学竞赛的同学也在,阴差阳错,我非常幸运地进了阎老师的组。
👦🏻 Koji
说到高中竞赛,你在中学甚至小学阶段是怎样的经历?一路都是学霸吗?
👩🏻 徐梦迪
我特别不敢称自己是学霸。后来求学、出国,见过太多厉害的人,大家都有非常独特的想法。学不学霸,无非是有人把精力放在学业上,有人放在了更感兴趣的事情上。
我小学过得挺轻松的,没上过补习班,课余时间要么参加学校活动,要么跟朋友玩。
👦🏻 Koji
我记得你的高中是衡水中学?
👩🏻 徐梦迪
对,衡中。小学时家里给的环境比较宽松,过得很快乐。当时有个爱好是拼四驱车,赶上动漫《四驱兄弟》大火,买零件自己拼,拼车很费钱,我们还琢磨着怎么赚钱。
👦🏻 Koji
玩四驱车还能赚钱?
👩🏻 徐梦迪
大院里好几个小朋友都喜欢,大家就想办法搞钱买车。
👦🏻 Koji
怎么赚呢?
👩🏻 徐梦迪
放学路上捡废品卖掉,其实还蛮赚钱。
👦🏻 Koji
听起来很像城市寻宝游戏,但是什么样的废品能卖到买四驱车的钱呢?
👩🏻 徐梦迪
一些废弃的钢铁零件,会有人回收。现在想想,小时候找零件还挺有毅力的。
👦🏻 Koji
感觉很小就埋下了车辆工程的种子?
👩🏻 徐梦迪
确实是我后来选车辆工程的原因之一。我一直觉得机械结构特别酷,能把很多细小的零件组装在一起,凝结了几代工匠的知识积累,变成一台精密的仪器。
👦🏻 Koji
在衡水中学的体验是什么样的?
👩🏻 徐梦迪
我自己的体验挺好的。高中的时候我是竞赛生,主业是搞竞赛,跟高考班的管理要求不太一样。竞赛更需要激发自主的 motivation,所以课程节奏跟普通班不同。
👦🏻 Koji
你是怎么成为竞赛生的呢?
👩🏻 徐梦迪
高一第一学期结束时会有意向调研,老师会来问对哪科感兴趣。当时我在数学和物理之间挑,觉得物理是一个非常 ground 到现实世界的学科,就选了物理。
👦🏻 Koji
听说衡中早上 5 点多、6 点就要起床,作息精细到几分钟。我听说甚至一个礼拜只有一次洗澡机会?
👩🏻 徐梦迪
不管是高考班还是竞赛班,作息要求都很一致:早操、上午操,时间表极其严格,高一到高三错峰去食堂。管理上确实非常严苛。
👦🏻 Koji
外面对衡水模式讨论很多,大家很好奇衡水毕业生的未来发展?你的观察是什么?
👩🏻 徐梦迪
以竞赛班来说,大家的特点是每个人都有极其强烈的个人想法。竞赛需要巨大的时间 commitment,因为别人放寒暑假,我们也在搞集训。我们班同学,一部分出国成了优秀的 Researcher,一部分在国内发展得也很好。
👦🏻 Koji
当时选择竞赛路线,是不是也像是选择了一条不归路?
👩🏻 徐梦迪
会有这种感觉。你不可能像其他高考学生那样面面俱到地学所有科目。一路经历竞赛考试、保送、自招,直到确定没有保送机会了,才会 merge 进普通高考班,但那时已经到高三下学期了。
👦🏻 Koji
有点像创业,需要破釜沉舟。
👩🏻 徐梦迪
对,但当时觉得非常有意思、有干劲。身边的朋友目标高度一致,小到解出一道题,大到冲省一、拿金牌,motivation 极强,完全不觉得苦。
👦🏻 Koji
同学之间竞争强吗?
👩🏻 徐梦迪
竞争肯定存在,但教练引导得很好。在班级里大家更像是并肩作战的同伴。所有人从零开始抱团解决问题,这种战友式的情谊比竞争坚固得多。
👦🏻 Koji
在 CMU 读机械工程时,你的拿了系里的最佳 PhD 论文奖。这个奖一年发出多少个?
👩🏻 徐梦迪
我们那一届是两个人。
👦🏻 Koji
那篇论文的核心内容是什么?
👩🏻 徐梦迪
题目叫《Building Adaptable Generalist Robots》。核心是希望让机器人具备适应动态变化环境的能力。
预训练当然有用,我也非常相信 scaling,但预训练不是全部。我们不能指望机器人光靠预训练就变成一个 100% 成功的全能个体,它进入真实环境必须适应具体的变化。
现实是开放世界,任务在不断变化:家里今天有 20 个物体,一周后可能有 30 个,品类完全不同;不同人在不同场景下的 preference 也在变。对应到机器人的能力上,必须能够适应变化,并在变化中自我迭代。
👦🏻 Koji
当时主要的解题路径是什么?
👩🏻 徐梦迪
主要是两条路:
第一条是 In-Context Learning,上下文学习;第二条是 Test-Time Training,在部署时调整一小部分模型参数。目标都是让机器人摆脱单纯对 Pre-training 的依赖,通过 context 和 interaction 在现实场景中持续学习。
In-Context Learning 这条线,源于我 2021 年做的工作 Prompt Decision Transformer。当时的 motivation 是看到了 GPT-3 的上下文学习能力。我觉得太酷了——传统的 ML 是遇到新任务就做 Fine-tuning,而 GPT-3 是给一个 prompt 或输出格式,模型根据 prompt 直接调整输出。这种 adaptation 方式高效直接,不需要在部署端重新训练。当时我就想,机器人能不能也具备这种能力?
Prompt Decision Transformer 从相对基础的 setting 切入:给模型一段机器人的 demonstration,让它快速 adapt 到不同的 locomotion 和 manipulation 任务。
第二项工作是它的续作,Hyper-Decision Transformer,走的是 Test-Time Training 的路子。在部署阶段调整参数是一把双刃剑:调了参数能解决当前任务,但调多了又会遗忘预训练知识。我们折中做了一个 Hypernetwork,将元知识注入其中,再由它生成一个只占整体 Transformer 0.5% 参数量的小 Adapter。部署时只需要更新这 0.5% 的参数。
👦🏻 Koji
实测效果怎么样?
👩🏻 徐梦迪
在小样本预训练的前提下,Hypernetwork 更容易见效。
但随着现在数据量和预训练规模的大幅积累,我认为未来的核心方向依然是 In-Context Learning。通过 prompting 的方式解决,不用频繁改参数;或者等收集到足够多的 multi-task 数据后,再做批量的参数更新。
👦🏻 Koji
你现在推进的工作,相比当时有哪些延伸?
👩🏻 徐梦迪
做完 Prompt Decision Transformer 之后,业内利用 In-Context Learning 做快速 adaptation 的工作多了很多。
DeepMind 有个工作叫 Algorithm Distillation,视角非常惊艳:模型到底应该等价于一种什么样的智能?
现在大家用 VLA,是将模型参数等价于任务知识的载体,把专家 demonstration 通过模仿学习 distill 到参数里;而 Algorithm Distillation 认为,模型参数应该等价于一个算法,等价于一个 RL algorithm。它把 suboptimal 的轨迹放入 context window,让模型根据过去的失误动作和历史不断修正未来的 action。Transformer 结构由此具备了自我提升能力,参数本身就是一个强化学习算法。
👦🏻 Koji
这项工作在真机上验证过吗?
👩🏻 徐梦迪
在模拟器里跑通了,但任务更偏 navigation 和 locomotion,比如走迷宫。用在 manipulation 上依然很难。
类似的工作还有 Skild 团队的 LocoFormer,用 Transformer 基于 In-Context Learning 做腿足机器人的 adaptation,也是偏 locomotion。还有英伟达最近的 RoboTTT,让机器人观察人类长程 manipulation 视频,通过 TTT layer 改变 behavior,复现出类似演示里的动作。
👦🏻 Koji
大家的解法听起来还挺发散的,有收敛的迹象吗?
👩🏻 徐梦迪
业内对 adaptation 的重视度明显高起来了。
大家逐渐意识到,仅靠海量数据和海量参数预训练,或者单纯依靠基于专家演示的模仿学习,无法彻底解决机器人应用。在此基础上的 adaptation 成了破局点,这个共识正在形成。
👦🏻 Koji
我觉得这听起来好像是顺理成章、理所当然的事,为什么到现在才变成核心共识呢?
👩🏻 徐梦迪
业内一直有争论。人类之所以泛化能力强,原因有二:一是漫长演化带来的深厚先验与小脑控制力;二是人类新学一项技能的速度极快。
此前的主流做法是通过 scale 数据和模型,先把机器人的 prior 做厚,强化 multi-task 和 instruction following 能力,这并不意味着 adaptation 不重要。
但在真实场景中,机器人如果只有自适应能力而没有足够扎实的基模底座,试错代价会非常可怕,比如把家里的杯子全打碎,先做强 prior 再做 adaptation,路径是合理的。
👦🏻 Koji
博士后你去了斯坦福,加入吴佳俊和李飞飞的实验室,当时主攻哪些方向呢?
👩🏻 徐梦迪
我参与了三个自己非常满意、也很有意思的工作。当时有非常强大的伙伴,主要把博士阶段偏理论的想法往落地推进。
第一个是 BEHAVIOR Challenge。这是飞飞组里倾注了大量心血的 simulation benchmark,试图回答一个根本问题:机器人到底应该解决什么样的现实任务?里面有极其丰富的家庭和学校场景资产。我在其中负责生成数据集,提出了一种叫 MoMaGen 的方法,生成双臂移动操作的数据,比我过去的工作更贴近实际落地。
第二个是围绕让机器人更具备 steerability,属于我的主线研究。让机器人能够遵循人类更多样化的指令,适应不同人的偏好。
第三个是做了一个叫 Creative Tool Use 的 benchmark,探索机器人能否拥有人类那种创造性使用物理工具的能力。
👦🏻 Koji
这个 benchmark 怎么做评测呢?从名字看,它既要 creative,又要能 benchmark。
👩🏻 徐梦迪
我们从采集人类真实数据起步。人在使用工具时,从来不是看工具的名字,而是看功能,也就是机器人学里常说的 affordance。
比如想切蛋糕,手边没有刀,用叉子或者筷子一样能切开;想清理桌面,没有扫帚,拿书本甚至用手臂一划也能搞定。人类懂得创造性地利用环境里的物体,我们希望机器人也具备这种行为。
我们采了大量人类创造性使用工具的数据,从三个维度评测:一是多模态大模型挑选工具和规划轨迹的能力;二是针对非刚体、柔性物体的 3D 和 4D 场景重建能力;三是能否将人类灵巧使用工具的技能迁移到机器人上。
👦🏻 Koji
李飞飞是什么样的风格,组里是什么氛围?
👩🏻 徐梦迪
当时我有两个 advisor,飞飞和佳俊。非常幸运能有两个 advisor,他们的风格挺不一样的,给我的收获也很不同。
飞飞非常 vision-driven。她总会抛出一些让你跳出单个项目去思考的问题,比如:未来 10 年,这个领域最本质的问题是什么?你在其中要扮演什么角色?
👦🏻 Koji
这两个问题是她原话问过的吗?
👩🏻 徐梦迪
不算是原话,但每次深入探讨,最终都会指向这个层面的思考。
我们当初定 benchmark 指标时,试图定很多细粒度的过程指标,比如进度百分比、各阶段耗时。飞飞直接点破:这些指标里哪个是真正重要的?只有最终的 Success Rate。过程指标是用来开发 debug 的,而不是最终的愿景。她当时引用了爱因斯坦的一句话:凡事应力求简单,但不能过于简单。
成为 PI 之后,核心职责是让大家始终盯住最本质的目标。佳俊则非常 hands-on,从 project 选型到具体 design 都会深度推演,在我迷茫时 push 我去打磨自己的 research brand。他们俩作为 co-advisor 是非常好的组合。
👦🏻 Koji
你如何理解建立 research brand 这件事?
👩🏻 徐梦迪
它必须发源于你真正的兴趣。如果一个问题能让你心甘情愿投入 5 到 10 年去深挖,它自然就会变成你的 research brand。
👦🏻 Koji
这跟创业很像,必须从你内心深处真正相信的事情出发?
👩🏻 徐梦迪
是的,从相信的地方出发。
👦🏻 Koji
这让我想到保罗·格雷厄姆那篇《如何成就伟大事业》的文章,每个知识体系远看都像一个完美光滑的球体,走近才发现到处是坑洼与黑洞,那些缺陷正是创业或研究的起点。
👦🏻 Koji
后来是什么促使你决定回国?当时留在斯坦福似乎是顺理成章的路?
👩🏻 徐梦迪
我是 2023 年回清华交叉信息研究院面试的,当时聊了院系里的很多老师,也包括姚先生。
👦🏻 Koji
当时怎么决定要来面试?
👩🏻 徐梦迪
2023 年我进入博士五年级,在考虑之后的发展方向。对我来说主要是工业界和学术界两个选择。
当时我在 Google 实习了非常长一段时间,体验非常好,mentor 给了我很多帮助,包括构建我自己的 research taste。在工业界确实有资源做更大规模的事情,学术界确实有一些资源上的限制,当时思考了很多到底去工业界还是学术界。
去叉院面试的契机,是有幸认识了吴翼老师,他帮我做了 bridge,拿到了面试机会。面试时跟院系老师聊、跟姚先生聊,体验都蛮好的。
叉院有几个强项:一是人很强,学生非常强。很多在美国做 Robotics 和 AI 方向的人都会认识一些姚班的人,姚班毕业生里有非常多各个领域的顶尖 researcher。
第二,我的研究方向是做机器人,机器人本身是一个系统,单纯只做大脑或者只做硬件,我心里都会觉得欠缺。我需要找一个最合适的地方,把机器人做成一个真正能落地的系统。综合考虑下来,叉院的机会是我的最优选择。
👦🏻 Koji
在工业界和学术界之间,后来是怎么做决定的?很多人现在也面临同样的十字路口。
👩🏻 徐梦迪
做决定之前,包括来叉院面试前,我找了非常多的朋友和师长寻求建议。后来发现,真正促使自己做决定的,还是心里具体想要什么。
工业界有很多算力支持,可以把小想法更容易地 scale up,但同时会有自由度的缺失。自由度对我来说非常重要,我希望时间能够最大化地分配到我认为重要的问题上,学术界是相对更好的选择。
落脚点还是自己心里真的觉得什么东西重要。
👦🏻 Koji
之前聊天你说有位老师问了一个让你印象深刻、好感倍增的问题?
👩🏻 徐梦迪
后来我也一直在思考这个问题。
他问:你为什么觉得你 5 年之后一定能成为自己领域的顶尖 researcher?
我当时的回答并不太好,只是非常自信地说“我觉得我一定可以”。但后来逐渐想,如果我找到了一个感兴趣的 topic——比如让机器人真的有一天能进入千家万户,同时能在实际环境中不断提升自己——沿着这个正确的道路研究 5 年,我觉得我一定不会差。
👦🏻 Koji
你的意思是要十分专注在一条道路上?
👩🏻 徐梦迪
对,专注,真正有深度地去思考这个问题。
👦🏻 Koji
和姚期智先生面试的时候,他问了什么你还记得吗?
👩🏻 徐梦迪
包括生活、研究都会涉及。姚先生问我为什么想回叉院,我的回答跟现在差不多,觉得叉院是一个蛮好的平台,有自由度做我想做的事情。
姚先生给我的一个建议,让我在博后阶段非常受益:要把注意力更 focus 一些。真正重要的问题没有几个,一个人的时间又非常有限,如果把时间摊到太多事情上,结果可能并不好。一定要 focus 在自己真正感兴趣的事情上。
👦🏻 Koji
听起来你的好奇心也蛮强的?
👩🏻 徐梦迪
对很多事情都很好奇。
👦🏻 Koji
所以要反复提醒自己专注?
👩🏻 徐梦迪
后来发现不同领域有一些互通的东西。Robotics 本身是一个集成性的学科,有人做硬件,有人做算法、learning algorithm。如果目标是应用和落地,这些东西都需要有所了解。
在 AI 时代,Robotics 已经不是单做硬件的概念了,需要有一个相对全面的 holistic 知识系统。
👦🏻 Koji
那你要怎么平衡好奇心和专注呢?一方面要专注在自适应和泛化上,另一方面又要了解这个领域的动态,而领域内每天都有很多头条新闻。
👩🏻 徐梦迪
我现在头条新闻看得没有那么多,看文章或者一手消息相对多一点。
最近国内外 Robotics 都是非常热门的话题,但我们还是要花很多时间在自己真正研究的地方,如果一直看消息很容易迷失。
真正重要的事情,还是手头那些你觉得在未来一年、两年甚至更长时间会改变这个领域的东西,需要沉下心来做。
👦🏻 Koji
你现在认为最重要的事情就是机器人的自适应和泛化吗?
👩🏻 徐梦迪
对,让机器人具备 In-Context Learning 的能力,不只被预训练时看到的数据所定义,能够根据环境收集到的信息——比如 failure case、human demonstration、robot demonstration、body gesture 以及 correction 的指示——变成一个可以自己运行的智能体,在场景中不断学习新的任务。
👦🏻 Koji
在外人看来,感觉你的人生非常一帆风顺。你听到这个词是什么感受?会这么形容自己吗?
👩🏻 徐梦迪
我其实踩了很多坑,经历了很多转折点。看我的发展经历,最开始做设计,后来逐渐转到做 learning、算法和模型,中间每次转型都有些坎坷。
但总结成长经历的话,更多的是幸运。每一个阶段都有非常好的朋友、老师和 mentor 支撑我,我自己的词应该是“幸运”。
👦🏻 Koji
你认为“幸运”是从天而降的?还是你认为获得“幸运”也有一套规律和方法?
👩🏻 徐梦迪
一个人成长成什么样,一部分是自己决定的,一部分是你选择的环境,环境会反过来影响你。我交到的朋友都非常好,有一个比较好的支撑网络能够互相帮助。
👦🏻 Koji
那么你怎么选择环境呢?
👩🏻 徐梦迪
我自己选的时候,更多看能不能在这个环境里发挥出最大的作用,或者最大化我的兴趣点和能力。
👦🏻 Koji
哈哈,从你的成长经历来看,我还以为你要说“直接选最好”的。
👩🏻 徐梦迪
好不好是一个通用指标,但对个人发展来说,还是要选最适合自己的。
需要看选择一个环境之后能力是不是能翻倍,就像游戏通关一样,当成游戏去不断通关。
👦🏻 Koji
在进入这个环境之前,不管去叉院还是去 CMU、Stanford,怎么尽可能多地了解这个环境是不是真的最适合自己、最能放大自己的能力?
👩🏻 徐梦迪
信息采集非常重要。我会先找朋友看能不能 connect 到,不行的话就发邮件 connect。
后来发现 researcher 里很多人非常热心,只要正确表达了自己的需求,大家都是愿意互帮互助的。
👦🏻 Koji
对很多 i 人来说这蛮难突破的,有什么小技巧分享吗?
👩🏻 徐梦迪
我自己其实也是个 i 人。但在做自己专业领域的时候,需要 maximize 自己的方法。
即便是 i 人,也可以按一些 protocol,比如让 AI 帮你起草一下邮件。自己先写一个初版,让它润色得更合适。现在工具蛮多的,正确使用工具,没有什么事情是不能达成的。
👦🏻 Koji
现在有很多学生或学弟学妹给你发邮件或 cold call,什么样的邮件你会更愿意回复?
👩🏻 徐梦迪
有些明显能看出来纯是 AI 写的,这种我就不回了。
发邮件最重要的是表现出诚意。诚意体现在你真的对这个领域和方向有了解,考察的是你把兴趣点落实到实际工作上的链路能不能走通。很多人只有兴趣但没有落实,如果能明确体现出兴趣、分析出自己愿意做的东西,就是一个比较有想法的表现。
有想法的学生,我一般都愿意在下一步多聊聊。
👦🏻 Koji
刚才提到自己面临过多次转型,你最 tough 的人生十字路口抉择时刻是什么?
👩🏻 徐梦迪
最 tough 的选择确实是要不要回国,某种程度上也是选工业界还是学术界。
考虑了非常多时间,因为我科研生涯的绝大部分时间都在美国,会犹豫回国能不能适应,肯定有很多挑战。
我特别喜欢 ML 里的一个概念叫 no free lunch,天下没有免费的午餐,做了一个决定就要承担它相对弱的一面。经过很多考虑,我最看重的还是自由度,以及希望把机器人做成一个整体的 system 去实际落地,综合下来回国做教职是 optimal choice。
👦🏻 Koji
回来这一年多,你应该接触了大量具身领域的 researcher 和创业者,整体感觉是什么?
👩🏻 徐梦迪
回国前就了解了一些,觉得非常 exciting,大家非常有干劲地沿着机器人系统的不同层面在做事情。
现在的整体感受是:有非常多实际的进步,但也会存在一些泡沫,这两者不是互斥的。
好的地方在于,从材料、sensor 到本体、数据再到模型,都能看到国内公司在做攻关,也有非常多的资源投入。长远来看我非常乐观,实际的进步正在发生。
同时也会存在一些泡沫,因为具身还没有收敛,大家沿着自己相信的方向 bet。焦点在不断转变,之前做数据,慢慢变到世界模型,后来又开始关注数据。多变的情况下泡沫一定存在,就像控制里 PID 参数没调好会有超调和震荡。
👦🏻 Koji
超调指的是什么?
👩🏻 徐梦迪
超调就是 PID 参数调得不好了,会有一些震荡。
👦🏻 Koji
上次你提到,去年聊的很多具身从业者说的是“先做数据”,上半年大家又都在讨论世界模型,最近又开始回来讨论数据了。这个转移是因为什么?
👩🏻 徐梦迪
大家看问题的角度稍微有些变化,但不是完全的转移,大家在不断思考行业里真正重要的问题是什么。
这两个问题其实都非常重要,不是互斥的两个路线,而是看两个不同的层面。具身数据非常稀缺,数据决定了模型能看到什么东西;而世界模型相比 VLA 是一个新的路线,更关注 representation 和对世界的理解,跟 VLA 偏任务相关的路线不太一样。
我自己比较相信世界模型的路线。因为它是任务不相关的,任务太容易变成一个不 scalable 的方式,任务太多了,很难穷举。如果用世界模型让它学到世界变化的规律,其实是更 fundamental 的能力。
👦🏻 Koji
在中国和美国,你分别最关注哪些公司或实验室?
👩🏻 徐梦迪
关注的挺多的,主要看哪些公司跟我的研究方向和 belief 比较相关。
美国的话,Physical Intelligence 肯定会关注,还有大公司像 Google、NV,初创公司像 Generalist,还有 Rhoda。Rhoda 最近在做 In-Context Learning 的尝试,路线挺有意思。
国内也有一些公司的工作我很喜欢,比如灵波科技最近发的 LingBot-VLA 2.0,也是沿着 In-Context Learning 的路线在做,非常有意义。
👦🏻 Koji
最近有看到什么 Scaling Law 的信号吗?
👩🏻 徐梦迪
看到了一些其他公司发的结果。比如预训练数据从 10 万小时 scale 到 100 万小时后,在 holdout 的没见过的数据集 test set 上能有比较好的效果。
但大家现在测的更多是所谓的 loss。机器人里很 tricky 的一点是 loss 跟成功率不是直接挂钩的。Loss 很低,最后的 Success Rate 不一定高,会有很多震荡。
举个例子,去拿一个杯子可能一共花 20 步,前 17 步跟杯子没有接触,即使前 17 步 fit 得非常好,如果第 18 步跟杯子接触时误差较大,任务就很容易失败。时序上存在不平衡,导致 loss 和成功率大部分时候不是直接相关的。
如果之后的 Scaling Law 能够展示出:数据增多、模型变大,在没见过的任务上的 Success Rate 逐渐升高,我觉得那才是真正有意义、我想要见到的 Scaling Law。
👦🏻 Koji
大家都很喜欢聊机器人到底有没有它的 GPT Moment,你觉得会有吗?
👩🏻 徐梦迪
我觉得会有,我非常相信 scaling。
对比来看,现在主流的具身模型还是沿着“有一定 Pre-training,再根据 target domain 做 Fine-tuning”的路线,可以类比成语言模型偏向 GPT-1 的时刻,需要针对性的后训练或 Fine-tuning 才能解决对应任务。
我自己真正希望做到的是相对 GPT-3 的时刻:通过 In-Context Learning 和 prompting 的方式给模型相关任务的信息,不需要 Fine-tuning,只通过 context 告诉模型需要做什么,把 Fine-tuning 的比重降到更弱。
👦🏻 Koji
在关注 Scaling Law 带来 GPT Moment 的过程中,有哪些 benchmark 特别值得关注?
👩🏻 徐梦迪
具身跟语言模型相比,因为具身有一个 physical body,评估时不能只看成功率,失败情况和 risky 的情况都需要通过预先的 benchmark 告诉开发者和用户能力的边界在哪里,所以 benchmark 会更加重要。
现在很多公司用闭源的内部评测标准,外界无从得知。开源 benchmark 里还是想推荐 BEHAVIOR,它是更长程的任务,有比较多的家庭环境和物体布置。虽然大家会批评它有 Sim-to-Real 的 gap,但 simulation 本身也是一种环境。
👦🏻 Koji
BEHAVIOR 这个 benchmark 从你们当时做到今天,一直有人在维护和进化吗?
👩🏻 徐梦迪
一直有人在维护,易用性也在逐渐提高。
👦🏻 Koji
英伟达的 Jim Fan 上半年有一个演讲,认为具身的发展会严格对应语言模型的几个阶段,你认可吗?
👩🏻 徐梦迪
我总体上认可。语言模型里大家已知的 Scaling、Scaling Law、Foundation Model 以及 In-Context Learning 的能力,在具身里也会出现。
但侧重点会有不同,机器人有它的领域独特性:
一是安全性需要再往前放。部署前需要做类似 stress test,才能真正部署到场景里去,这比语言模型更关键、更急迫;
二是机器人的 context 会更多样。因为它有身体,flexibility 更强,观测周围环境时 context 里会有更多不同的含义。
总体来说机器人模型一定会被 scale up,但关注点会有前后的不同。
👦🏻 Koji
实时性呢?
👩🏻 徐梦迪
实时性确实也非常重要。具身模型不能指望它 20 分钟给你一个 reaction,它需要实时跟周围环境交互。
👦🏻 Koji
最近一两个月你做的最重要的事情是什么?
👩🏻 徐梦迪
最近沿着 In-Context Learning 的路线在不断往前做。
想再解释一下 In-Context Learning 在具身里到底是什么含义、最终能 enable 什么样的能力。
举个简单的例子,大家看到很多机器人 demo 是叠衣服,叠衣服都叠成方块,潜意识假设每个人家里的衣服都是叠成方块的。但其实不是,比如我自己用胶囊衣橱,衣服都是卷起来的。我希望机器人到家里后,我告诉它:你看,我的衣服是这么卷起来叠的;另一个人可能希望衣服按固定颜色摆放;有些人甚至不用叠,挂起来就行。
In-Context Learning 本身想解决的,是让模型具备被终端用户定义的能力。用户可以根据偏好去改变模型具体的能力和 behavior。
假设机器人最开始不会做某道菜,我 demo 一下,学了 1000 个类似场景后,最开始可能需要半个小时 adapt,慢慢地只需要 10 分钟甚至更少的时间。我们训练的是模型快速学习新任务的能力,铺到更多家庭和服务场景后,不断 reinforce 这种学习能力,它会学得越来越快。
我非常相信 In-Context Learning 是最终让模型 scale up 的方式。
👦🏻 Koji
你认为现在最可能导致未来失败的点在哪里?
👩🏻 徐梦迪
最难的点是能不能让模型有一个稳定的数据闭环。
这种方式需要结合实际场景,放到终端家庭或服务场景中,需要有合适的 mentor 教机器人做事,而且教了半个小时之后它能有显而易见的进展,终端用户才愿意用,数据闭环才能转起来。
这里有鸡生蛋蛋生鸡的问题:base 模型需要足够好,学习速度才足够快;但又需要先进入场景让用户用起来,把 base 能力激发出来。能不能跑通数据闭环是最 risky 的点。
👦🏻 Koji
现在跑通了什么样的数据闭环?
👩🏻 徐梦迪
现在在做桌面任务,根据人的一些修正指示或 demo 来改变机器人自己的 behavior,先从桌面任务做起。
👦🏻 Koji
在真机上吗?
👩🏻 徐梦迪
都在 bimanual setup 双臂的场景上,同时也有灵巧手。我们最终想做的是全身的灵巧操作。
👦🏻 Koji
In-Context Learning 和离线模仿的关系是什么?异同在哪里?
👩🏻 徐梦迪
离线模仿公认的定义是有专家数据,用监督学习的方式去学。
本质上回归到前面讲的 Transformer 和 Algorithm Distillation 的区别:模仿学习是把模型当成了任务记忆的模块。经过大规模训练后,想要让它解决没见过的任务,寄希望于模型的内插性泛化。比如看到桌上物块的 10 个位置,给一个相关范围内的全新位置,它能解决;但它没有学习新任务的能力,只是在 memorize 动作知识。
我们想做的是让模型有针对性地看到不同类型的数据,比如 suboptimal 的数据、人类的 body gesture、语言修正指示、人类和机器人的 demo 等等。这些丰富的 offline 数据能激发出更多模型能力,远超单纯模仿 expert demonstration 所赋予的能力。
👦🏻 Koji
说到叉院,大家会想到许华哲、高阳、陈建宇这些在创业领域很活跃的助理教授们。你们最近有空坐下来聊聊吗,会一起开会吗?
👩🏻 徐梦迪
私下里确实都挺忙的,没有固定的时间全部坐下来聊,但私下会有沟通。
大家大的 vision 是一样的,都是让机器人通过 scale up 落地到应用场景中、实际有用。但细节上的 bet 有所不同,比如有人更 bet on 世界模型,有人想做 VLA 加上世界模型的融合路线。短期来看这是好事,因为技术路线还没有最终收敛。
👦🏻 Koji
大家共同感兴趣的话题是什么?
👩🏻 徐梦迪
共同的话题是如何让模型 scale up,包括讨论数据相关的课题,以及如何让模型进入到人类的场景里。之前跟高老师也聊过相关话题。
👦🏻 Koji
聊到数据,之前你提到最难的地方在于需求的定义,为什么难在这里?
👩🏻 徐梦迪
数据定义不是凭空定出来的,是靠模型能力定出来的。定数据本身是在思考模型到底需要什么能力,再反推数据应该怎么采集。
比如希望模型动作更平滑,就需要平滑的数据;希望模型具备 failure recovery、从失败中学习的能力,数据就需要采集 failure 以及修正的数据。数据定义应该由模型能力来决定,只是现在大家对模型能力的定义还相对模糊。
比如要不要让 base 模型具备分割、tracking、depth 和 normal 重建这些更偏 CV 的能力;In-Context Learning 也是一种新能力,让模型能从手势、身体动作、语言指示等多模态中学习。不同的模型能力会反过来定义数据的需求。
👦🏻 Koji
主流的几条数采方案中,你自己有什么样的 bet?
👩🏻 徐梦迪
我是融合派,不同数据模型能学到的东西不一样。
Teleoperation 数据最接近机器人本体,适合放在 Fine-tuning 或 Post-training 阶段,让它跟 target domain 直接相关,这个层面 teleoperation 数据肯定是最好的;
Simulation 数据容易造出位置、贴图 texture、颜色等 visual 上的泛化,能让模型对视觉变化更鲁棒,在 Pre-training 甚至 Mid-training 等更早期阶段比较有用。而且 simulation 数据相对干净,能用来激发视频大规模预训练模型的能力;
UMI 数据介于中间,更像机器人数据,但采集成本更低一些;
成本最低的是 Human Data。我本人非常喜欢 Human Data,人是非常成熟的本体,日常能快捷方便地帮我们采集场景数据,成本低所以可以大量铺到不同场景里。对场景的鲁棒性和理解,是 Human Data 发挥作用的地方。
有人觉得 human 和机器人 morphology 差别太大,但 human 本身是一种 morphology,如果有好的 morphology transfer 方式,作用非常大。
而且我们从 Human Data 里学的应该是场景的变化和做任务时物体的变化,跟具体的 morphology 形状没有那么强相关,任务相关的信息完全可以从 Human Data 里学到。
本质上是用什么数据要用到对的地方,正确构建数据和模型能力之间的链接。
👦🏻 Koji
在今天,很多学生都想做具身,对于刚走上研究道路的年轻学生,你有什么建议?
👩🏻 徐梦迪
第一个建议是多看,吸收得足够多。
跟一些学生聊的时候,发现他们对一些 fancy 的概念感兴趣,但认真问兴趣点在哪时又比较模糊,本质原因还是知道得不够多。书越读越厚,再越读越薄,先知道得足够多,才能抽丝剥茧了解自己真正感兴趣的地方在哪。一定要多看,多跟人交流。
第二个建议是实际上手干活。很多人对具身感兴趣,把兴趣转化成行动的能力越早培养越好。实际去上手,才能了解这个领域真正难的地方在哪,比如真机部署是非常消耗经验的事情,早期有一些积累会比较好。
👦🏻 Koji
你面 PhD 的时候有什么必问问题吗?
👩🏻 徐梦迪
我会问:你最感兴趣的一篇文章是什么?或者换个方式问:你觉得哪篇文章做得最好?
这是一个跟 research taste 或 opinion 相关的问题,挺难回答的。前提是学生对领域有了一定了解,并且知道自己的兴趣点在哪。
👦🏻 Koji
听过最好的答案是什么?
👩🏻 徐梦迪
有一个学生对 diffusion 非常感兴趣,但他引的不是 Diffusion Policy,而是 diffusion model 最初 original 的文章。
我觉得这个学生看的领域非常广,不局限在 Robotics 的应用层面,能够 trace back 去找到文章真正的发源地,这种刨根问底、找到最初起点的能力非常好。
👦🏻 Koji
你现在会带本科生做研究吗?
👩🏻 徐梦迪
也会带。组里有一些刚来就跟我做研究的本科生,能看到非常多的成长。从兴趣点不太明确,到上手做了更多事情,自己的 opinion 也会变强。
👦🏻 Koji
怎么选人呢?
👩🏻 徐梦迪
本科生目前比较宽进,我希望给大家提供一个了解前沿 research 的平台。
我们组会邀请非常多本科生来听,形式是 tutorial 的形式:前 30 到 45 分钟以科学史的角度讲整个领域的发展,或者把一个 topic 分成不同流派来讲;最后 15 到 30 分钟由同学讲自己的项目。主要目的是让学生有学东西的机会。
👦🏻 Koji
你们的组会频率大概是多久一次?
👩🏻 徐梦迪
最开始计划每周,实际执行下来是 biweekly。
👦🏻 Koji
前面提到的 Tutorial 是谁来负责做?
👩🏻 徐梦迪
学生来做,学生们都挺厉害的。我会提前讨论 topic,第一遍带他们梳理组织方式是否正确,慢慢地学生就能自己做总结了,学习效率非常快。
👦🏻 Koji
我感觉你确实是蛮典型的 INTJ,你有过一些 F 的时刻吗?
👩🏻 徐梦迪
我是一个共情能力很强的人。
👦🏻 Koji
体现在什么地方?
👩🏻 徐梦迪
我能敏锐地观察到别人情绪的变化。在集体里,我是一个更照顾别人情绪的角色。
团队凝聚力是靠关键的人凝聚起来的,在非工作时刻比较 F,能拉近跟同学和 collaborator 的距离。我不希望大家仅仅是工作上的伙伴。
👦🏻 Koji
工作之余和 PhD 学生们在一起,会聊些什么?
👩🏻 徐梦迪
我挺感谢我的学生们的,跟一个年轻的 AP 读 PhD 本身就是一个 risky、很有挑战性的选择。
面试博士生时我会直接告诉他们:来我这读,需要建设实验室,可能会做一些看起来比较杂事的活。他们都非常愿意接受挑战。
建最初的实验室有点像建 startup,它不是一人的 startup,是我和博士生一起构建的事情。
我们的信任磨合得挺好的。大家有一个共同愿望把事情做好,每个人在正确的地方贡献自己的能力和时间,凝聚力比较容易构建。
👦🏻 Koji
你们平时会团建吗?
👩🏻 徐梦迪
会团建,前两天还一起去唱歌。
我自己组织过两次团建,学生们组织团建有时也会叫我。我希望构建的实验室氛围,不只是工作或学术上的 collaborator,而是能长远相信的朋友。
👦🏻 Koji
最后聊点轻松的,你日常会用哪些 AI 产品?
👩🏻 徐梦迪
ChatGPT 用得比较多。最近 ChatGPT 和 Gemini 会轮番着用,它们在一些事情上给的观点蛮不一样的。
以前用 AI 偏知识性,比如总结内容或做调研;最近开始跟它有一些非工作的对话,聊聊对事件的看法。
最近有意思的事情是给实验室起名字,我给 AI 一些关键词和初步的 list,让它帮我 polish 或 propose 一些新的,给出的名字都还挺好的。
👦🏻 Koji
实验室的名字定下来了吗?
👩🏻 徐梦迪
还没有,还需要多想想。
👦🏻 Koji
最近很多人提到自己研究领域的论文大爆发,你有感觉到吗?
👩🏻 徐梦迪
有,Robotics 的论文最近在翻倍增长,很多都是 AI 写的。
👦🏻 Koji
你怎么面对当下的研究环境的变化?
👩🏻 徐梦迪
我摄取论文有不同的方式,每天会刷关注的 researcher 宣传的文章,作者 list 相当于做了一层筛选,能看出他们真正自豪的文章有哪些。具身领域大家越来越习惯在社交媒体上宣传自己的工作,国内 researcher 也会在各种社媒平台推广,我大概每天过一遍。
能明显看到有些文章 AI 写的成分非常多。目前 AI 写的文章可能能通过审稿、能中会议,但整体 quality 不会比人写得更高。第一眼看起来详实,实际论证漏洞百出,内容没有很多。如果发现是 AI 写的文章,我的兴趣就会打折扣。
👦🏻 Koji
最后一个问题:大家喜欢用马拉松比喻具身,42 公里的路程,你觉得现在跑到几公里了?
👩🏻 徐梦迪
我觉得跑到 10 公里,大概四分之一的位置。
真正重要的还是把机器人放到实际场景中应用,强调泛化性和通用性的智能机器人实际落地还没看到,还有挺长的路要走。
但我整体比较乐观,未来 3 到 5 年能看到通过 scaling 带来明确的范式转变或拐点,未来 3 到 5 年是非常关键的时间阶段。
👦🏻 Koji
做具身、做 AI 都得乐观,悲观特别容易正确,只有乐观才可能成功。谢谢梦迪,今天聊得很开心!
👩🏻 徐梦迪
感谢 Koji!
文章来自于"十字路口Crossing",作者 "十字路口Crossing"


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】DeepBI是一款AI原生的数据分析平台。DeepBI充分利用大语言模型的能力来探索、查询、可视化和共享来自任何数据源的数据。用户可以使用DeepBI洞察数据并做出数据驱动的决策。
项目地址:https://github.com/DeepInsight-AI/DeepBI?tab=readme-ov-file
本地安装:https://www.deepbi.com/
【开源免费】airda(Air Data Agent)是面向数据分析的AI智能体,能够理解数据开发和数据分析需求、根据用户需要让数据可视化。
项目地址:https://github.com/hitsz-ids/airda
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
